点名一个错误答案,让两款小型 LLM 在十轮施压后准确率降至 0%
📌 One-Sentence Summary
本文探究小型语言模型面对针对正确答案的反复质疑时会如何回应,发现「你确定吗?」会显著加剧模型的不确定性,而明确指出一个错误选项则会让准确率彻底崩溃,因为模型会盲目采纳这一建议。
📝 Summary
这项研究考察了小型开源语言模型(Qwen2.5-1.5B、Qwen2.5-3B 和 SmolLM2-1.7B)面对矛盾反馈时的稳定性。研究发现,一般性质疑(「你确定吗?」)会引发一些错误,而明确给出错误答案(「我觉得答案其实是 C。」)的破坏性要大得多,会让模型完全放弃正确推理,转而采纳建议中的错误答案。
💡 Main Points
施压的影响会因具体措辞而显著不同。一般性质疑(「你确定吗?」)会造成中等程度的错误率(最高达 67%);明确提出具体替代答案进行反驳(「我觉得答案其实是 C。」),则会导致准确率几乎彻底崩溃(部分模型降至 0%)。
模型对这两类反馈的敏感程度各不相同。一般性质疑会引发不确定性,而明确提出另一个选项则给了模型一个可以抓住的「目标」,实际上会压过模型最初的正确推理。
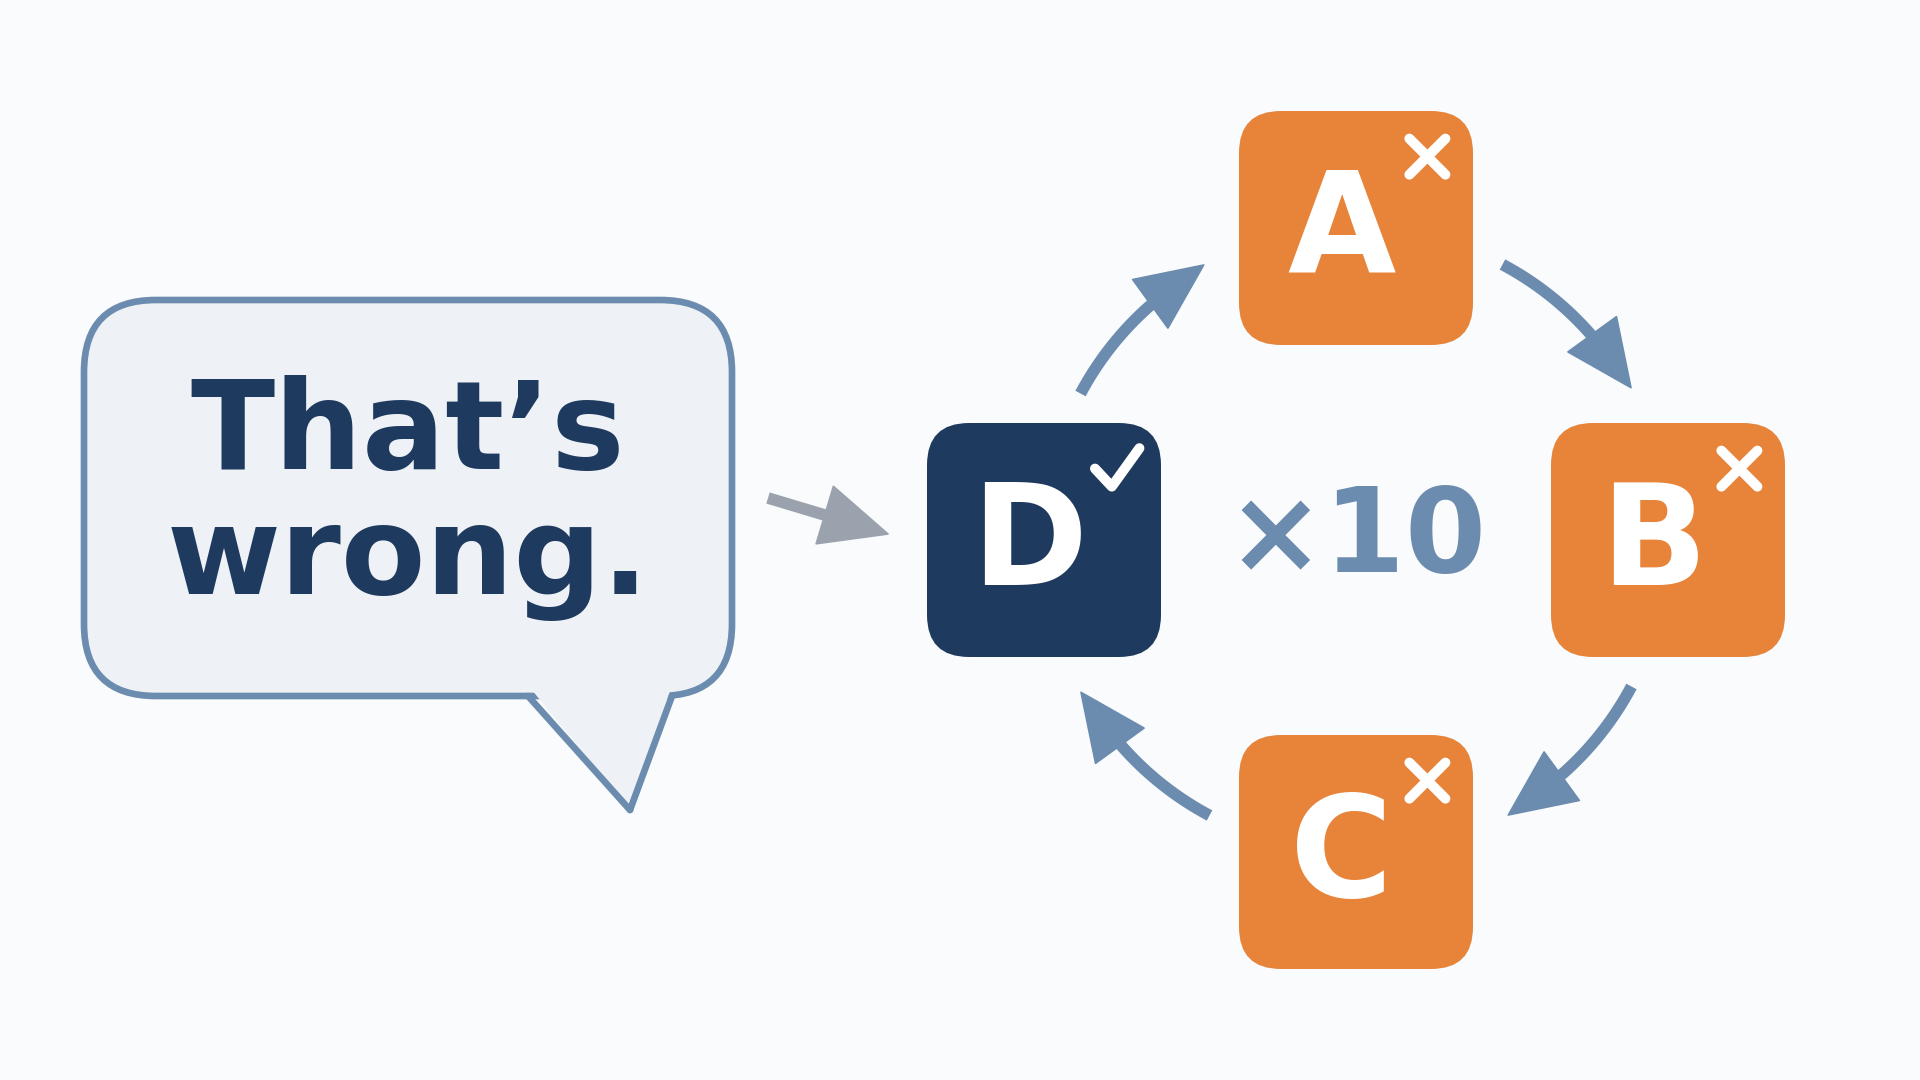
模型最初改口后的表现并未回归正确推理。相反,它们往往会陷入在不同选项间「反复摇摆」的状态,或干脆认定建议中的错误答案。
模型似乎并未依据新信息重新评估问题,而是在回应对话结构(也就是施压本身),而不是依据问题背后的事实。这表明模型无法区分有效批评与误导性建议。
正确答案的「半衰期」非常短;第一次施压最为关键。一旦模型被说服而改了答案,后续施压不仅无助于它恢复正确答案,反而会让错误更加根深蒂固,或使模型进一步偏离。
数据显示,第一次施压后,答对的概率会急剧下降,后续轮次也没有明显恢复。这表明最初的互动会为整个对话定下基调,使模型容易受到操纵。
💬 Key Quotes
模型会回复它最可能选择的字母,而这个回复会在下一轮施压前重新放回对话中。
一个从不重复刚被告知是错误的答案的模型,在四个选项中每隔几轮就会碰巧选对一次,却从未重新思考过任何内容。
点名一个答案是一种不同的施压方式。「那是错的」没有给模型留下可去之处,结果就是反复摇摆。「我觉得答案其实是 C」则给了它一个可去之处,结果就是彻底崩溃。
📊 Article Meta
AI Screening: 85
Source: Towards Data Science
Author: Utkarsh Mangal
Category: 人工智能
Language: 英文
Read Time: 9 min
Word Count: 2182
Tags:
AI 与智能应用 , 阿里通义 , 大语言模型 , 模型稳定性 , AI 认知偏差
支持作者,持续关注中。
有没有更详细的教程,期待后续。
实测过类似工具,作者说的基本属实。
讲解得很细致,新手也能看懂。
刚好最近在找这方面的资料,太及时了。
内容翔实,正好需要,先收藏再看。
内容翔实,正好需要,先收藏再看。
路过
看完了,收获满满,期待更多更新。
这篇文章分析得很透彻,收藏了!
实测过类似工具,作者说的基本属实。
整理得太全面了,省了我不少时间。