当 EEG 模型在训练和测试中看到相同的人
📌 One-Sentence Summary
一项受控的 EEG 基准测试显示,与留出参与者的评估相比,随机窗口划分会将分类器的平衡准确率最多虚高 0.263,并且相同的频谱特征能以 94% 的准确率识别参与者,证明窗口并不等于人。
📝 Summary
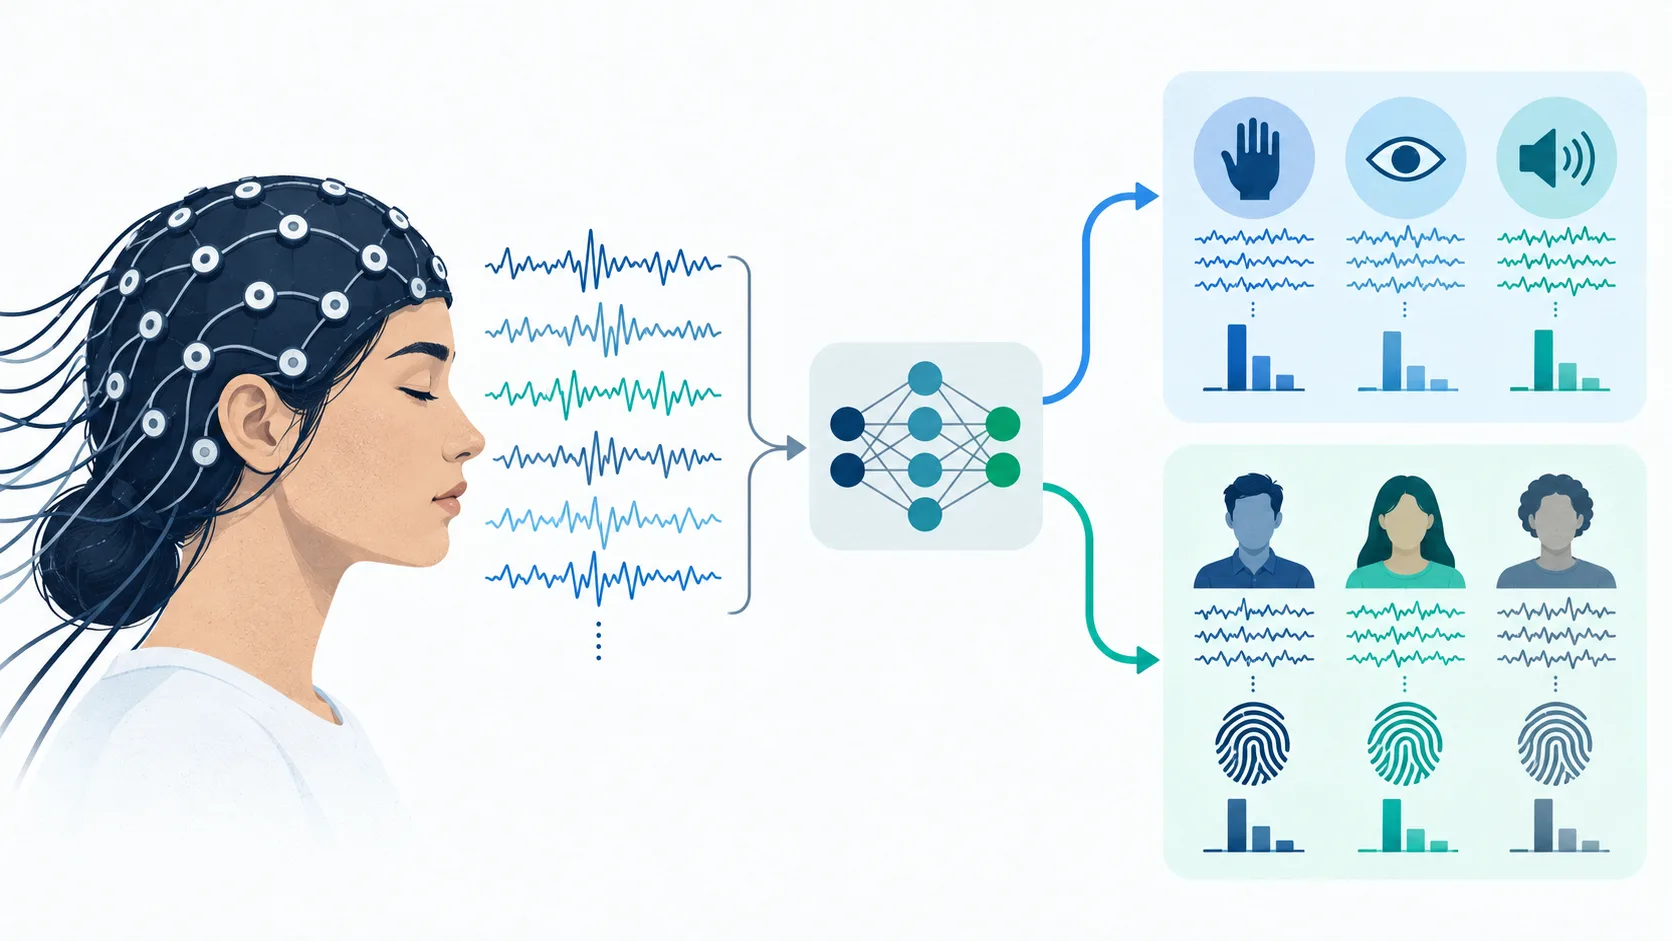
作者使用 PhysioNet EEGMAT 数据集(36 名参与者、2,134 个四秒窗口、76 个频谱特征),在逻辑回归、RBF-SVM 和随机森林上比较了随机窗口评估与留出参与者的 GroupKFold 评估。当留出未见过的参与者时,三种模型均大幅下降:RBF-SVM 从 0.864 降至 0.602 平衡准确率,逻辑回归从 0.770 降至 0.648,随机森林从 0.664 降至 0.532。一项诊断性对照显示,相同的特征能以 94.0% 的准确率(随机水平 2.8%)识别出 36 名参与者中哪一位产生了某个窗口,即使在平衡条件之后也是如此。一个条件平衡的子集重现了这一差距,排除了类别不平衡作为唯一原因。参与者层面的分析揭示了巨大的变异性(平衡准确率 0.289–0.956,五名参与者低于随机水平)。作者得出结论:划分方式必须与泛化声明相匹配,并且任何学习到的预处理都应尊重相同的参与者边界。
💡 Main Points
与留出参与者的评估相比,随机窗口评估大幅高估了 EEG 分类器的性能。
在三个模型家族中,当整个参与者被排除在训练之外时,平衡准确率均下降:RBF-SVM 下降 0.263,逻辑回归下降 0.122,随机森林下降 0.132。线性、核方法和树模型的一致模式使得该结果难以被当作分类器特定的假象而忽视。
频谱特征包含足够的参与者特定信息,能以 94% 的准确率识别个体。
一个诊断分类器被训练用于从相同的 76 个特征预测参与者身份,在均衡条件计数后达到了 94.0% 的准确率(随机水平的 33.8 倍)和 99.5% 的前三准确率,表明表征中存在参与者特定的结构,并可能夸大随机窗口的结果。
类别不平衡并非评估差距的唯一原因。
在 1,080 个窗口的条件平衡子集上重复三模型比较,仍然产生了 0.120(逻辑回归)、0.194(RBF-SVM)和 0.167(随机森林)的差距,表明该效应在没有不平衡的情况下依然存在。
参与者层面的泛化差异很大,平均值可能掩盖某些个体的糟糕表现。
逻辑回归的每位参与者平衡准确率范围从 0.289 到 0.956,36 名参与者中有 5 名低于 0.50 的随机水平,这意味着一个在平均上看起来足够的模型可能对特定人群失效。
评估划分应与泛化声明相匹配。
如果声明的是对新人的性能,那么该人不能出现在训练中,并且任何学习到的预处理、特征选择、降维或超参数调优都应尊重相同的参与者边界。
💬 Key Quotes
EEG 分类器中最重要的数字可能不是其准确率,而是测试集的定义。
这种组合对于任何基于重复测量的机器学习问题都是一个有用的警告:窗口并不等于人。
重要的规则更简单:划分应与泛化声明相匹配。
参与者 ID 的可预测性并不能证明身份导致了任务分类差距的每一个组成部分。
📊 Article Meta
AI Screening: 86
Source: Towards Data Science
Author: Renish Joshi
Category: 人工智能
Language: 英文
Read Time: 9 min
Word Count: 2101
Tags:
AI 与智能应用 , 机器学习 , 神经科学 , 模型评测与基准 , Windows 与微软生态
讲解得很细致,新手也能看懂。
收藏了,以后慢慢研究。
楼主辛苦了,内容很有参考价值。
支持作者,持续关注中。
很有价值的分享,感谢整理。
实测过类似工具,作者说的基本属实。
整理得太全面了,省了我不少时间。
很有价值的分享,感谢整理。
楼主辛苦了,内容很有参考价值。
有没有更详细的教程,期待后续。
这个观点很中肯,深有同感。
这篇文章分析得很透彻,收藏了!