从 Token 到字节 I:扩展分层网络 | Cartesia
📌 One-Sentence Summary
本文介绍分层网络(H-Nets)作为一种从原始数据中学习的基础架构,通过可学习的 token 化和递归抽象,在计算效率上显著优于基于 token 化的语言模型。
📝 Summary
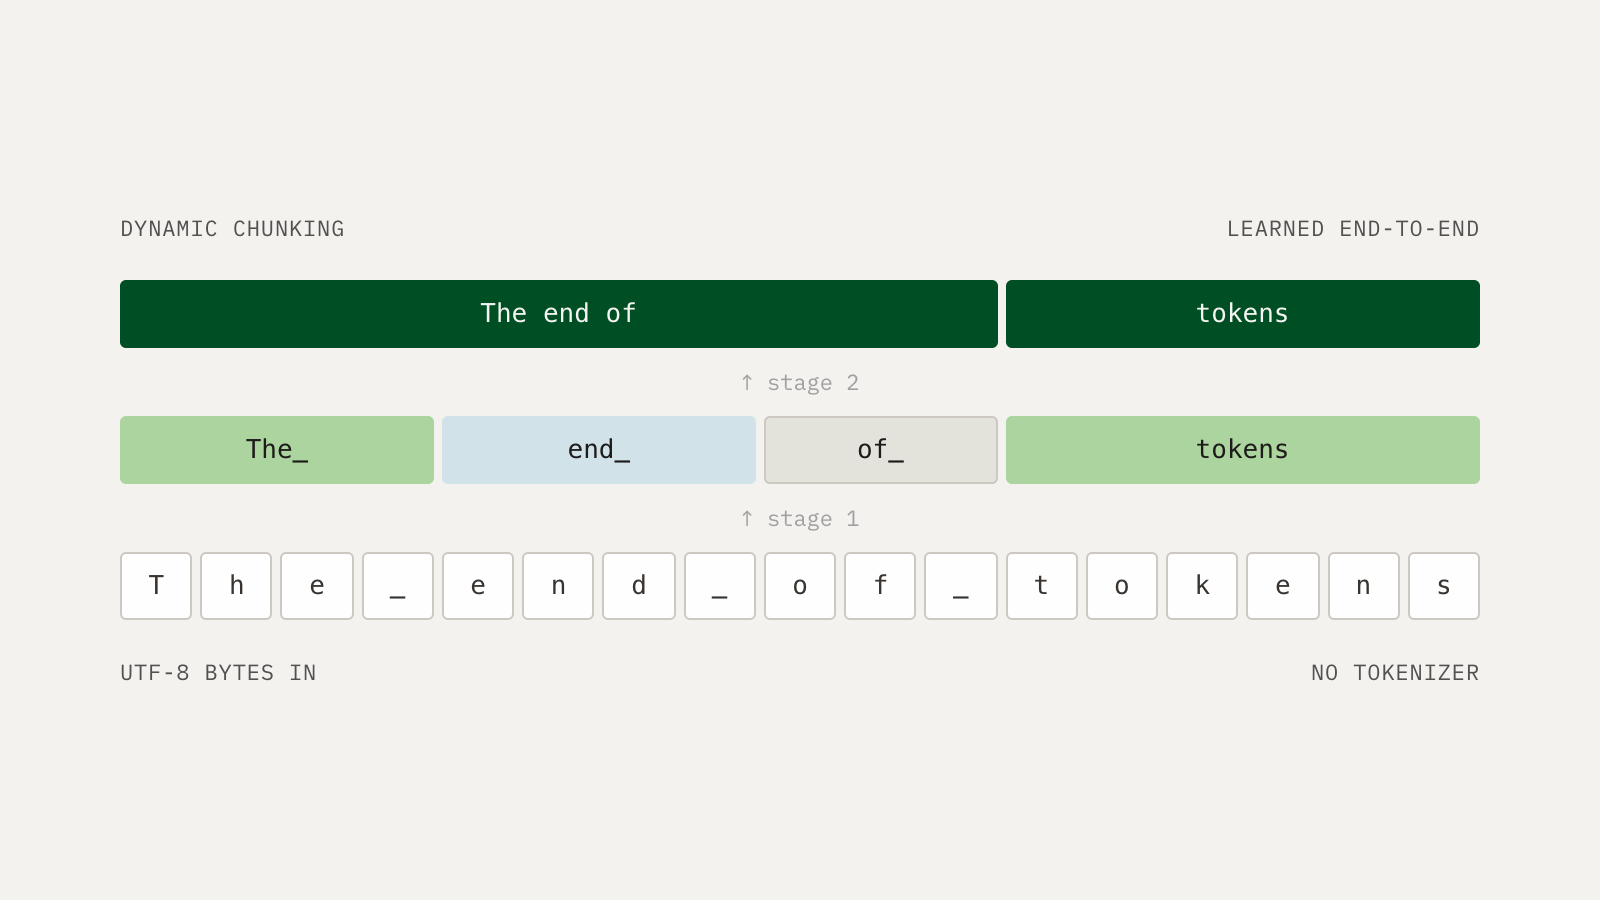
文章探讨了分层网络(H-Nets)的概念及其在扩展语言模型中的应用。文章首先讨论了「苦涩的教训」这一理念以及当前 token 化方法的局限性。作者展示了实验结果,表明 H-Nets 通过动态、端到端的分块方式,在计算效率和下游任务表现上均优于标准的基于 BPE 的 Transformer。文章还展望了 H-Nets 在生物学和视觉领域的未来应用,强调其作为通用学习架构的潜力。
💡 Main Points
H-Nets 相比基于 token 化的语言模型在计算效率上带来了显著提升。
通过用动态、可学习的分块方式替代静态的 BPE token 化,H-Nets 在验证损失上实现了最高 3-5 倍的计算效率提升,并在代码和数学等下游任务上显著改善了表现。
该架构支持递归抽象和多模态学习。
H-Nets 可以嵌套以建模多个层级的数据抽象(例如从字符到词再到短语)。这种灵活性使其能够应用于多种数据类型,包括生物学和视觉领域的连续数据,而标准 token 化在这些场景下并不适用。
研究结果验证了 AI 开发中「苦涩的教训」这一路径。
H-Nets 的成功证实了直接从原始数据(字节)学习、无需大量人工设计先验,是构建智能系统的一种可行且高效的策略,这与「苦涩的教训」的原则相一致。
💬 Key Quotes
我们认为,开发字节级语言模型对 AI 的进步至关重要——不仅是为了改进独立的 LLM,更是作为检验通用学习方法的一块试金石。
H-Nets 是一种真正契合「苦涩的教训」的基础架构,它直接从原始数据中学习意义,并显著提升了效率和可扩展性。
H-Net 的计算效率比 BPE Transformer 高 1.28 倍。这一差距在下游评估套件上进一步扩大,H-Net 在 Paloma 上的效率高出 1.83 倍,在 OLMES 上高出 2.06 倍。
📊 Article Meta
AI Screening: 90
Featured: Yes
Source: Hacker News: Front Page
Author: guybedo
Category: 人工智能
Language: 英文
Read Time: 30 min
Word Count: 7254
Tags:
AI 与智能应用 , 机器学习 , Scaling Laws , 视觉语言模型 , 哲学与思想
实话,说的不明不白
整理得太全面了,省了我不少时间。
收藏了,以后慢慢研究。
路过
这篇文章分析得很透彻,收藏了!
刚好最近在找这方面的资料,太及时了。
作者写得真不错,学到了不少。
讲解得很细致,新手也能看懂。
整理得太全面了,省了我不少时间。
讲解得很细致,新手也能看懂。
内容翔实,正好需要,先收藏再看。
讲解得很细致,新手也能看懂。