Cloudflare BotBase 上线机器人运营后台:AI 爬虫声明行为、内容用途与身份验证的完整流程
一句话结论
Cloudflare 把 BotBase 从”站点主单方面查询机器人目录”升级为”机器人运营方也能参与的双向后台”。新的运营方视图提供统一提交入口、提交状态追踪、被拒原因展示与可编辑重提,并配套”做什么—怎么用内容—谁在运营”的三元声明模型和自动化验证审核。对运营 AI 爬虫、数据采集智能体或 AI 助手产品的团队,这是一套把自动化工具身份验明正身、提高被目标站点放行概率的标准化操作流程。
背景:机器人生态需要双向参与
上个月的第二个”内容独立日”上,Cloudflare 发布了两个面向站点主的能力:BotBase 在控制台里提供已知机器人的可搜索目录,Business Insights 帮站点主理解爬虫如何与内容互动。机器人生态庞大,站点主需要可持续地管理自动化流量。
但这个生态是双向的。站点主要决定允许哪些自动化流量,机器人运营方也需要一个清晰的方式表明身份、说明自己的机器人做什么,并让这些信息保持最新。BotBase 只有在双方都能参与时才能发挥最大价值。
Cloudflare 承诺过要为机器人运营方建工具。在此之前,运营方的体验基本止步于”提交”这个动作:按下提交按钮后,既无法方便地查询审核状态,也难以理解被拒原因,更没有渠道更新已有条目。这次发布的 BotBase for Operators,先解决运营方最迫切的问题:透明度。
提交入口:从孤立表单到专属后台
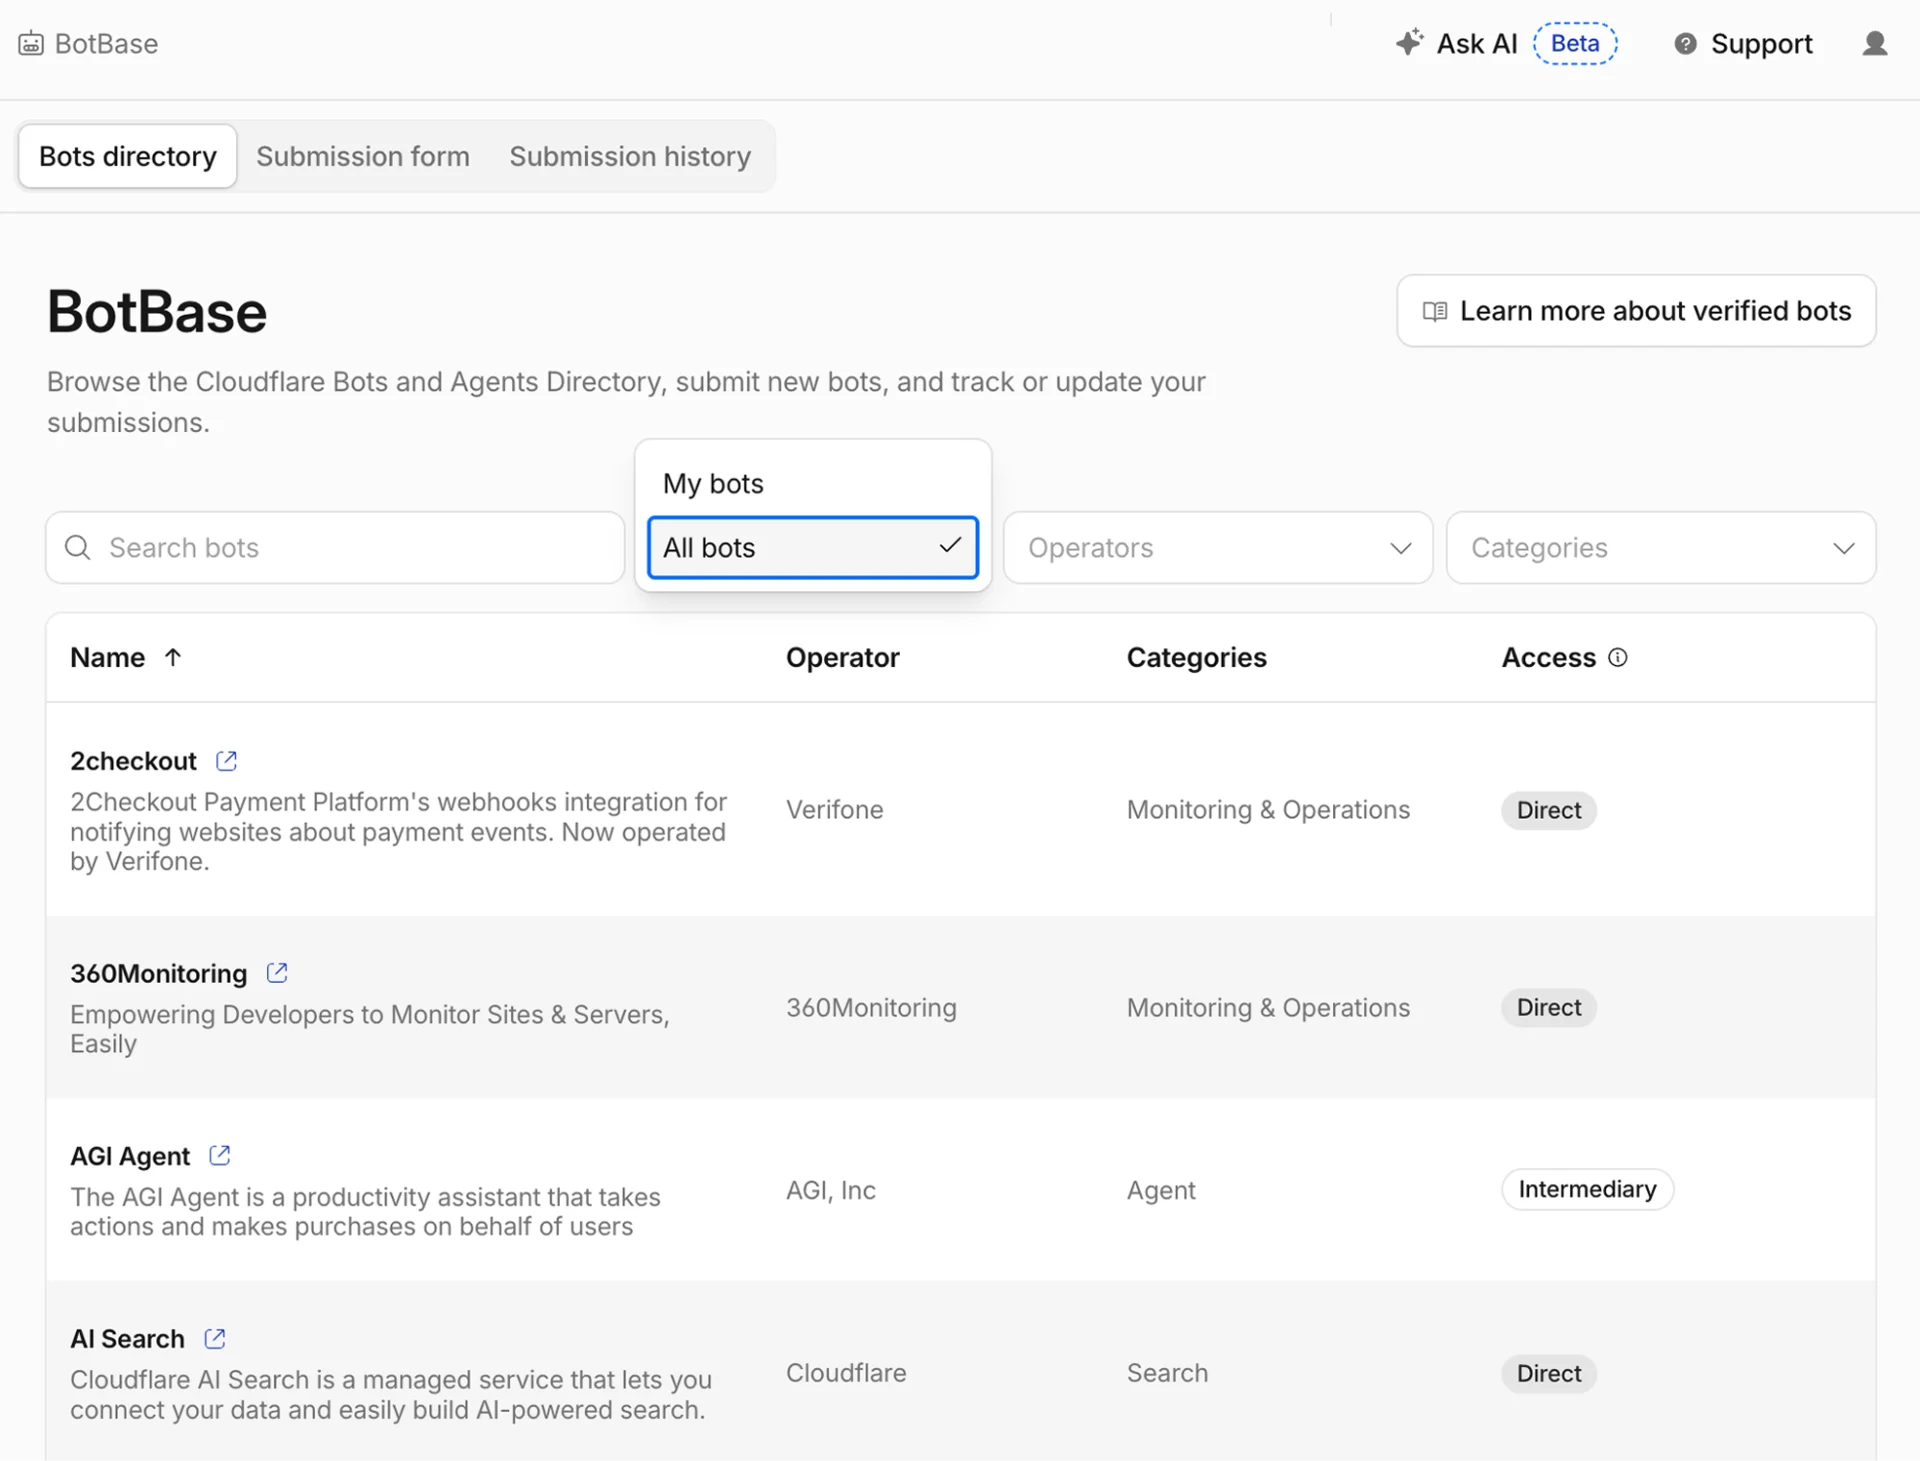
此前机器人提交表单藏在账户管理配置页里,虽然与账户绑定清晰,但和机器人生态没有任何关联。现在提交体验迁移到了与其他机器人及信任类工具并列的位置:保护与连接 → 应用安全 → BotBase,所有客户都可以直接从 Cloudflare 控制台进入。
新后台按用途拆成三块:机器人目录(浏览、搜索、筛选 Cloudflare 已跟踪的机器人,与 Cloudflare Radar 上的公开目录同源)、提交表单(提交新机器人)、提交历史(追踪已提交的所有记录)。入口问题解决后,剩下的是运营方最关心的”提交之后会发生什么”。
状态透明化:提交不再是黑盒
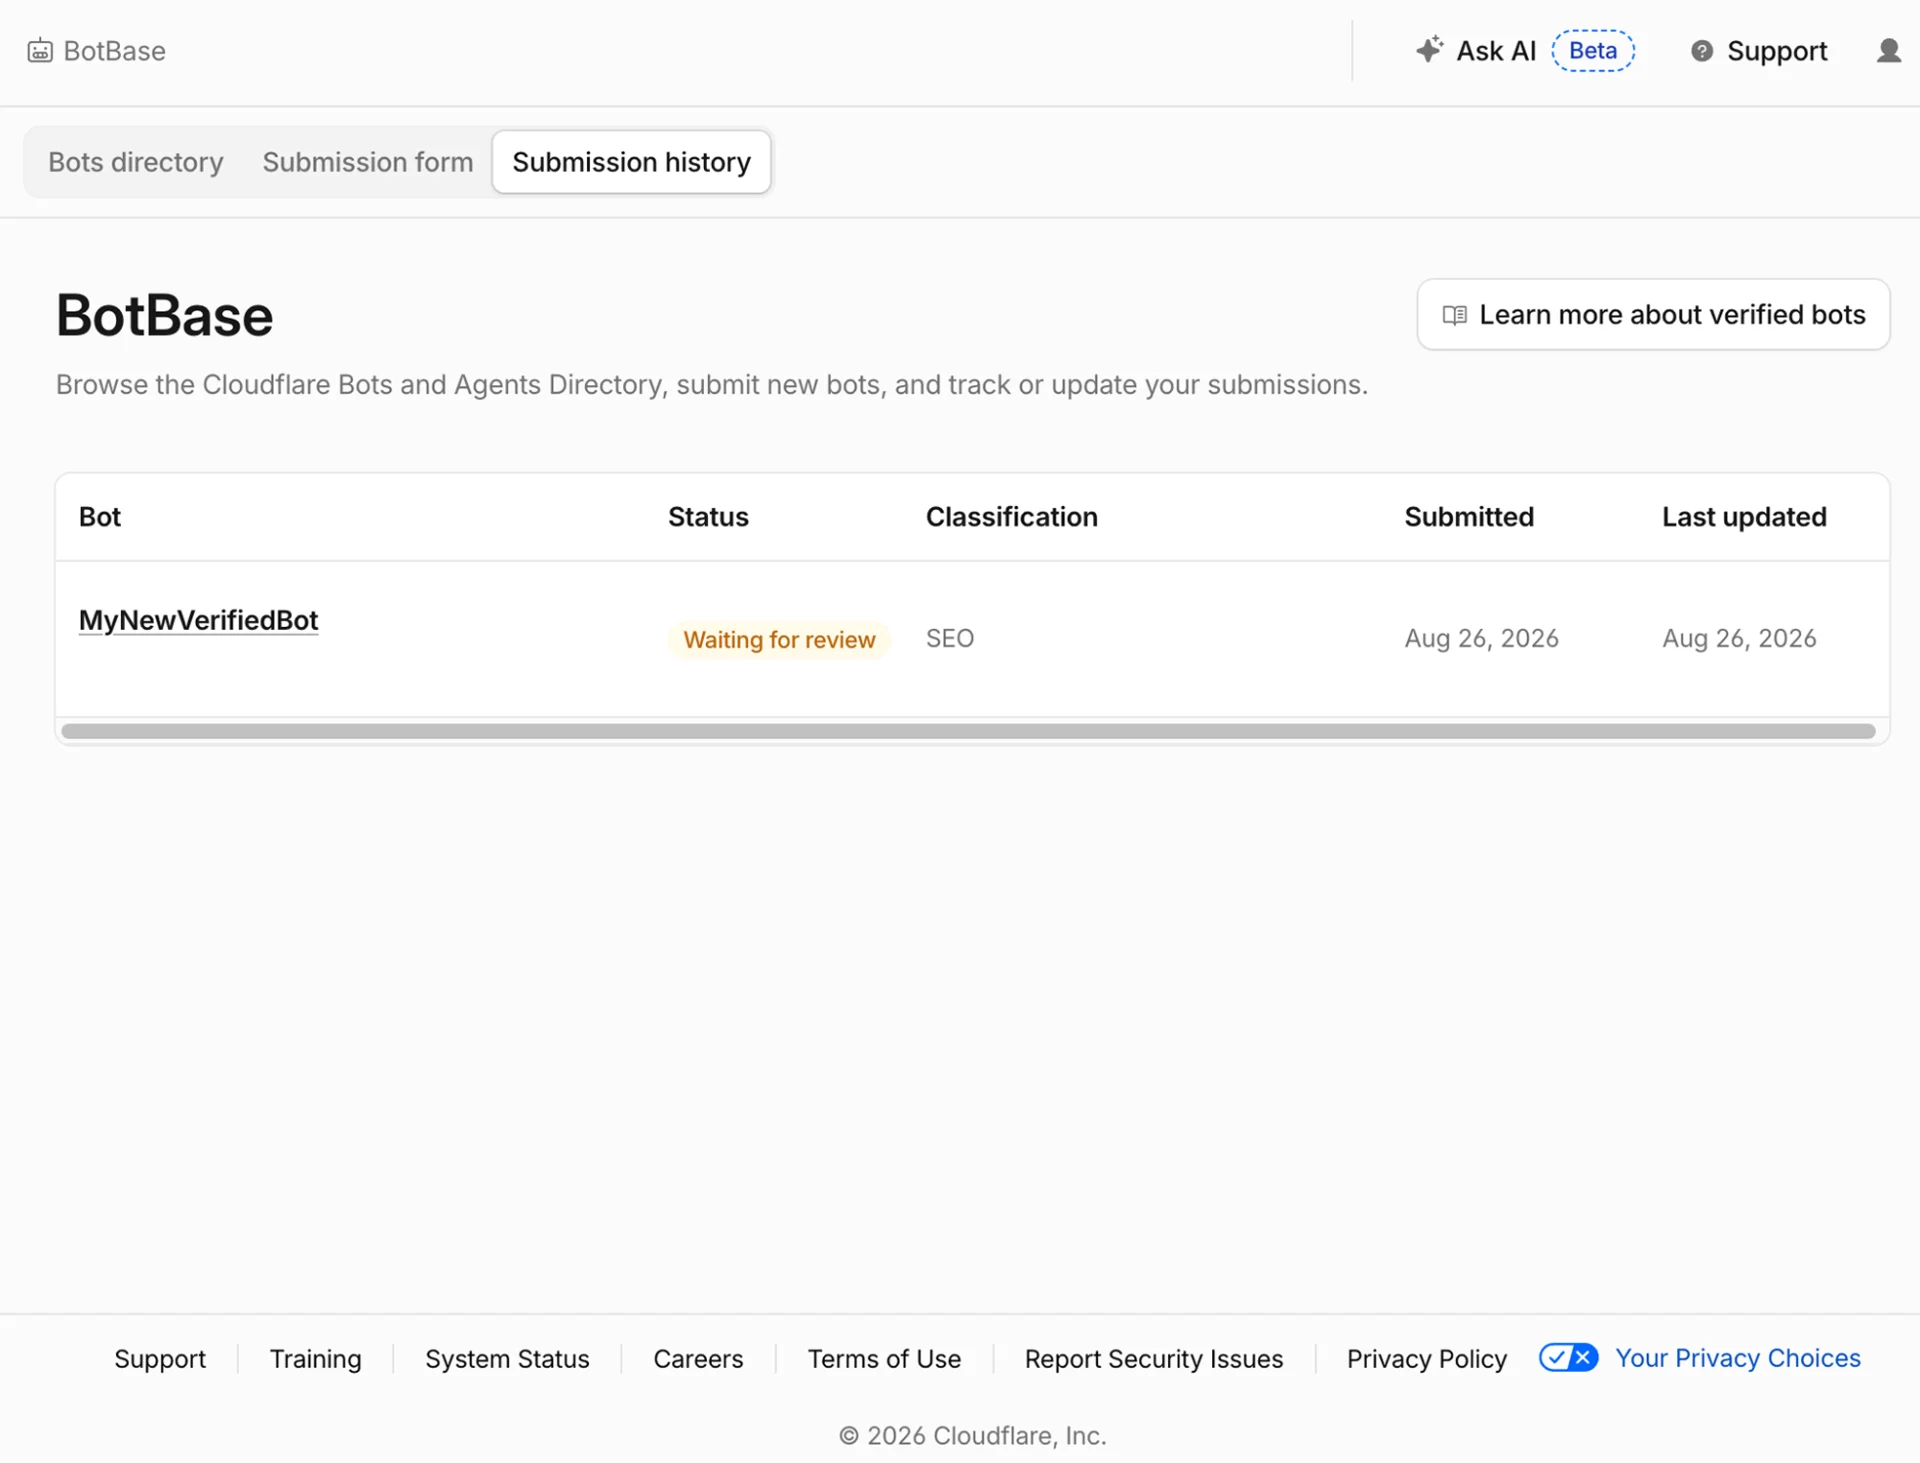
Cloudflare 访谈了许多机器人运营方,最集中的反馈是:提交像扔进黑盒。填表、提交、等待,完全无法判断后续是否有人处理。新的提交历史标签页会展示账户下提交过的每个机器人及其状态。
状态分三类:等待审核(已进入队列)、已接受(机器人已被目录跟踪)、被拒(提交内容需要修改,会附上原因和可执行的修改步骤)。点开任意提交可看完整详情——被拒时会看到具体原因;已接受但分类被调整时,也能看到 Cloudflare 改了什么。
过去运营方要发邮件问支持团队才能知道机器人审没审、进度如何,现在每个运营方都能随时自助查看提交记录,还能在目录页过滤”我的机器人”,看到当前登录账户下提交的所有条目。
信息维护:从重复填表到编辑更新
机器人的身份信息会随时间变化:官网改版后 IP 清单换了地址,或者从 IP 白名单迁移到用 Web Bot Auth 给流量加签,都需要目录条目同步更新。此前唯一的办法是重新填一遍完整表单、提交一个全新条目;现在可以直接编辑已有提交,也可以取消仍在等待审核的记录。
Cloudflare 鼓励运营方保持信息最新,因为准确的资料是机器人获得并维持 Verified 认证状态的关键,而这个状态越来越决定一个机器人能否基于其行为被 Cloudflare 网络内的站点轻松放行。当然,最终允许什么流量仍由站点主自己决定。
声明模型:三个问题代替单一标签
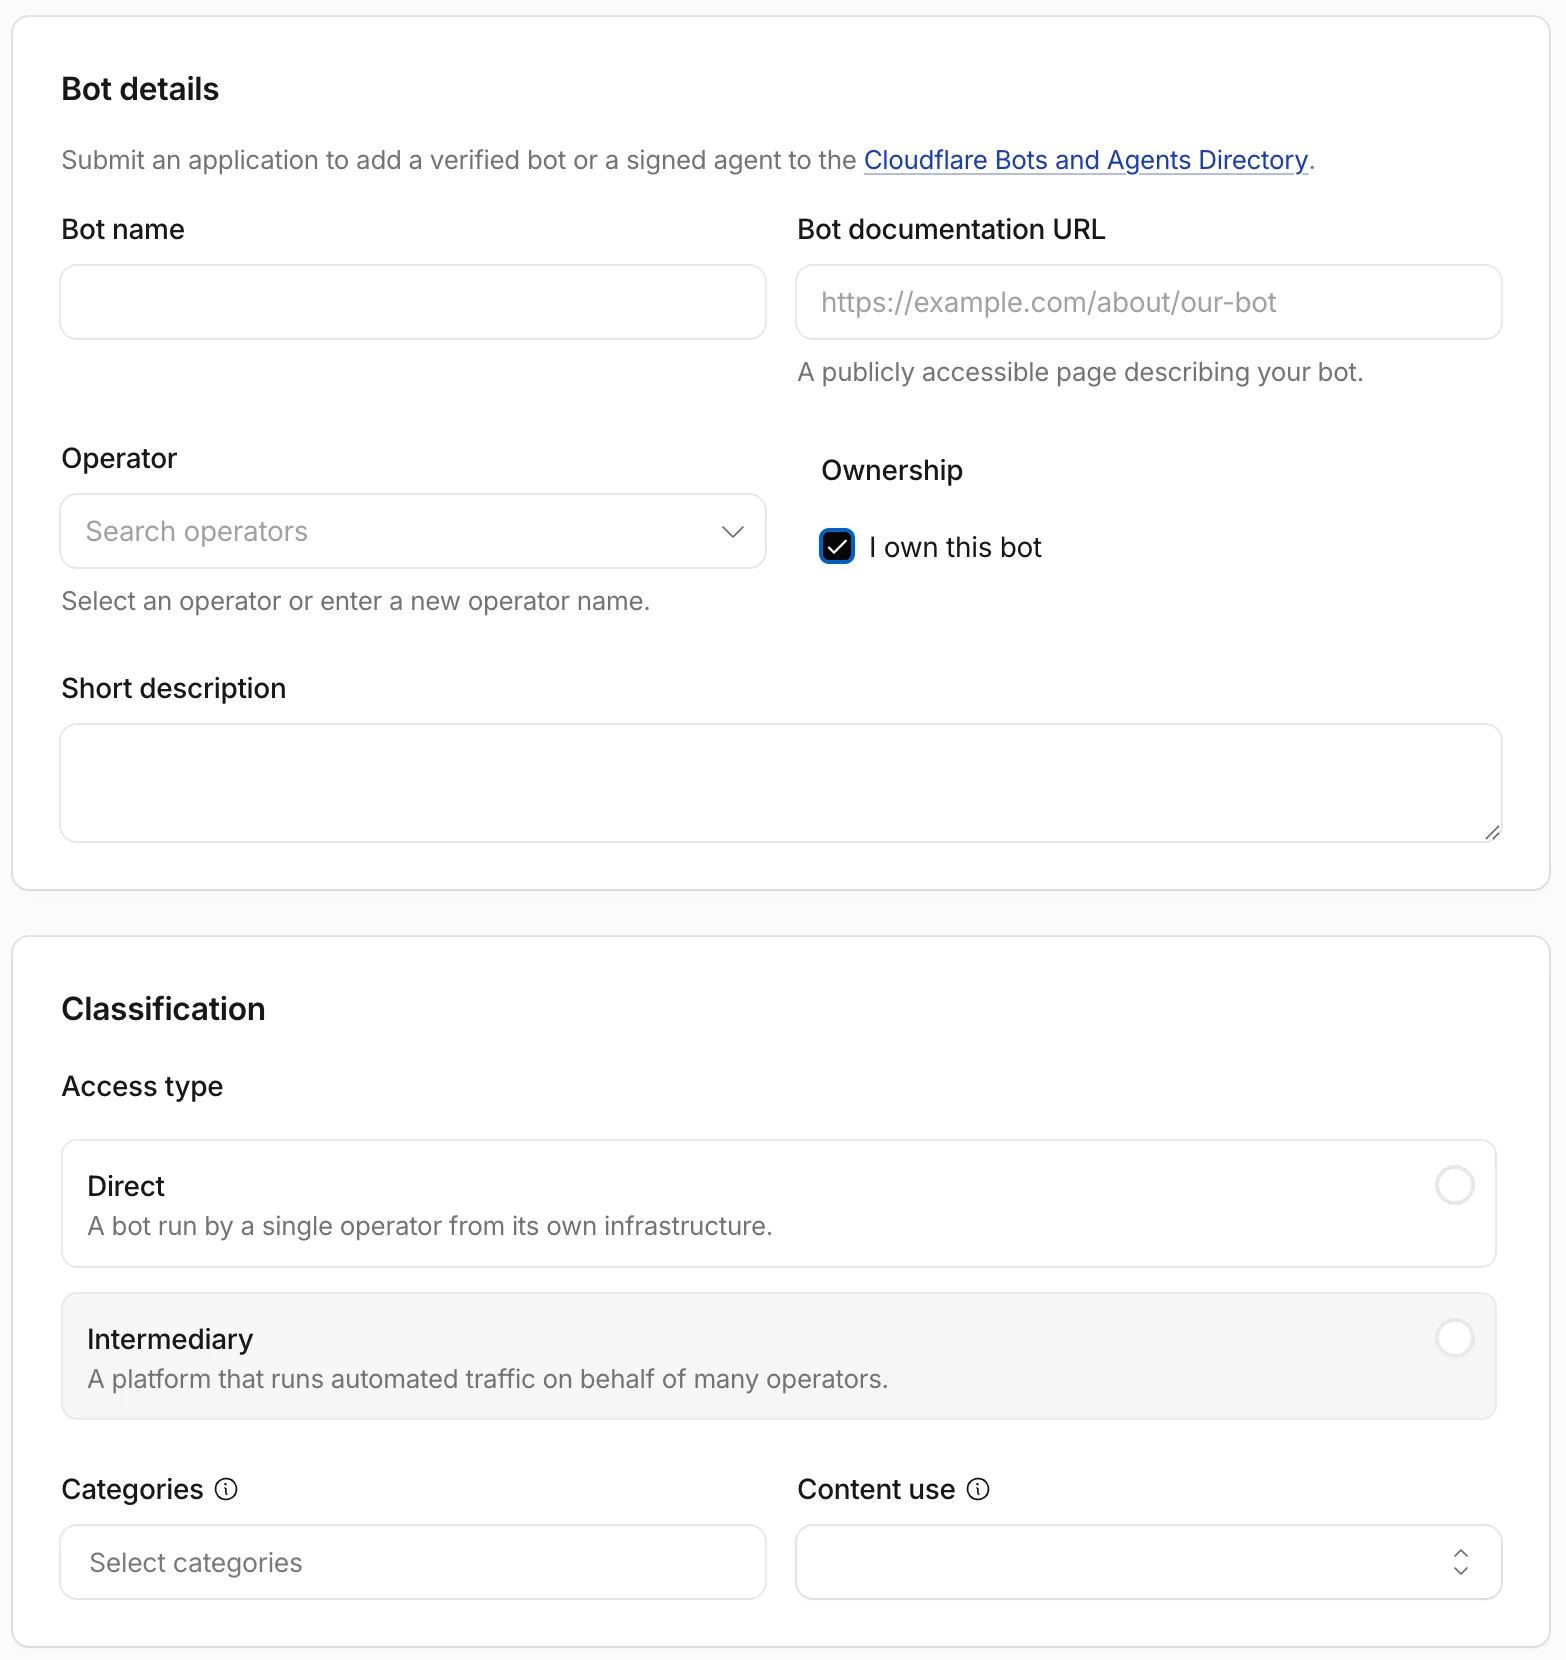
旧表单要求把机器人塞进一个标签里,新表单改为按真实行为描述。这套模型与 7 月 1 日引入的行为与内容使用模型一致,运营方要回答三件事。
第一,机器人做什么。可能只做一件事,比如为搜索建索引;也可能是代表用户执行操作的智能体、采集数据、训练模型或支撑 SEO 工具。可以勾选所有适用行为,而不是只挑最接近的一个。
第二,它如何使用读到的内容。为搜索摘要而浏览页面的爬虫,和把整页存下来训练模型的爬虫,性质完全不同。运营方要按 Content Signals 模型声明内容使用等级——站点主已经在用同一套规则设置偏好,例如站点的 robots.txt 可以写 search=yes、ai-train=no、use=reference,表示允许索引和保留引用但禁止用于训练。机器人的内容用途声明会与这类偏好做核对。
第三,谁在实际运营它。从自己基础设施直接发出流量的属于”直接运营”,比如搜索引擎自己爬网页建索引;如果运营的是其他公司在其上构建的平台、承载并非自己决策发出的流量,则属于”中间方”。一个典型场景:通用 AI 助手因为用户在另一家公司基于其接口构建的应用里提问而去抓取页面——助手运营方维护基础设施,但决定发起请求的是别人的产品。
三问合起来就是完整画像:机器人做什么、如何对待读到的内容、背后是谁,按真实情况描述而不是压缩成一个标签。画像越清晰,站点主越能准确决定如何对待这个机器人。
审核提速:自动化验证替代人工逐条检查
运营方还要求更快的审核。每年新提交的机器人数量自 2023 年以来增长了约 7 倍,纯人工逐条对照内部标准做判断已经无法扩展。
Cloudflare 重建了审核流程使其自动运行:检查是否与已跟踪机器人重复、user-agent 模式是否足够具体且不与已注册条目重叠,最关键的是验证声明的身份验证方式是否真实有效——系统会自动抓取 IP 清单、确认反向 DNS 或验证 Web Bot Auth 签名,取代人工核验。全部通过的机器人可以立即被跟踪;需要人工细看的会带着已标记的具体原因转给团队,而不是作为空白条目落入队列。对运营方而言,大多数提交的处理速度都比以前快。
如何提交你的机器人
想加入 BotBase 目录中数以百计已声明行为与内容用途的机器人,操作路径是:进入控制台的保护与连接 → 应用安全 → BotBase;打开提交表单,声明谁在运营、做什么、如何使用内容、如何证明身份;提交后在提交历史中显示为”等待审核”。
对运营 AI 爬虫或智能体产品的团队,这套流程的价值在于把”被站点封锁还是放行”从运气问题变成可管理的合规任务:把身份验证方式配置清楚、按实际行为生成声明,系统自动测试 DNS 与签名是否匹配,通过后即可进入站点主决策链路的白名单侧。
后续路线
本次发布聚焦可见性。接下来两个目标是:所有权与可观测性,让运营方认领机器人所有权、管理线上目录条目并了解站点如何对待自己的机器人;对话机制,让运营方在能证明价值而非危害的前提下,与站点建立更可持续的沟通方式。
Cloudflare 的愿景是持续扩展 BotBase,让运营方清楚自己的机器人被如何对待、获得更礼貌爬取网页的指引,把一次性提交变成持续关系。BotBase 起初是给站点主的目录,正在变成机器人运营方参与生态、了解自身处境、保持信息准确的场所。
原文信息
- 作者:Julian Laxman(Cloudflare)
- 发布时间:2026-08-28 原文地址:
思路清晰,干货满满。