Cloudflare Bot Preference Sync 实战:robots.txt 自动对齐 AI 爬虫策略,站点主只需配置一次
一句话结论
Cloudflare 推出 Bot Preference Sync,向从免费版到企业版的所有客户开放:站点主在控制台里配置好搜索、智能体与训练三类 AI 流量的策略后,系统自动生成并更新 robots.txt,让”对外声明的偏好”与”边缘实际执行的拦截规则”永远保持一致。对运营内容站点、广告站点或 AI 产品的站长,这是把 AI 爬虫管理从手工维护静态文件变成一次配置、持续同步的自动化工作流。
原文发布后 Cloudflare 于 9 月 15 日追发了后续更新:为 Apple、Google 和 Microsoft 增加了新的 Accountable(可问责) designation,并调整了 Block 与 Disallow AI Training 两个设置的协同方式。
痛点:声明与执行不一致会被爬虫钻空子
网站维护多层爬虫防护一直很繁琐。常见的一种错位是:robots.txt 里声明禁止某爬虫访问,但实际执行规则并没有拦截它。当声明偏好与执行规则不一致时,部分爬虫会把它当作无视你偏好的理由,或者试图绕过你的执行规则。
两年前 Cloudflare 用”托管 robots.txt + 边缘拦截训练爬虫”解决过其中两层;2026 年 7 月 1 日又上线了按搜索、智能体、训练三类 AI 流量分别管理的能力。Bot Preference Sync 是把这些选择串起来的最后一步:把你在 AI 爬虫配置里设定的策略,自动同步写进 robots.txt,随时可开可关,不再需要为单一场景维护静态文件。
站点主面对的新问题
过去这个领域最尖锐的问题是”我的内容是否未经许可就被拿去训练 AI 模型”,这个问题不会消失。但站点主越来越多地问的是可发现性与互动:当有人向 AI 助手提问时,我怎么让自己的站点出现在回答里?我的流量里 AI 爬虫和真人各占多少?哪些内容真正带来引荐,价值几何?
答案因商业模式而异。电商店铺可能希望一切都被抓取和训练,让商品出现在用户问”小公寓适合什么沙发”的回答里;靠广告变现的出版方可能相反——留在搜索索引里让读者能找到页面,但文章不进模型训练集,而且能验证内容确实没被未经许可使用。没有唯一正确答案,控制手段应该跟随策略,这正是 Bot Preference Sync 的设计出发点:你设定的偏好就是你发布的偏好。
透明度门槛:混合爬虫要多交信息
7 月 1 日 Cloudflare 论证过:把搜索、智能体用途和训练混在同一个 user-agent 背后的”混合爬虫”,让站点主难以区分想要的和不想要的流量。这个立场没变。
但透明度可以有不同的推进方式。Cloudflare 选择奖励那些对身份和数据用途表达清晰的运营方:同时做搜索和训练的机器人,要通过验证就必须满足四项额外条件。
满足这些标准的领先 AI 模型及服务提供商的爬虫,在 Cloudflare Radar 的 AI 爬虫透明度版块公开跟踪,既收录遵守最佳实践的例子,也记录不遵守的情况。
这四项条件分别是:以任何机制尊重 robots.txt 里的”禁止训练”偏好;给站点主退出 AI 摘要的途径;提供页面级的训练用途可见性以及搜索结果指标,让站点主能看到内容分别被用于搜索和训练的明细;能公开展示”禁止训练不损害传统搜索结果”。不提供透明度的爬虫得不到默认信任——你禁止训练时照样拦截它。透明度成了准入的代价。
Bot Preference Sync 怎么工作
这是一个把 robots.txt 与 Cloudflare 区域级控制台里已配置的 AI 爬虫偏好保持同步的新能力。如果站点已有 robots.txt,同步内容会前置写入,原有 Disallow 指令全部保留。站点主不再维护单独的静态文件,Cloudflare 根据配置生成或更新 robots.txt,让对外声明与边缘执行一致。
搜索和智能体沿用 7 月 1 日的三个选项:允许、在投放广告的页面拦截、全域拦截。训练类新增 Disallow 选项:在你的 robots.txt 写入”禁止训练”偏好,配合了额外透明度措施的混合爬虫仍可为搜索索引访问你的内容——因为这些爬虫让站点主能直接验证数据如何被使用,你的搜索可见性不受影响。
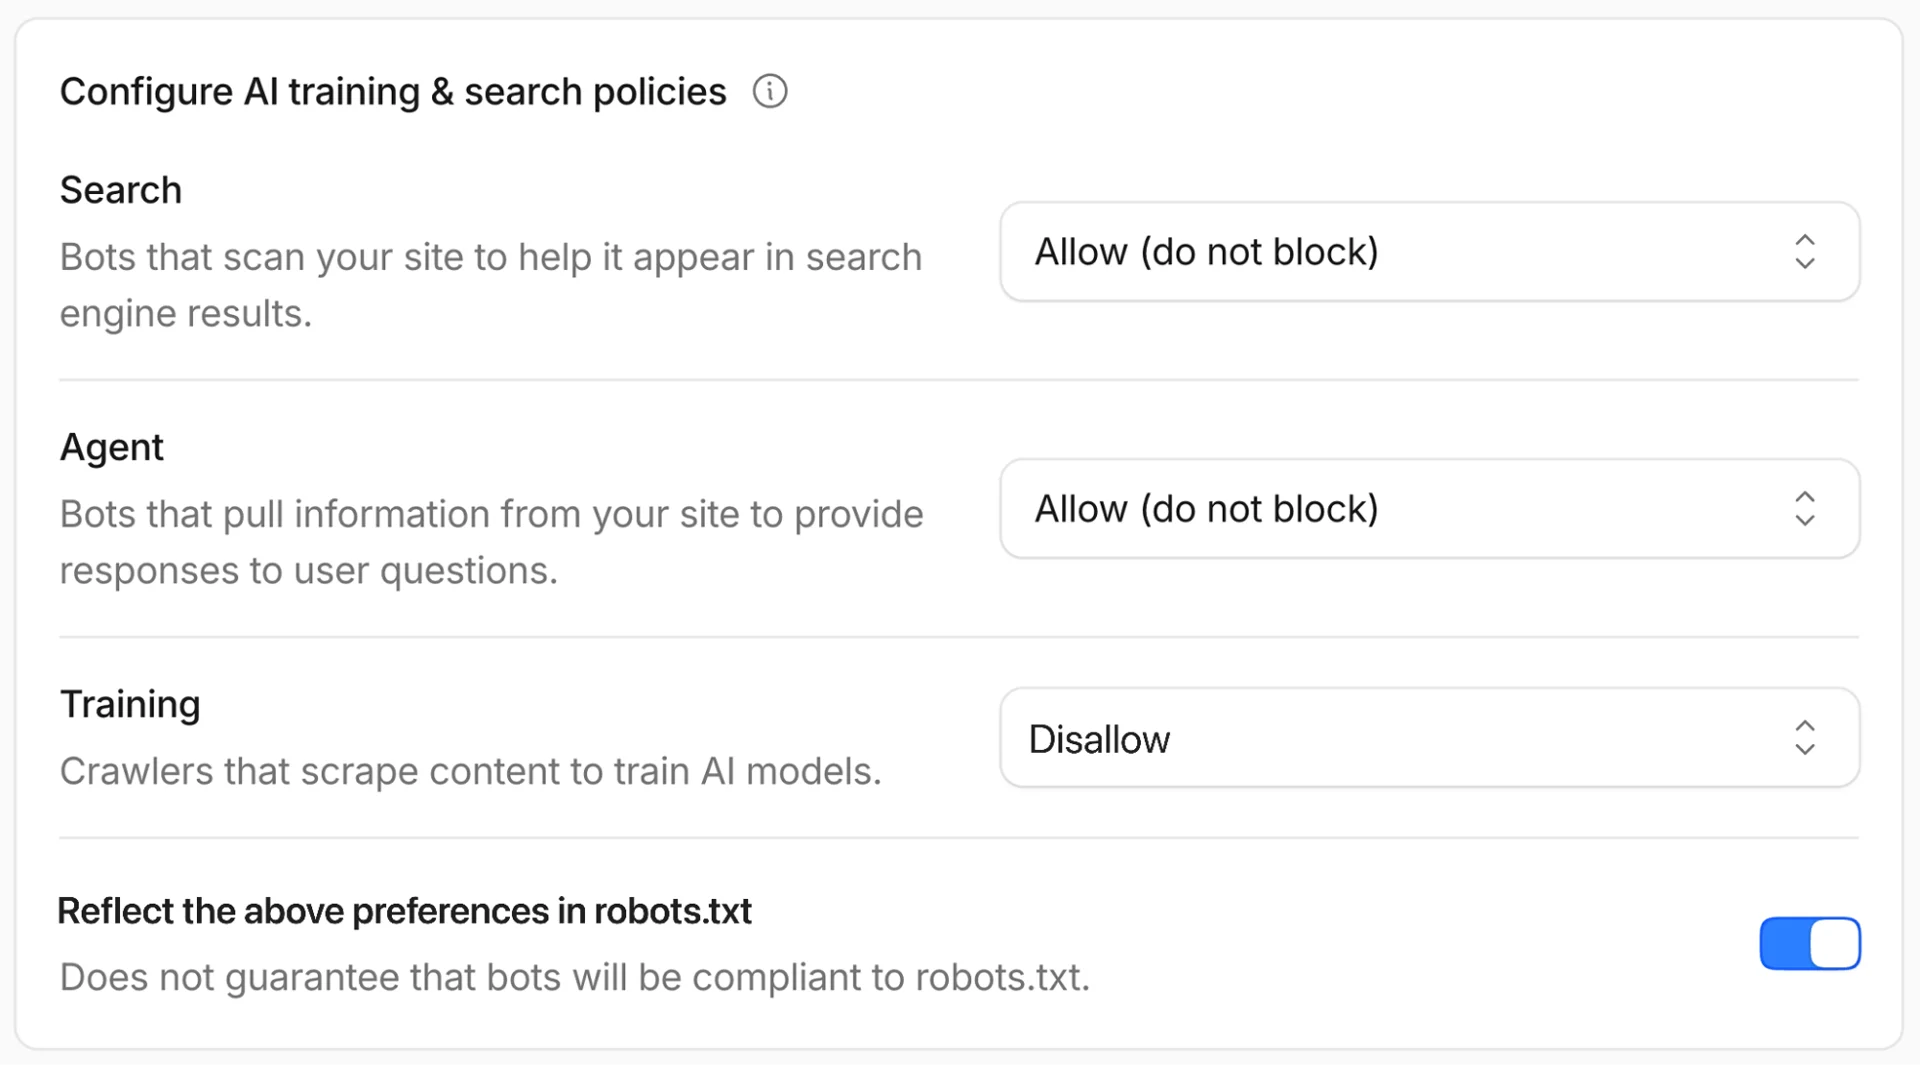
以一个配置了”允许搜索、允许智能体、禁止训练”的站点为例,开启同步后 robots.txt 会前置类似这样的内容(示例经简化):在 BEGIN 与 END Cloudflare Bot Preference Sync 标记之间,对 TrainingBot1、TrainingBot2、TrainingBot3 和 MixedUseBot-Extended 逐个声明 User-agent 并写入 Disallow。选择拦截或禁止某类别时,写入 robots.txt 的机器人清单由 BotBase 跟踪数据定期更新,被分类为搜索、智能体和训练的已验证机器人随时可在公开目录查看。
默认值与特殊场景
新客户默认开启同步,让拦截与偏好天然反映同一策略。正在使用旧托管 robots.txt 功能的客户,会在新功能正式上线时收到确认偏好的提示。
需要更精细控制的客户可以选择关闭组级同步、手工定制文件,比如与某家公司有特殊授权例外时。Bot Preference Sync 面向类级策略决策,不读取带复杂逻辑的单条自定义规则。
针对出版方和广告站点还有一个差异化默认值:入驻时选择”本域名靠页面广告变现”,训练类默认设为禁止训练,保持留在搜索索引的同时让内容不进模型训练集,且随时可改。非出版方场景的新客户入驻时不默认添加任何拦截或禁止,选择权完全在客户自己。
对站长和 AI 从业者的实操意义
这个功能把三类高频决策变成了可回滚的配置项:想让内容出现在 AI 助手的回答里,就把智能体流量设为允许;想保护原创内容不被拿去训练模型,就把训练设为禁止,配合透明度达标的爬虫仍能保住搜索流量;广告站点直接用默认的禁止训练模板。
相比手工维护一份越来越长的 robots.txt——每出一个新爬虫就要手动加一行、写错语法还会被爬虫利用——托管同步方案的维护成本趋近于零,且拦截规则与声明偏好由同一系统生成,天然不会出现两者打架的窗口。功能将在一周内对所有套餐开放,上线后留意控制台和邮箱里的偏好确认提示。
原文信息
- 作者:Jin-Hee Lee(Cloudflare)
- 发布时间:2026-08-21 原文地址:
整理得太全面了,省了我不少时间。
这篇文章分析得很透彻,收藏了!