Claude Code 与 Cursor:实测揭示功能对比所忽略的真相
📌 One-Sentence Summary
在 Claude Code 与 Cursor 之间做选择时,功能对比和基准测试会产生误导;唯一可靠的方法是用自己真实的任务组合进行为期一周的实测,衡量每次成功合并变更的成本,结果显示 Cursor 在交互式工作中胜出,而 Claude Code 在自主式多文件任务中胜出。
📝 Summary
文章认为,公开的 Claude Code 与 Cursor 对比基准彼此矛盾,因为 token 成本取决于任务类型而非工具本身。Claude Code 以智能体为先、终端原生,擅长自主式多文件重构和 CI 任务。Cursor 以 IDE 为先,擅长交互式前端工作和紧密的编辑—运行—审查循环。作者提出为期一周的实测方案:让同一位工程师用两个工具分别处理 15-20 个真实工单,衡量每次成功合并变更的成本(正确性、人工监督时间、token 成本、失败模式)。决定默认工具的是胜出分布而非平均值。企业采购应优先考虑治理、认证、部署路径和成本控制结构,而非功能列表。大多数严肃团队应同时使用两者,并按任务类型分流。
💡 Main Points
公开的 Claude Code 与 Cursor 对比基准彼此矛盾且具有误导性,因为它们衡量的是每个任务的成本,而非每次成功结果的成本。
基准测试对同一任务报告的 token 数量差异巨大(例如 33k 与 188k),因为 token 成本是任务、代码库以及人如何驱动智能体的属性,而非工具本身的属性。单一基准无法捕捉真实工作的分布。
架构差异——以智能体为先、终端原生(Claude Code)对比以 IDE 为先、以编辑器为中心(Cursor)——决定了哪个工具在特定任务类型上胜出。
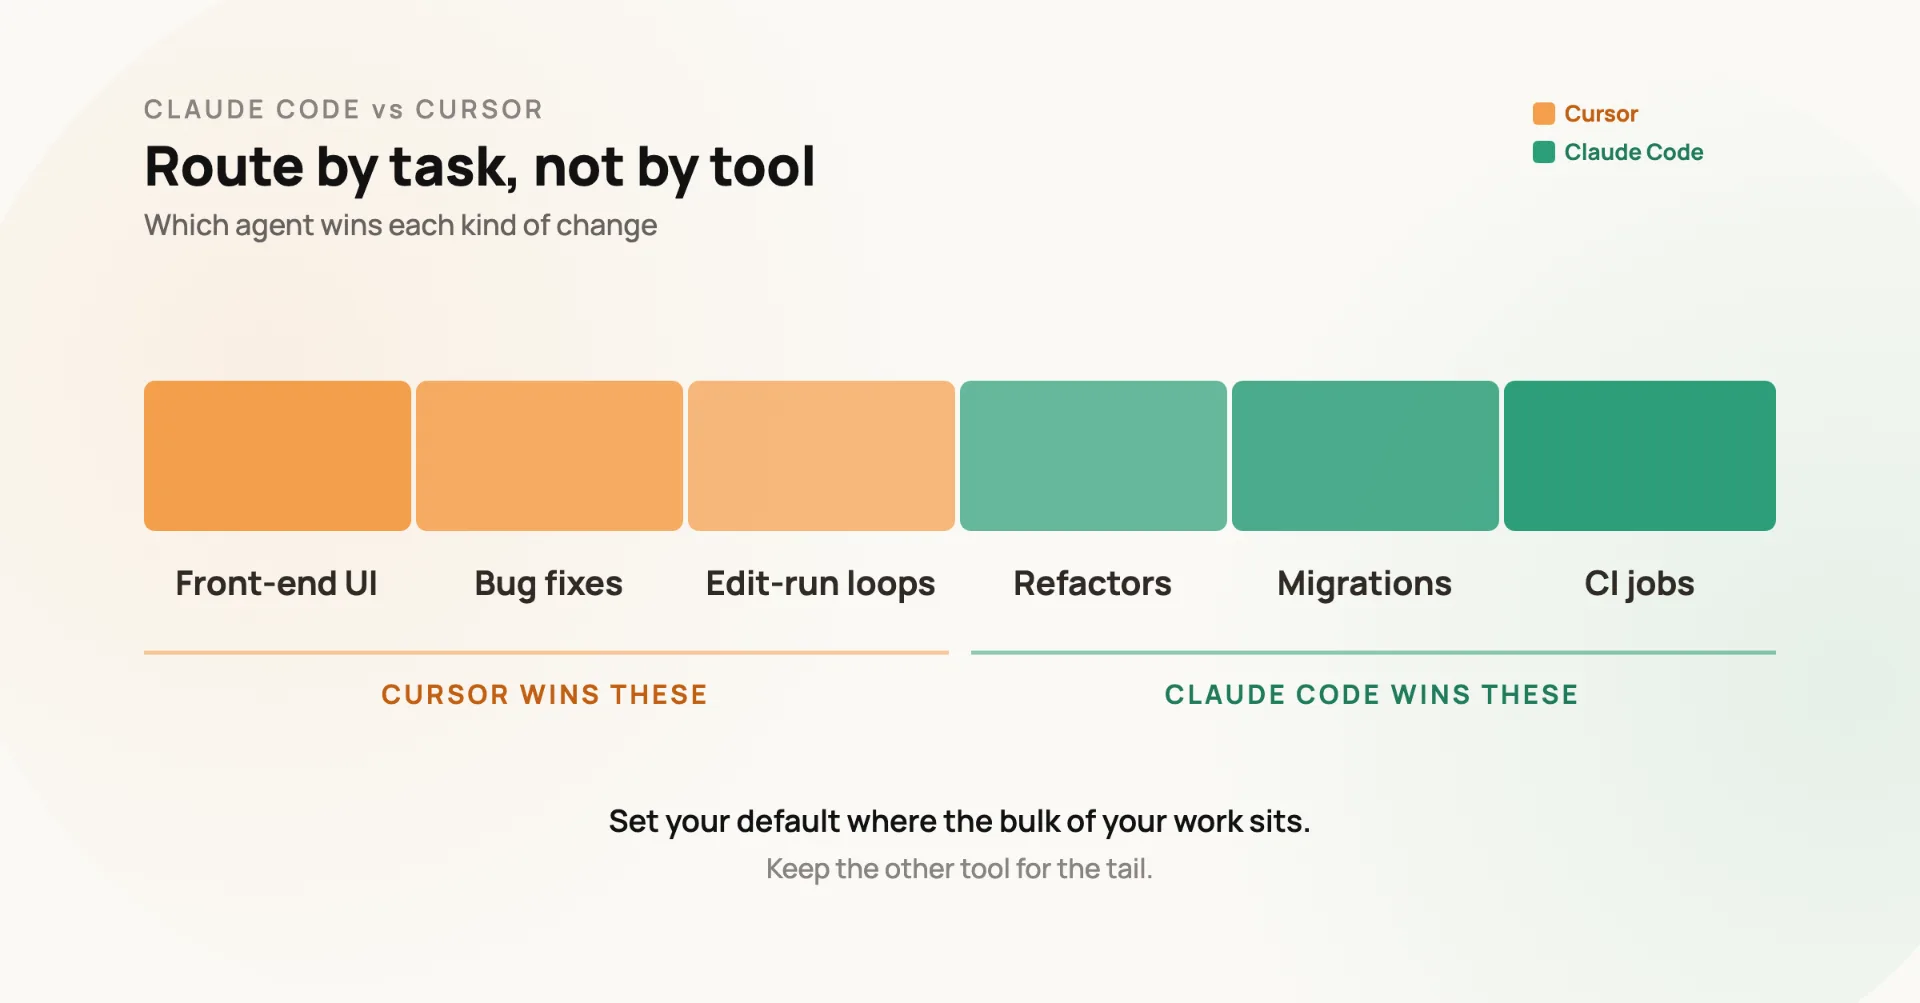
Claude Code 的设计偏向自主式、长周期、多文件工作,由人下达任务简报、智能体执行。Cursor 的 VS Code 分支设计偏向交互式、行级、前端工作,由人主导、智能体加速。任务落在这条光谱上的位置不同,两个工具的优势就会反转。
用 15-20 个真实工单进行为期一周的实测,衡量每次合并变更的成本(正确性、人工时间、token 成本、失败模式),能可靠揭示任务类型分布和正确的默认工具。
让同一位工程师用两个工具分别处理相同工单,可控制操作者差异。阅读哪个工具在哪种工单类型上胜出的分布——而非对 token 取平均——才能得出站得住脚的决策。实测显示 Cursor 在交互式工单上胜出,Claude Code 在自主式工单上胜出。
企业采购应基于治理约束(认证、部署路径、审计日志、成本控制结构)而非功能列表来做决定。
在撰写本文时,Cursor 拥有更多认证和更完整的企业方案,而 Claude Code 提供更多云部署路径。定价模式不同(额度池对比用量重置),影响波动型与稳定型用量的成本控制。治理和集成占生产工作的 80%。
💬 Key Quotes
编程任务上的 token 成本不是工具的属性。它是任务、代码库以及人如何驱动智能体的属性。
唯一有意义的单位是让一个正确的、已合并的变更进入生产环境的成本,包括人工监督时间,而没有任何功能对比表衡量这一点。
一个没有按你实际任务组合加权的基准,是伪装成数据的噪音。
你实际做的决策不是「哪个工具胜出」,而是「哪个任务交给哪个工具,以及我的默认是什么」。
工具只占成本的一小部分,围绕它的治理——谁能运行什么、针对哪些代码库、用哪个模型、如何记录日志——才是更大且更持久的决策。
📊 Article Meta
AI Screening: 87
Source: Towards Data Science
Author: Pratik Rupareliya
Category: 人工智能
Language: 英文
Read Time: 10 min
Word Count: 2424
Tags:
AI 与智能应用 , AI 编程 , 代码助手 , 开发者工具 , AI 工程
这个观点很中肯,深有同感。
不错不错,已加入书签。
写得挺用心的,支持一下。
整理得太全面了,省了我不少时间。
思路清晰,干货满满。
思路清晰,干货满满。
看完了,收获满满,期待更多更新。
实测过类似工具,作者说的基本属实。
实测过类似工具,作者说的基本属实。
看完了,收获满满,期待更多更新。
写得挺用心的,支持一下。
整理得太全面了,省了我不少时间。