拆解 AI 模型的空间推理能力
📌 One-Sentence Summary
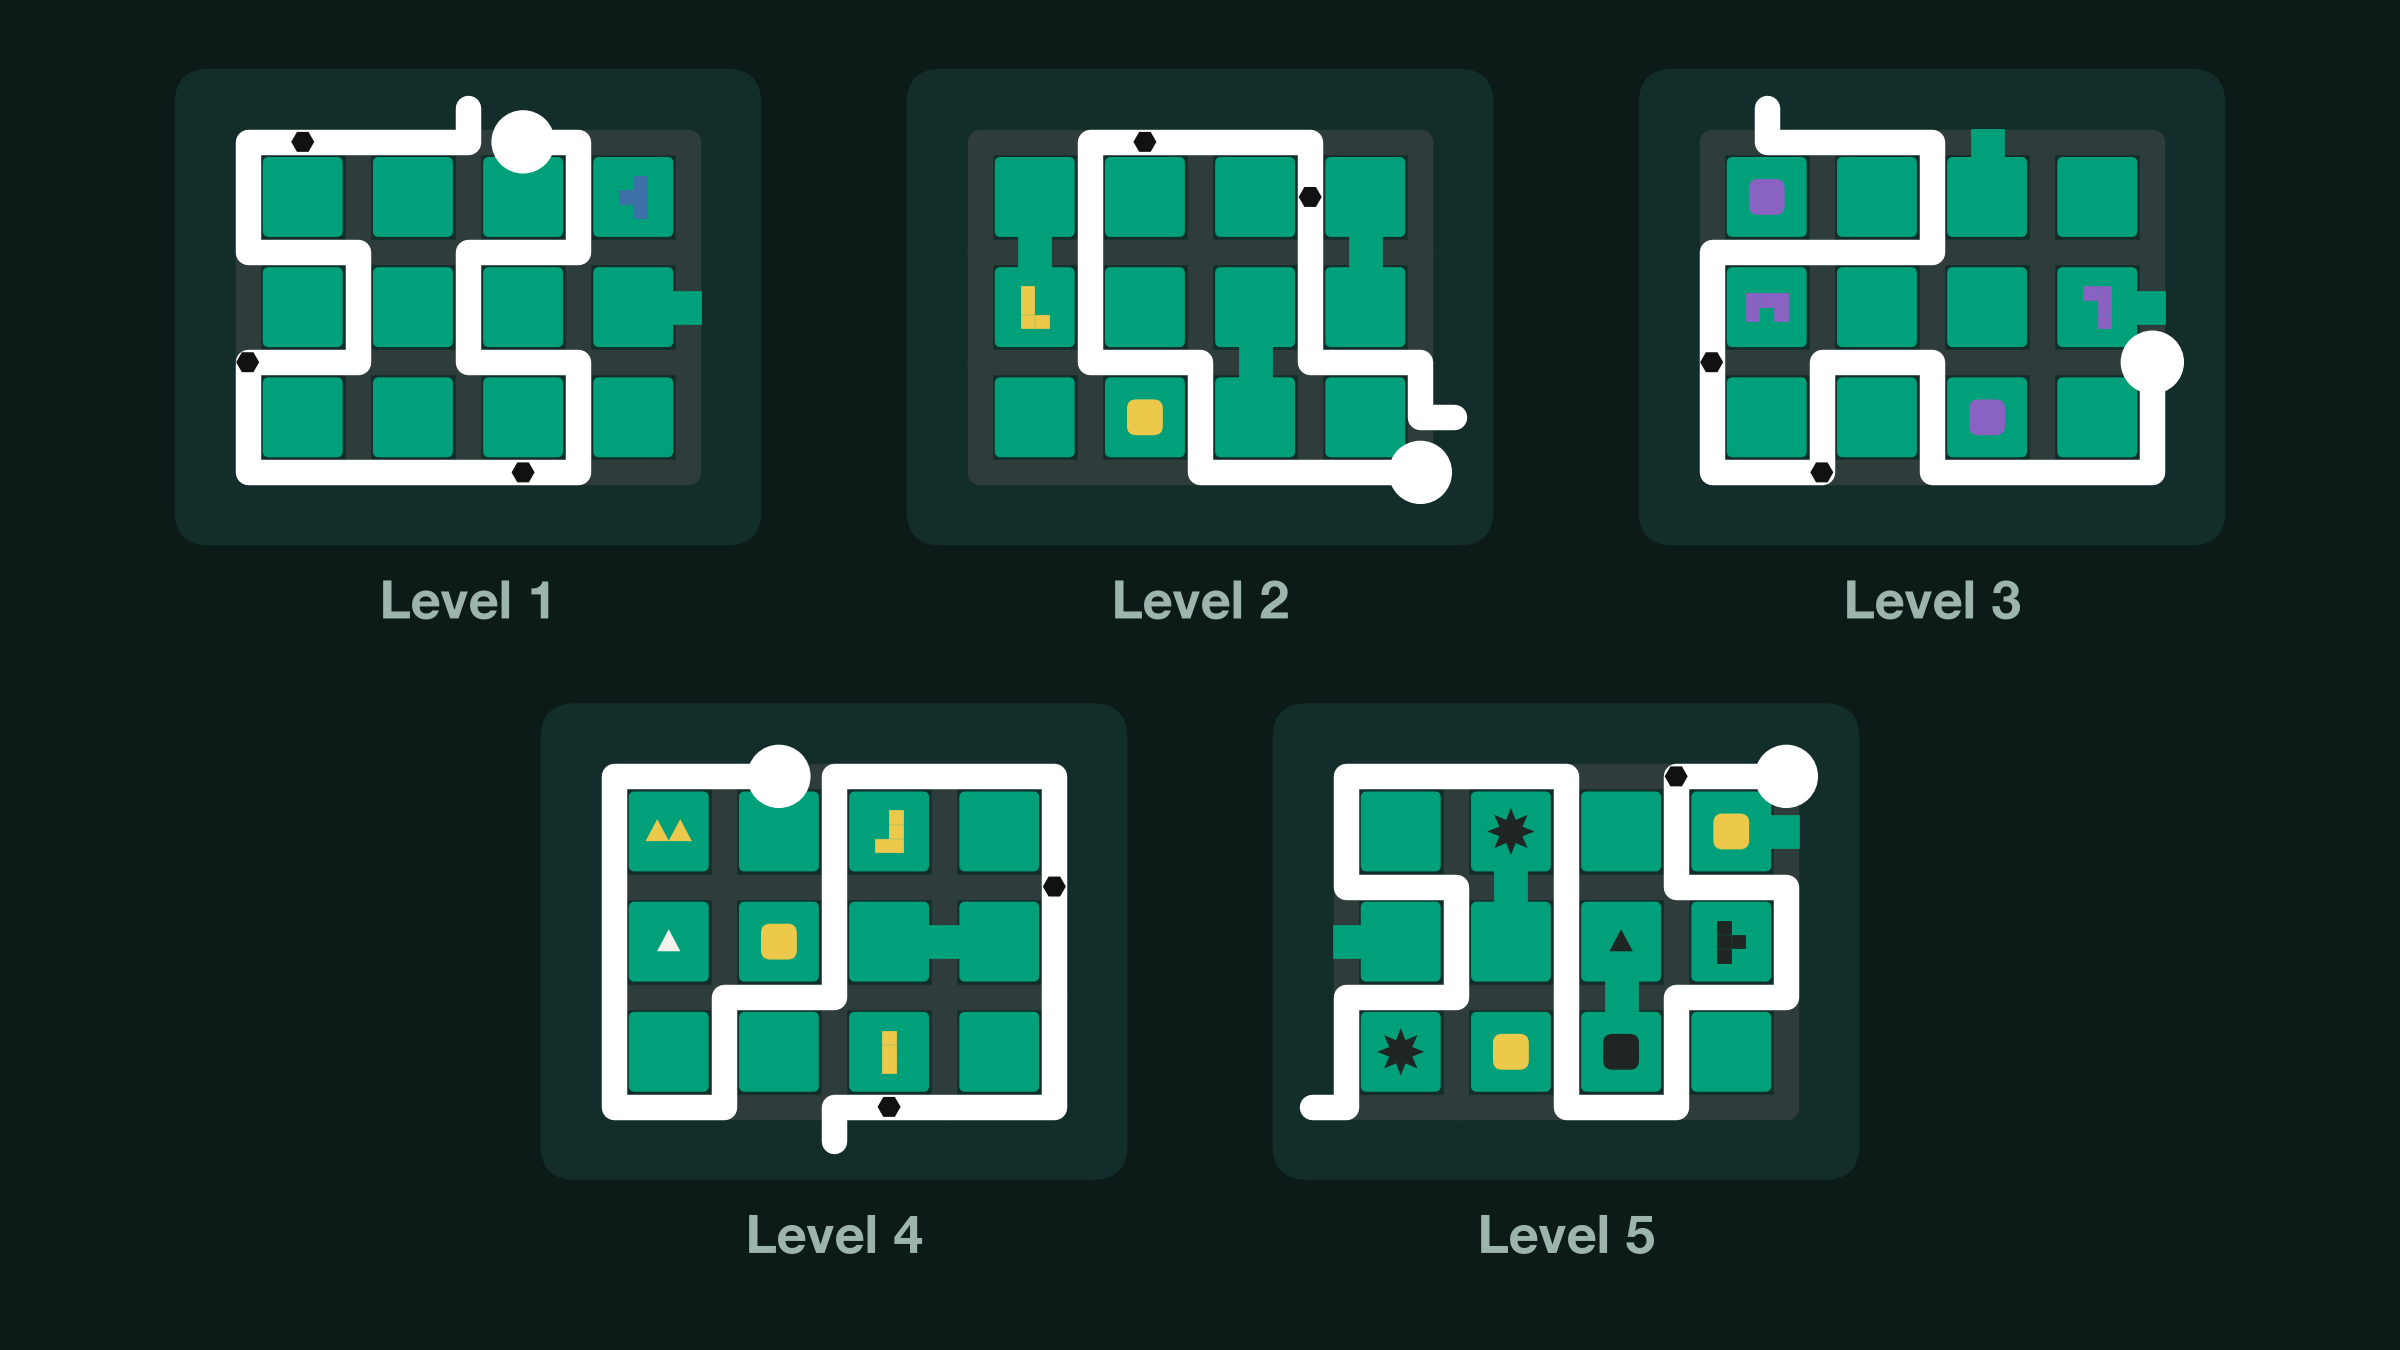
本文剖析了 AI 模型在 SPaRC 网格谜题基准测试中的表现,发现人类几乎能解出所有谜题,而模型在感知、路径追踪、遵守规则和分配推理资源方面困难重重,尤其是谜题复杂度增加时。
📝 Summary
这项研究分析了 AI 模型在 SPaRC 空间推理基准测试中的表现。该测试要求参与者遵循特定规则,在网格中画出一条路径。主要发现包括:1)感知问题:模型难以从图像中准确读取棋盘;如果提供更清晰的视觉辅助,或改用文本网格,准确率会显著提升。2)路径追踪:许多模型答案无法构成从起点到出口的有效连续路径,常常穿过格子或在不连通的点之间跳跃。3)遵守规则:模型虽然能到达出口,却经常违反谜题规则(例如颜色分隔、圆点位置要求),说明它们并未真正理解这些约束。4)资源分配:人类会在更难的谜题上花费更多时间,而模型投入的计算资源与谜题难度几乎没有相关性。
💡 Main Points
感知是视觉语言模型面临的主要瓶颈。
数据表明,视觉输入(即「图画」)的清晰度与模型解题能力高度相关。Qwen 3.5 397B 等模型在棋盘以明确的文本标签而非原始图像呈现时,表现会显著提升。这说明视觉组件难以可靠地提取间隙和出口等特征。
模型甚至在检查规则之前,就无法维持有效路径。
模型输出中有相当一部分是「断裂路径」——无法连接起点与终点,或穿过网格格子的路径。这表明模型在规划或执行阶段存在根本性缺陷:还没开始满足谜题逻辑,就已经无法追踪有效的移动空间。
到达出口不等于解开谜题。
A* 搜索基准实验表明,单纯寻找通往出口的最短路径并不困难。然而,模型无法遵循实际解题所需的特定规则(例如颜色分隔),说明当前架构缺少必要的约束处理能力。
模型不会根据谜题难度调整投入的精力。
人类会自然地在更难的谜题上花更多时间,但分析显示,QwQ 32B 等模型的输出 token 数量相对固定,不受谜题难度影响。这种缺乏适应性的推理表现说明,模型无法有效判断何时需要深入分析。
💬 Key Quotes
视觉辅助研究固定了每道谜题,只改变了呈现方式。对于我们测试的最强模型,仅改变画法就使准确率相差了 34.0 个百分点。
在 SPaRC 中,o4-mini 有 59.2% 的答案至少存在上述问题之一,GPT-4.1 则有 93.6%。在我们测试的 7 个模型中,有 6 个最常见的问题是路径穿过格子。
A* 搜索会寻找从起点到出口的最短路径,但忽略规则。它总能到达出口,解出 6.4% 的谜题。随机游走则能解出 2.4%。
我们的研究发现,谜题越难,人们思考得越久。每道谜题的平均耗时从第 1 关的 10.7 秒增加到第 5 关的 131.5 秒,超过 12 倍。而我们能够测量的两种开放式推理模型,耗时并未增加。
📊 Article Meta
AI Screening: 88
Source: Towards Data Science
Author: Lars Benedikt Kaesberg
Category: 人工智能
Language: 英文
Read Time: 13 min
Word Count: 3199
Tags:
AI 与智能应用 , 数据科学 , 科学前沿 , 测试与质量 , 模型训练与推理
不错不错,已加入书签。
实话,说的不明不白
路过
路过
整理得太全面了,省了我不少时间。
赞同,实践出真知。
有没有更详细的教程,期待后续。
实测过类似工具,作者说的基本属实。
点赞,必须点赞
有没有更详细的教程,期待后续。
支持作者,持续关注中。
赞同,实践出真知。