策略内自蒸馏能否革新后训练?
📌 One-Sentence Summary
策略内自蒸馏(OPSD)融合了策略内强化学习的稳定性与自蒸馏的定向学习能力,为基础模型在新任务上进行后训练提供了一种有前景的方法,同时避免灾难性遗忘。
📝 Summary
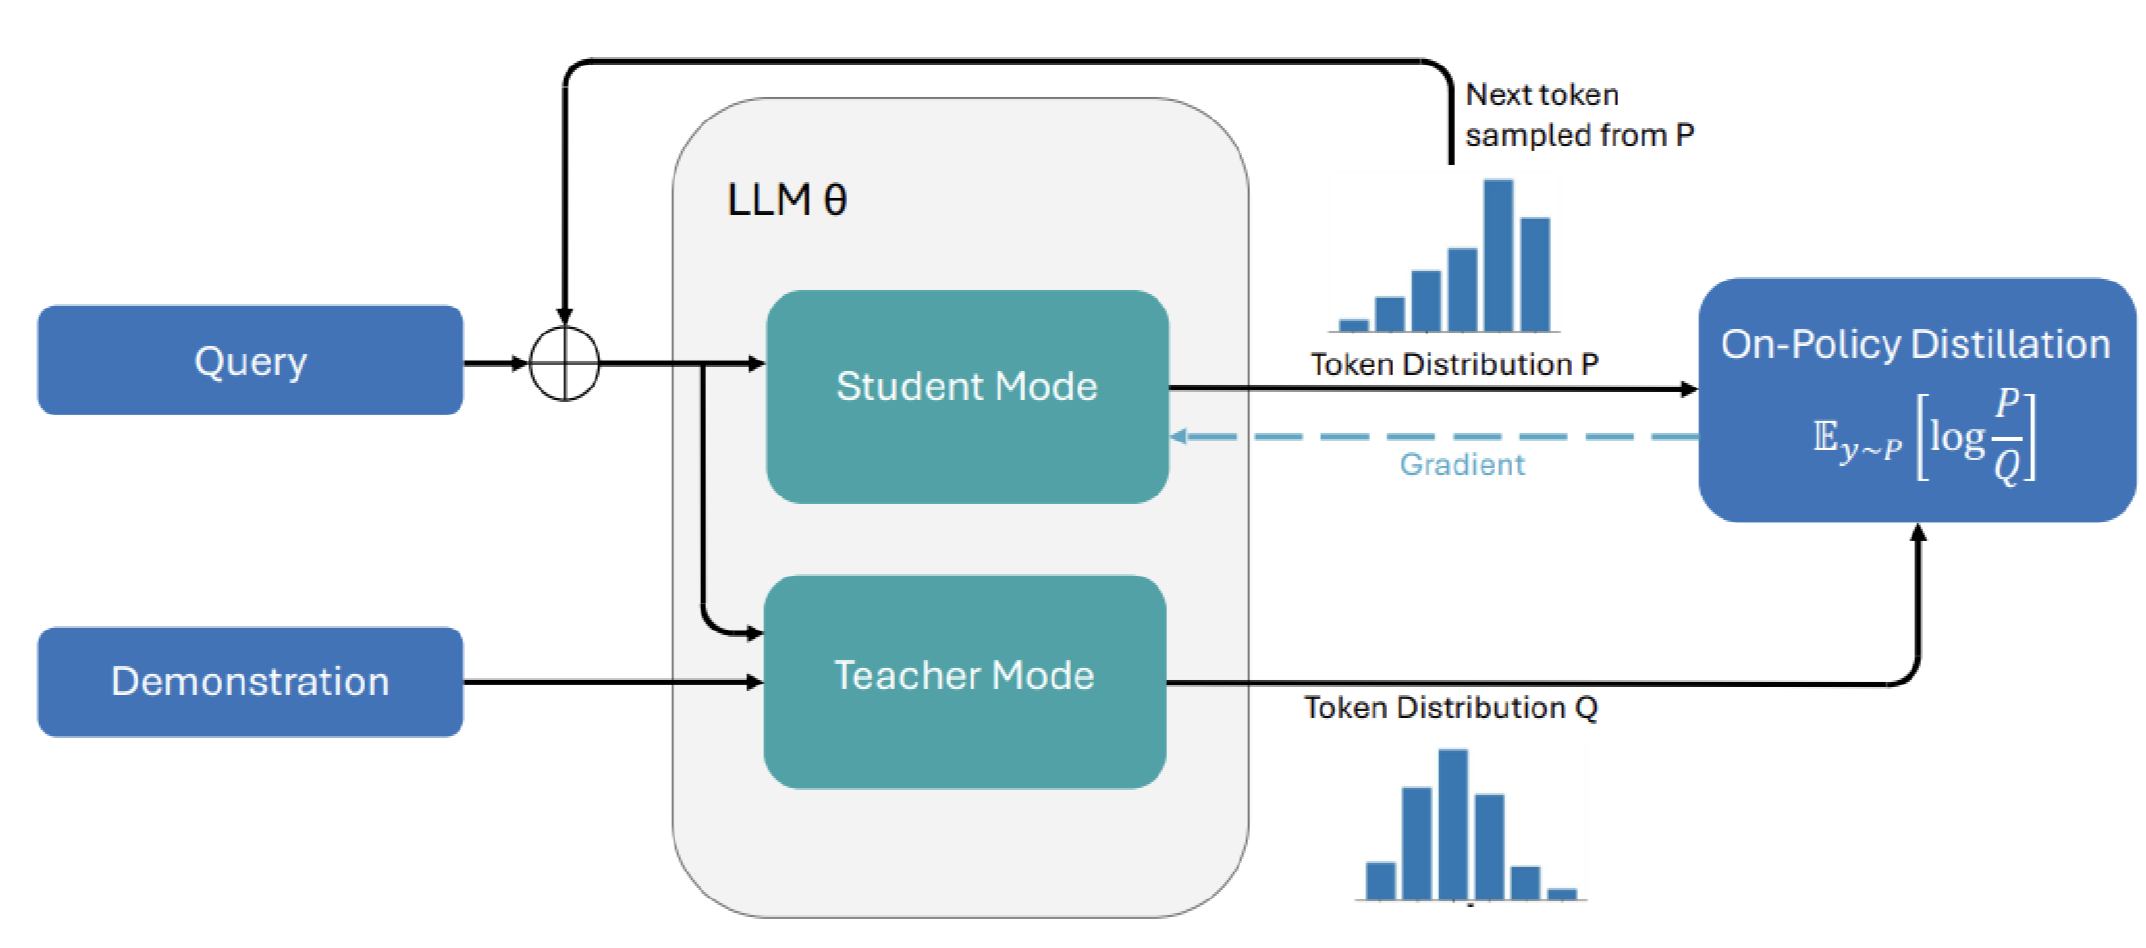
本文探讨了策略内自蒸馏(OPSD)革新基础模型后训练的潜力。文章首先解释了灾难性遗忘这一难题:模型在学习新任务时会丢失先前掌握的技能。随后,作者介绍了 OPSD,尤其是自蒸馏微调(SDFT)框架。该框架利用专家示范,让模型教会自己。文章还讨论了这种方法的理论优势,包括能够尽量减少与基础模型的偏离并保持稳定性。文中也回顾了实验结果,显示 SDFT 在维持模型跨任务表现方面优于标准微调和其他强化学习方法。最后,文章指出了该方法的局限,例如输出趋同的风险,以及谨慎选择示范数据的必要性。
💡 Main Points
灾难性遗忘是后训练的一大障碍:模型学习新技能时,可能会丢失先前掌握的能力。
在新任务上微调模型,往往会导致它忘记此前训练中学会的任务,从而削弱泛化能力。这对打造能够处理各种问题的通用 AI 助手尤其不利。
策略内自蒸馏(OPSD)结合了策略内强化学习的稳定性与自蒸馏的定向学习能力。
OPSD 使用学生模型参数的指数移动平均值作为教师模型,确保教师模型与学生模型保持接近,避免其他方法中出现的「回声室」不稳定问题。这样一来,模型就能学习新任务,同时不会大幅偏离其基础能力。
实验结果表明,SDFT 在维持跨任务表现方面优于标准微调和其他强化学习方法。
研究显示,采用 SDFT 训练的模型在成功掌握新技能的同时,仍能在先前学过的任务上保持较高准确率;而标准微调会显著削弱模型在旧任务上的表现。
OPSD 的一项主要局限是输出可能趋同,导致模型过度依赖训练时使用的特定示范。
如果示范不够多样,模型可能无法泛化到任务的不同变化情形,因而缺乏鲁棒性。谨慎选择示范数据对于避免这一问题至关重要。
💬 Key Quotes
在不损害基础模型能力的前提下教会它们新技能并不容易。一种新的强化学习方法或许能改变这一现状。
📊 Article Meta
AI Screening: 87
Source: Towards Data Science
Author: Jonathan Yahav
Category: 人工智能
Language: 英文
Read Time: 16 min
Word Count: 3784
Tags:
AI 与智能应用 , 后训练 , 持续学习 , 数据科学 , 机器学习
写得挺用心的,支持一下。
看完了,收获满满,期待更多更新。
讲解得很细致,新手也能看懂。
点赞,必须点赞
思路清晰,干货满满。
有没有更详细的教程,期待后续。
路过
实测过类似工具,作者说的基本属实。
内容翔实,正好需要,先收藏再看。
赞同,实践出真知。
赞同,实践出真知。
内容翔实,正好需要,先收藏再看。