Broad研究所实课:用AlphaFold3把基因变异翻译成蛋白质结构机制

一句话结论
这是 Broad 研究所 MPG Primer 系列的又一堂方法论实课,讲者 Sherif Gurgis 是 Broad 研究所博士后,师从 Mark Daly 和 Steve McCarroll 完成哈佛博士训练,研究方向是用计算工具理解遗传机制、为疑难疾病发现药物。51 分钟里他讲了一条完整的工作链:错义变异(missense variant)为什么难解读、AlphaFold3 的三阶段预测管线怎么工作、蛋白质语言模型(ESM1B、AlphaMissense)判断变异致病性时分歧有多大、以及如何把变异映射到预测结构上做聚类分析——ClinVar 上 872 个孟德尔疾病基因用这套方法拿到了结构性信号。任何做基因变异解读、结构生物学分析或者想理解 AlphaFold3 实际用法的人,这堂课给的是一条可复现的分析路径。
整堂课的信息密度分布也适合按需取用:前 20 分钟是问题定义和工具原理,适合建立判断框架;中间 20 分钟是工具对比和分歧率分析,是日常实操最常翻回的部分;最后 10 分钟加问答是案例和边界讨论,适合遇到具体问题再回来查。
开场有个细节值得注意:Gurgis 问现场有多少人用过 AlphaFold,举手者寥寥。这堂课就是为零基础研究者设计的入门路径,从”为什么需要结构”讲到”怎么用结构做变异解读”,每一步都有工具名和判断依据。
双重解读挑战:为什么错义变异这么难
Gurgis 把错义变异的解读困难拆成两层,这是全课的问题框架。
第一层:致病性光谱。 错义变异的影响是一个从完全良性到完全致病的连续光谱,每个变异落在光谱的哪个位置事先不知道。绝大多数变异是”意义未明变异”(VUS,variants of unknown significance)——临床检测报告里最常见的标注就是这个,意味着工具无法判断。VUS 的实际代价被低估了:患者拿到一份布满 VUS 的报告无法行动,医生无法用它做诊疗决策,后续的筛查、预防、家族遗传咨询全部卡壳。把 VUS 变成可判断,是整个变异解读领域的核心产出指标。
第二层的前提:变异量级。 这个问题的规模感也需要建立——人类基因组里每个人的错义变异以万计,群体层面累计的错义变异总数是天文数字,而其中被功能实验明确标注致病或良性的只占极小比例。解读工具面对的是一个”标注稀缺”的极端不平衡问题,这决定了纯实验路线永远追不上变异产生的速度,计算工具不是可选项,是唯一可规模化的路径。
第二层:机制黑箱。 即使确认某个变异致病,它通过什么分子机制改变蛋白功能,绝大多数情况下也不清楚。知道”哪里坏了”和知道”怎么坏的”是两件事,后者才是药物开发的入口。Gurgis 对这个问题给了一个更大的定位:解决错义变异解读不只是遗传学的事,它逐步关系到整个医学的多个层面——从诊断到药物靶点到治疗策略,机制理解是共同的地基。

PDB 的街道灯问题:结构数据的历史偏向
要用结构解读变异,第一步是拿到蛋白结构。几十年来唯一的系统性来源是蛋白质数据库 PDB(Protein Data Bank)。Gurgis 用了一个精准的比喻:PDB 有”街道灯问题”(street light problem)——你只能在有灯的地方找东西。
PDB 的结构是用实验方法(主要是 X 射线晶体学和冷冻电镜)解析的,解析什么取决于实验可行性和学术兴趣,而不是疾病相关性。结果是覆盖严重偏向:Gurgis 给出了具体数字——跨膜蛋白占人类蛋白组的约 30%,但在 PDB 结构里只占约 2%。这不是小缺口,是系统性盲区:跨膜蛋白恰是药物靶点最富集的类别(受体、通道、转运体都在其中),实验结构的缺位直接拖慢了这类药物的开发。大量疾病相关蛋白根本没有实验结构,结构解读在这些蛋白上此前无从谈起。
AlphaFold 的意义在这个背景下成立:它把结构覆盖从”实验做过的”扩展到”几乎全部已知序列”,让街道灯之外的区域第一次有了光。
AlphaFold3 三阶段管线:输入序列到结构输出
Gurgis 展示了一张从 Alana Pearl 的 GitHub 取来的管线图,把 AlphaFold3 的工作流程拆成三个并发阶段。他特别说明:你不需要懂架构细节就能用好这个工具,但理解管线有助于判断什么时候该信它、什么时候该存疑。
第一阶段:找同源序列。 系统先在数据库里搜索其他物种的同源序列,构建多序列比对(MSA)。同源序列的保守性信息是推断结构的核心证据——一个位置如果在进化里高度保守,大概率对结构或功能关键。
第二阶段:推理结构。 模型整合 MSA 信息和预训练的结构知识,输出每个原子的三维坐标预测,同时给出每个区域的置信度评分(pLDDT)。置信度不是装饰字段——低于阈值的区域要当”没有预测”处理,不能进入变异解读。
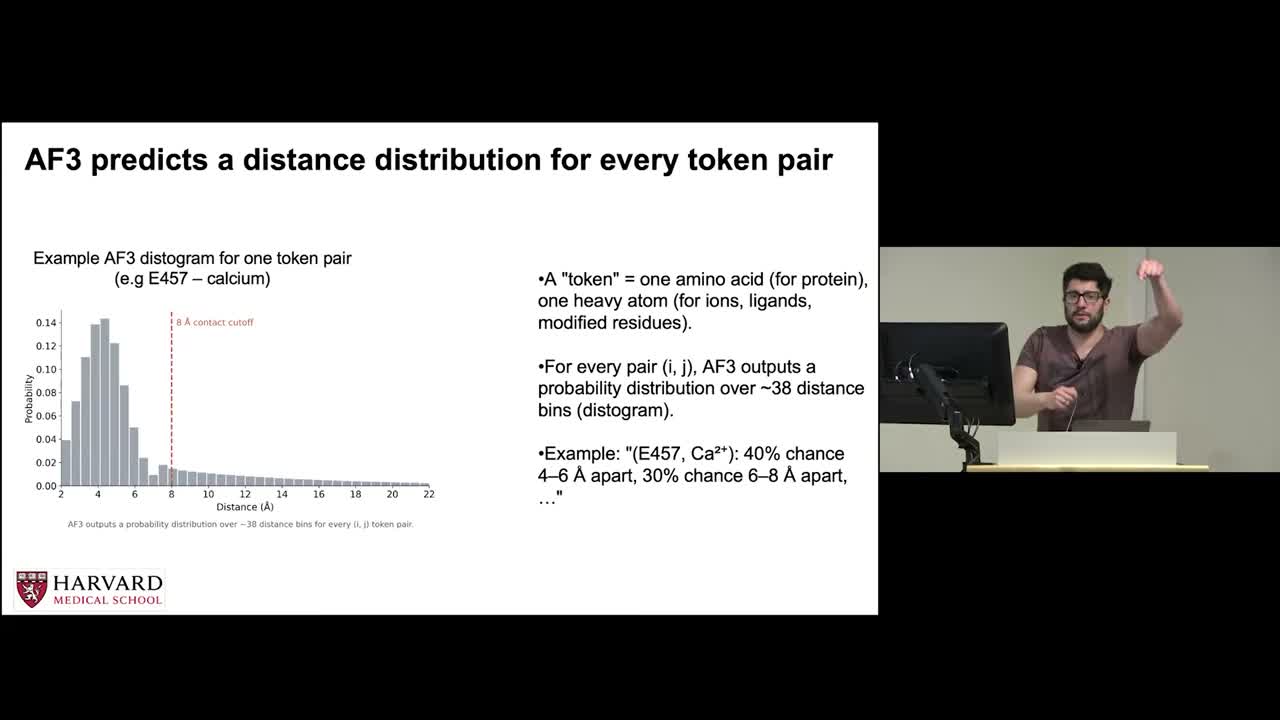
第三阶段:输出复合物。 AlphaFold3 相比前代的重大升级是能预测蛋白-蛋白、蛋白-核酸等复合物结构,这直接打开了相互作用界面变异解读的门。
三阶段并发的架构还有一个容易被忽略的含义:预测的质量依赖第一阶段找到的同源序列数量。对研究得少的蛋白(同源序列稀少),MSA 信息量不足,预测置信度会显著下降。所以判断一次预测能不能用,除了看 pLDDT 分数,还要看这个蛋白的序列”人气”——冷门蛋白的预测要额外谨慎。这解释了为什么 Gurgis 在后面反复强调置信度检查:AlphaFold 的输出永远是”带置信度标注的结构”,不是”保证正确的结构”,两者在使用上有本质区别。
蛋白质语言模型的分歧:工具之间不一致怎么办
课程中段进入工具对比环节,这是全课最有实操价值的部分之一。Gurgis 对比了主流蛋白质语言模型在变异致病性预测上的表现。
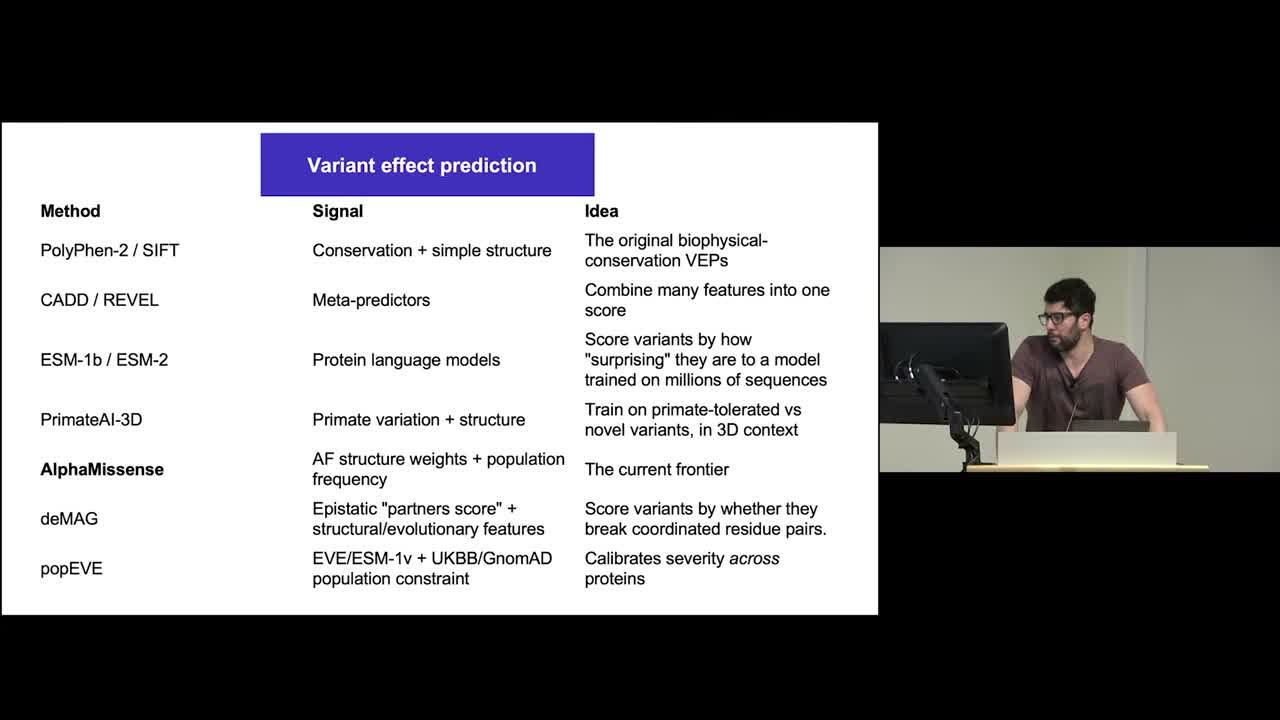
历史脉络是:早期工具(如 MPC)用多个注释源的加权综合打分;新一代工具换成端到端的蛋白质语言模型——ESM1B 直接从序列学习,AlphaMissense 则显式引入蛋白结构信息,还有 PrimateAI-3D 和 DAMD 等。Gurgis 认为 AlphaMissense 目前处于前沿,因为它把 AlphaFold 架构的表征能力用在了变异解读任务上。
这代工具的共同底层逻辑值得展开:蛋白质语言模型本质上是把自然语言处理的预训练思路搬到氨基酸序列上——在海量天然蛋白序列上训练模型预测被遮蔽的氨基酸,训练完成后,模型内部就编码了”什么样的序列模式在真实蛋白里出现过、氨基酸在这个位置出现是否合理”的统计知识。变异致病性判断就变成:把变异前后序列各过一遍模型,看这个位置的”合理性”变化多大。理解这个机制有助于用好它——模型的知识边界是训练数据里的天然序列空间,对人为设计的蛋白或极端罕见的变异模式,它的判断可靠性会下降。
但关键发现是工具间的分歧率:有人对比 ESM1B 和 AlphaMissense 在相同变异集上的判断,两者的共识只有约三分之一——三分之二的情况下两个工具意见不一致。Gurgis 的解读很清醒:分歧不意味着哪个工具差,更可能是它们在看不同的信号(一个看序列上下文,一个看结构约束)。但他给出的操作建议更重要:如果两个独立方法达成一致,这个变异的解读可信度显著上升;不一致时,不要任选其一当结论,要么找第三方法,要么保持 VUS 标注。
这个”分歧即存疑”的原则不限于生物信息学——任何用多个 AI 工具交叉验证结论的场景都适用。两个模型看同一输入给出不同判断,至少说明这个问题处于模型能力边界的模糊区;此时把任何一个模型的输出直接当结论,都是把决策质量押在单次抽样上。
Gurgis 还给了一个评估工具的实用视角:不要问”哪个工具最准”,要问”这个工具看的是什么信号”。ESM1B 看的是序列上下文里氨基酸出现的合理性,AlphaMissense 看的是结构约束下的变异容许度——它们分歧的变异,恰恰是序列视角和结构视角打架的位置,这些变异本身就是值得深挖的研究对象。把工具分歧从”麻烦”重新定义为”信号”,是这堂课最漂亮的一次视角转换。
结构聚类分析:ClinVar 872 个基因的验证
课程后段 Gurgis 展示了结构聚类方法在实际数据上的应用。方法本身不复杂:把同一个蛋白上所有已知致病变异映射到 AlphaFold 预测的三维结构上,观察它们是随机散布还是聚集成簇。如果致病变异在结构空间显著聚类——比如都堆在活性口袋或相互作用界面——这本身就是机制线索:那个区域对这个蛋白的功能执行是关键的。
验证结果来自 ClinVar 数据库的应用:872 个孟德尔疾病基因在 AlphaFold 预测结构上表现出显著的变异聚类。在自闭症、癫痫、精神分裂症等复杂疾病基因中也发现了信号,而且聚类位置与已知功能区域相互印证——致病变异不是随机散布在蛋白表面,而是堆在活性位点、结合界面这类功能要害上。
这个验证的方法论分量要单独说:872 个基因横跨几十种疾病,如果聚类是随机噪声,不可能在这么大的样本上系统性地对齐已知功能区域。它等于用真实疾病数据给”结构聚类=功能要害”这个假设做了大规模背书。此后研究者再在单个新蛋白上看到聚类信号,就有了先验依据去优先做湿实验验证。
这个结果有两层价值。方法论层面,它证明”变异映射到预测结构”这个操作流程能产出可检验的生物学假设;实操层面,它给了研究者一个低门槛入口——不需要做湿实验,就能从公共变异数据库和 AlphaFold 预测里生成候选机制假设,再挑最有把握的拿去实验验证。
完整案例拆解:ATP2B2 钙泵蛋白
Gurgis 用自己论文里的 ATP2B2 案例把整个流程走了一遍,这是全课最值得逐句抄的部分。
为什么选这个蛋白:ATP2B2 是神经元钙稳态的关键泵蛋白,把钙离子泵出细胞外,对维持神经元的钙敏感性和稳态至关重要,蛋白家族的功能研究基础扎实。更吸引人的是它与精神分裂症和自闭症两个表型的关联几乎全部由错义变异驱动,而不是蛋白截断变异(PTV)——这暗示致病机制在结构微调层面,正是结构分析的主场。
操作步骤(全程无需湿实验):
- 用 AlphaFold 生成预测结构,只需几分钟
- 计算结构中每对原子间的最小距离,生成全原子距离矩阵
- 把精神分裂症病例变异、对照变异和部分新生变异映射到结构上
- 以每个带变异的残基为球心画 15 埃半径的邻域球
- 用 Fisher 精确检验比较球内病例变异与对照组变异的富集度
结果:以氨基酸位置为横轴、p 值为纵轴画出的”曼哈顿图”显示多个显著聚类峰。其中一个热点残基恰好位于泵孔道内——这个位置的功能意义不言自明。更硬的数据是:一个仅覆盖蛋白小区段的 50 埃球内,病例变异数超过对照组两倍以上。红色(精神分裂症病例)、绿色(对照)、橙色(自闭症)的变异分布图直观展示了病例变异向功能区域集中的模式。
这个案例的复现门槛极低:公共变异集、AlphaFold 免费预测、距离矩阵和统计检验都是标准计算。它示范的是”AI 预测结构 + 公共遗传数据 + 简单统计”这套组合拳的产出能力。

相互作用界面:被忽视的致病机制富集区
Gurgis 用课程尾段讲了蛋白-蛋白相互作用(PPI)界面这个此前被系统性低估的方向。数据触目惊心:全部 PPI 里只有约 9% 有实验解析的结构模型。而大量疾病突变恰恰落在相互作用界面上——单个蛋白内部结构看着正常,一旦和搭档蛋白结合的界面坏了,功能照样丧失。
这正是 AlphaFold3 复合物预测能力的用武之地:把两个蛋白放一起预测复合物结构,检查变异是否落在界面区域。Gurgis 坦承这不是他本人的主攻方向,但作为综述性介绍,他给出的是领域地图:界面变异解读是结构预测工具打开的新前沿,工具已备好,方法正在形成。
从工具选型角度,这节课实际上给出了一条决策树:解读单个蛋白内部的变异,用单体结构预测加变异映射;怀疑变异影响蛋白间结合,上复合物预测;需要动态构象信息,只能转向分子动力学模拟并接受周级的计算成本;判断变异致病性,至少跑两个独立工具(一个序列派一个结构派)看分歧。每一层的成本和产出都不同,按问题层级选工具,而不是无脑上最贵的。
现场问答:从工具到实践的落地细节
问答环节的两个 exchange 值得记录。
提问一:隐性遗传的建模。 有听众注意到 Gurgis 提到的部分变异按群体频率(gnomAD)定义,问是否存在按遗传模式(显性/隐性)分层的建模思路。Gurgis 的回答展示了这个领域的实际复杂度:频率阈值在不同遗传模式下确实应该不同,但多数工具还没有系统性地把遗传模式作为先验整合进打分。这意味着使用者需要自己做分层判断——显性遗传病里高频率的变异更可能是良性,隐性遗传病的容忍度完全不同,把 gnomAD 频率当统一阈值用是常见误操作。
追问:约束度量与结构聚类的关系。 另一位听众问经典氨基酸约束度量与结构聚类观察是否相关。Gurgis 承认两者的整合仍是开放问题——序列约束和结构聚类是两条独立证据链,目前没有统一框架把它们合并成一个综合致病性评分。对使用者来说这又是一个”分歧信号”:序列说高度约束、结构却看不到聚类(或反过来)的变异,值得单独标记而不是平均掉。
提问二:从变异到表型的追溯路径。 另一位研究者问怎么把找到的候选变异跟具体表型关联起来。Gurgis 给的路径很务实:先在具体病例上做变异-表型匹配初筛,匹配上了再把变异映射到蛋白结构上做机制层面的定位——“你得对找到的蛋白相当了解,去读那个蛋白的相关文献”。这句话戳中了 AI 工具使用的一个常被忽略的真相:工具输出的是坐标和分数,把它们变成生物学结论,仍然需要领域文献的深度阅读。AI 压缩的是计算步骤,不是知识判断。
追问:构象变化和多变异位点怎么处理。 有听众问蛋白相互作用后构象变化的预测,以及同一残基上多个不同变异的取舍。第一个问题 Gurgis 答得很诚实:AlphaFold 擅长给静态结构,构象变化预测不是它的强项,要做得转分子动力学模拟——代价是计算时间以周计,比 AlphaFold 的几分钟贵几个数量级,但两类方法可以组合使用。第二个问题他的回答干脆:同一残基上的多个变异都测,不要预先挑选。

拿来就能用的三件事
如果你做变异解读:ESM1B 和 AlphaMissense 的分歧率约三分之二,单工具结论不能直接用;双工具一致时可信度显著上升,分歧时保持 VUS 或引入第三方法。
如果你评估结构预测:pLDDT 置信度低于阈值的区域按”无预测”处理;跨膜蛋白等 PDB 弱覆盖类别,AlphaFold 预测的价值最高;相互作用界面变异要用复合物预测,不能用单体结构;冷门蛋白(同源序列少)的预测整体降一级信任。
如果你要用 AlphaFold 但担心成本:Gurgis 的案例给出了成本参照——单次结构预测分钟级完成,结构聚类分析全程无湿实验,唯一的重计算(分子动力学模拟)只在需要动态构象时才上。对预算有限的团队,“预测结构+公共数据+统计检验”这条路径几乎是零成本起步。
如果你设计分析管线:变异-结构聚类是低成本高回报的机制假设生成器——公共变异数据加 AlphaFold 预测,零湿实验成本产出可检验假设,再按把握度排序投入实验验证。
原文信息
- 原视频标题:MPG Primer: From Genetic Variation to Biological Mechanism With AlphaFold3 (2026)
- 频道:Broad Institute
- 讲者:Sherif Gurgis(Broad 研究所博士后,哈佛博士,师从 Mark Daly 与 Steve McCarroll)
- 发布日期:2026-06-09
- 视频时长:51 分钟
暂无评论,快来抢沙发~