BestBlogs早报·04-10|Anthropic顾问策略Opus给Sonnet做参谋,通义VimRAG记忆图,ChatGPT百元档位
一句话结论
本日十条内容收敛为两条主线:一是 AI 基础设施的工程化集体提速——Anthropic 顾问策略、MiniMax MMX-CLI、LangChain Deep Agents Deploy 三家同时给生产级 Agent 补工程短板;二是行业开始认真重算 AI 这笔账——腾讯研究院 Token 经济学、Karpathy 认知鸿沟、大疆汪滔创业反思从三个视角审视同一轮变革。对开发者最有即时价值的是 Anthropic 顾问策略与通义 VimRAG:前者是可直接落地的成本优化方案,后者是多模态 RAG 的新起点。
导语
今天的十条内容看下来有两条主线特别清楚。第一条是 AI 基础设施的工程化在集体提速。Anthropic 发布了顾问工具,MiniMax 发布了 MMX-CLI,LangChain 发布了 Deep Agents Deploy,三家公司都在给生产级 Agent 补工程短板,给出的答案各有侧重但都很实用。第二条主线是大家开始认真重新算 AI 这笔账。腾讯研究院的 Token 经济学长文、Karpathy 对认知鸿沟的观察、还有大疆创始人汪滔的创业反思,三个完全不同的视角在聊同一件事,就是我们到底应该怎么理解这一轮 AI 变革。
本期挑了四条展开:Anthropic 的顾问策略、通义实验室的 VimRAG、OpenAI 新出的 100 美元档位,还有腾讯研究院的 Token 经济学七问。剩下的六条会在后面做一次速览。

一、Anthropic 顾问策略:让 Sonnet 用 Opus 做参谋
Anthropic 官方博客发布的顾问策略,标题是用 Opus 给 Sonnet 做顾问来提升智能水平。这篇发布后引发不少讨论,因为它直接把很多 Agent 开发者都在用的土办法,规范化成了一个官方的 API 工具。

先说背景。过去做 Agent 编排,最常见的模式是大模型当指挥,把任务拆成小块派发给小模型去执行。听起来挺合理,但实操下来有个问题:指挥的成本很高,每一轮都要加载全部上下文,而大部分简单决策其实根本用不上大模型的推理深度。
Anthropic 这次把思路倒过来了。他们让 Sonnet 或者 Haiku 全程驱动任务,从头到尾都是这个小模型在跑,调工具、读结果、自己往前推。只有遇到自己判断不了的复杂决策点,才去叫 Opus 来当顾问。顾问看一眼当前上下文,返回一个计划、一个修正或者一个停止信号,执行者继续往下跑。顾问本身不调用工具,也不产生面向用户的输出,就是一个聪明的参谋。
这个策略的效果是说服力的关键:
- Sonnet 加 Opus 顾问,在 SWE-bench 软件工程多语言基准上比 Sonnet 单跑提升了 2.7 个百分点,同时每个任务的成本下降了 11.9%
- Haiku 加 Opus 顾问,在 BrowseComp 网页浏览任务上,分数从 19.7% 直接翻倍到 41.2%
- 和 Sonnet 单跑比,Haiku 加顾问这个组合的性能只落后 29%,但成本只有前者的 15%
对那些需要高质量输出但又有预算压力的场景,这个性价比很有吸引力。
这个工具已经集成进 Messages API 了,一次请求就能完成整个任务移交,不用自己管上下文。而且内置了 max_uses 这个参数,用来控制顾问被叫几次,避免失控。顾问和执行者的 Token 消耗是分开计费的,账单也清楚。做过 Agent 的人应该都会想立即试试这个,尤其是那些有成本压力的生产场景。
二、通义 VimRAG:把多模态 RAG 的线性历史换成记忆图
通义实验室开源的 VimRAG,是针对图文视频三种形态的混合知识库检索框架。这一条是今天最值得技术团队关注的工作。

先把背景说清楚。RAG 就是检索增强生成,是现在大模型接入外部知识最常用的方案。但传统 RAG 处理纯文本还行,一遇到图片和视频混合的知识库就容易出问题。原因在于传统 Agent 的上下文是线性历史:你检索一轮,把结果塞进去,再检索下一轮,就这么一直往后摞。这个模式处理多模态内容的时候会产生一种现象,通义实验室把它叫做状态盲区——Agent 自己搞不清楚已经看过什么、哪条路走通了、哪条路是死胡同,结果就是重复生成相似的查询,原地打转。
VimRAG 的做法是把线性历史换成一张动态记忆图 DAG(有向无环图)。图里每个节点包含文本摘要、视觉证据、拓扑位置,Agent 每做一次动作之前都要重新看一遍这张图。好处是 Agent 能清晰区分探索性搜索和结论性验证,碰到死胡同会自动剪枝,不会卡在原地循环。
这套框架还有两个设计相当巧妙:
- 视觉能量分配:核心节点保留高清视觉 Token,边缘节点降级为文字描述甚至直接剪掉,在长上下文里省 Token
- 图引导策略优化 GGPO:训练的时候不再是最终答案对错一刀切,而是基于图拓扑精确回溯。正样本中剪掉没贡献的死胡同,负样本中保护那些检索动作有效但最终答错的节点
这个思路让模型能更快学到结构化的记忆逻辑。这篇论文已经挂到 arxiv 上了,通义实验室的官方账号也正式宣布了。在 Qwen3-VL 这类视觉模型上,VimRAG 在多个多模态 RAG 基准上达到了 SOTA 水平,也就是当前最佳。对做企业知识库、文档问答、视频理解这些方向的朋友,这是一个可以立即看看的框架。
三、ChatGPT Pro 100 美元档位:OpenAI 直面 Claude Code
OpenAI 正式推出了一个新的 ChatGPT 订阅档位,每月 100 美元。Sam Altman 本人发了条推文说这是应广大用户要求,特别是因为 Codex 的反响太好。
这条推文值得展开聊,因为它背后的信号量很大。先把事实说清楚:
- OpenAI 原来的价格结构是 Plus 每月 20 美元、Pro 每月 200 美元,中间有一个巨大的空档
- 这次新出的 100 美元档位刚好填进去
- 新档位比 Plus 多 5 倍的 Codex 使用额度,包含 Pro 模型,无限使用 Instant 和 Thinking 模型
- 到 5 月 31 号之前,新订阅用户还能享受 10 倍额度的促销
这里面有几个点值得说。第一,Codex 用户增长非常快。这个产品现在有 300 多万活跃用户,过去三个月涨了 5 倍,月增长 70%。OpenAI 自己也说这个定价是专门针对 Codex 的重度用户。第二,这次定价是冲着 Anthropic 的 Claude Code 去的。TechCrunch 和 CNBC 的分析都指出了这一点。Anthropic 的 100 美元 Max 计划已经存在很久了,开发者里反响不错,OpenAI 这次等于是跟进。第三,OpenAI 内部其实一直在重新思考定价策略。之前有员工说原来的结构是意外形成的,从 20 美元直接跳到 200 美元跨度太大,新档位等于是一次正式纠偏。
这个定价反映了一个更深层的变化:AI 编程工具已经从实验阶段走到了真有重度付费意愿的阶段。300 万 Codex 用户、5 倍的三个月增长,说明这批人是真的在用。而且愿意从 20 美元升到 100 美元的人,基本都是每天 8 个小时跟 AI 一起写代码的开发者。这类用户的特点是额度比模型能力更敏感,谁给的调用次数多就用谁。
四、腾讯研究院 Token 经济学:AI 产业的新度量衡
腾讯研究院发的 Token 经济学七问,是一份关于 AI 新经济的入门地图。挑几个最有意思的点来讲,正好能和前面 ChatGPT Pro 那条串起来。
文章的核心类比是把 Token 定义为 AI 时代的语言和货币,就像电力时代的千瓦时。作者认为 Token 的意义不只是一个技术计量单位,而是贯穿 AI 产业链五层架构的统一度量衡:能源、芯片、基础设施、模型、应用。从这个视角看,整个 AI 产业的效率、成本、收入都可以用 Token 来对齐。

最反直觉的一个发现是这句话:不到 5% 的 Token 消耗,创造了超过 80% 的可测量价值。也就是说 Token 的价值是极端分层的。同样一个 Token,用在法律、科研这些高价值场景里可能值几百块,用在闲聊里就一分钱都不值。这个价差可以到 10 万倍,是和传统生产要素完全不一样的特性。
第二个点是杰文斯悖论。这是个经典的经济学概念,原来讲的是蒸汽机效率越高,煤炭消耗反而越大。作者把它套到 Token 上,指出 Token 越便宜,全世界在 Token 上花的钱反而越多。中国日均 Token 调用量从 2024 年初的 1000 亿,到 2026 年 3 月已经突破了 140 万亿,两年增长超过一千倍。价格在降,总开支在涨,这就是杰文斯悖论的现实版本。
第三个点和 Karpathy 那条推文可以对照着看。作者指出,Token 消耗正在从人类注意力驱动转向 Agent 自主驱动。过去 Token 的消耗受限于人能看多少、能打多少字,现在智能体可以 24 小时自己跑、自己调 API,这个天花板被彻底打破了。Token 消耗量会进入下一个量级的爆发期。
文章最后还讨论了中国模型的全球竞争优势:以 DeepSeek 为代表,MoE 架构让推理成本出现了指数级下降。作者把这个叫做算法出海——中国 AI 的优势不在资源投入,而在算法效率。
读完的整体感受是,Token 这个词已经不只是技术术语了,它正在变成一种新的宏观经济指标。作者最后提的问题很有意思:Token 消耗能不能像用电量一样,成为衡量一个经济体 AI 化程度的先行信号?这个问题现在没有答案,但值得持续观察。
速览:今日其他六条

LangChain 发布 Deep Agents Deploy。这个产品把自己定位成 Claude 官方托管智能体的开源替代方案,和 Anthropic 的专有方案最大的区别是模型无关,基于 AGENTS.md 配置文件、MCP 模型上下文协议、智能体协议这些开放标准构建。LangChain 强调的核心概念叫记忆所有权——封闭平台会把用户数据锁在专有 API 后面,开发者拿不到长期学习的数据飞轮,Deep Agents Deploy 想让开发者自己掌控智能体的记忆和数据。这个定位和开源 RAG 框架的诉求一脉相承,值得关注开源 Agent 的朋友看一眼。
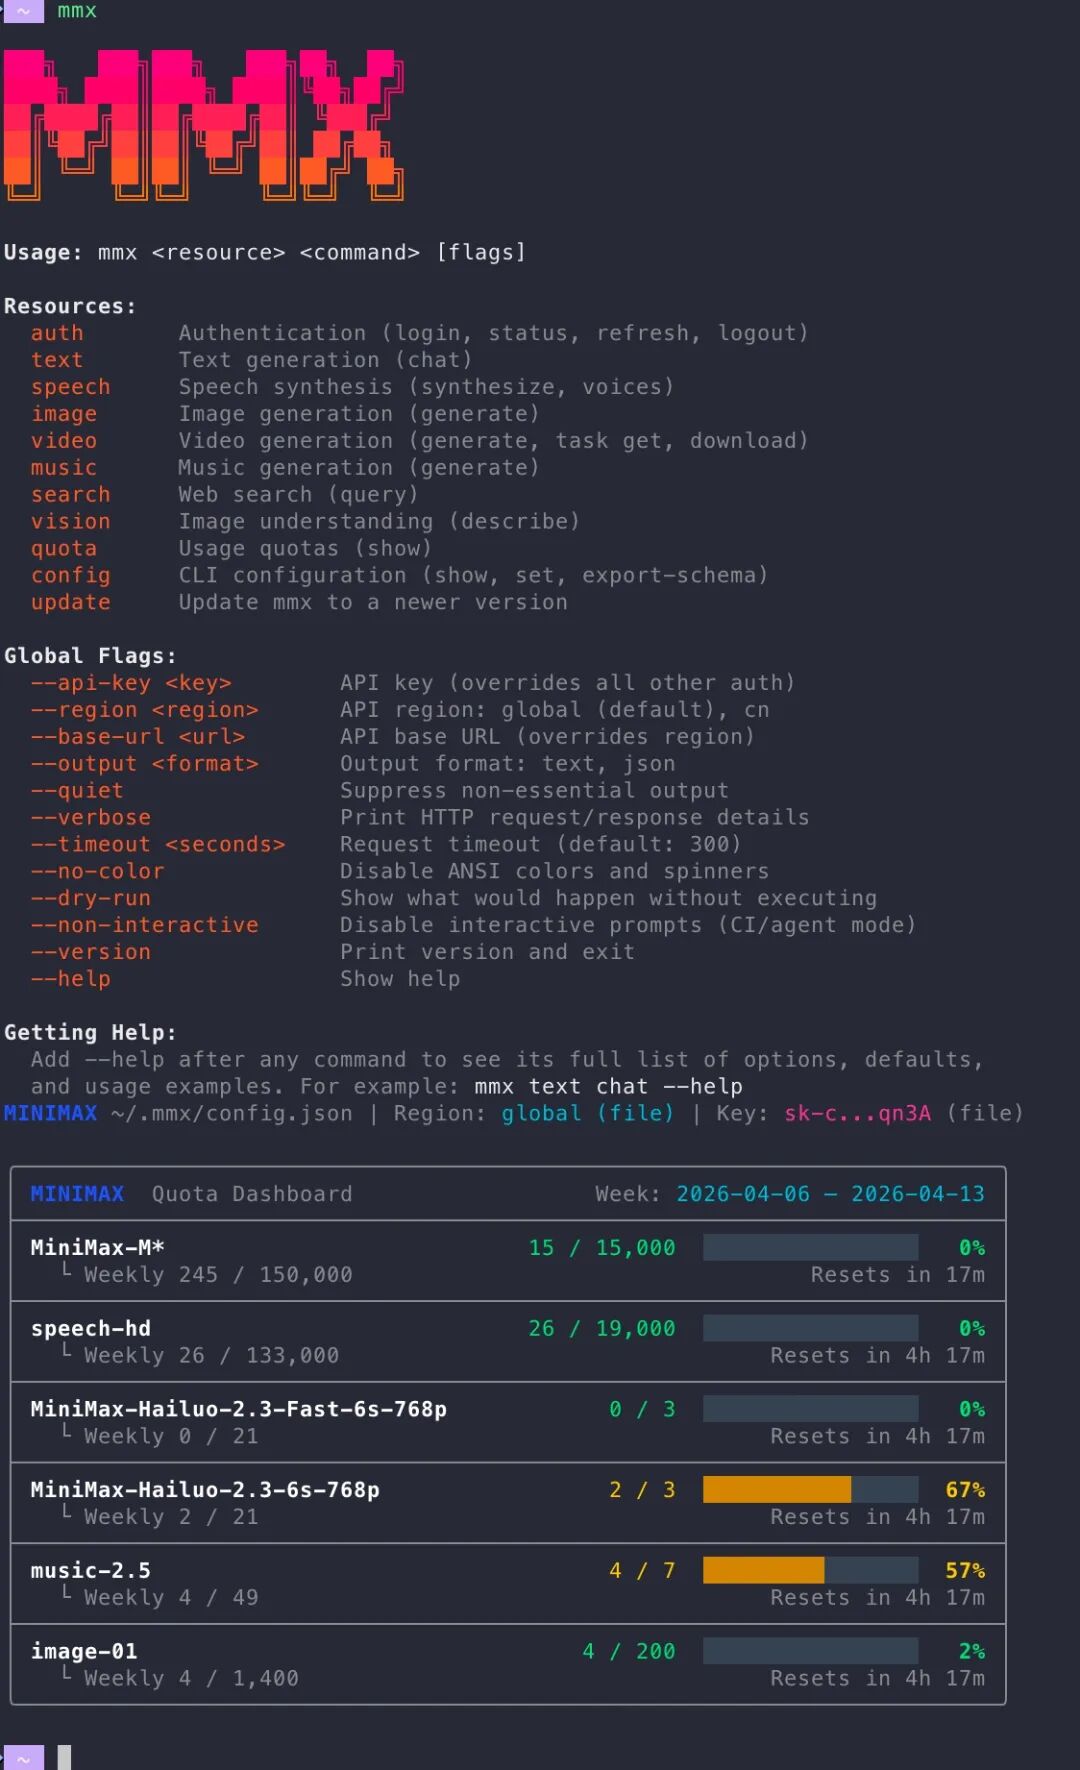
MiniMax 发布 MMX-CLI。这是一个专门为 Agent 设计的全模态命令行工具,意思是 AI 的编程、视频生成、语音合成、音乐创作这些能力都变成命令行指令,Agent 可以像用 ls 或者 grep 一样直接调。它针对 Agent 的自动化运行做了几个专门优化:输出隔离保证数据纯净、语义化的退出码简化错误处理、异步模式支持多任务并行。核心目标是让 Agent 能独立完成从资料搜集到视频制作的全链路自动化工作流。
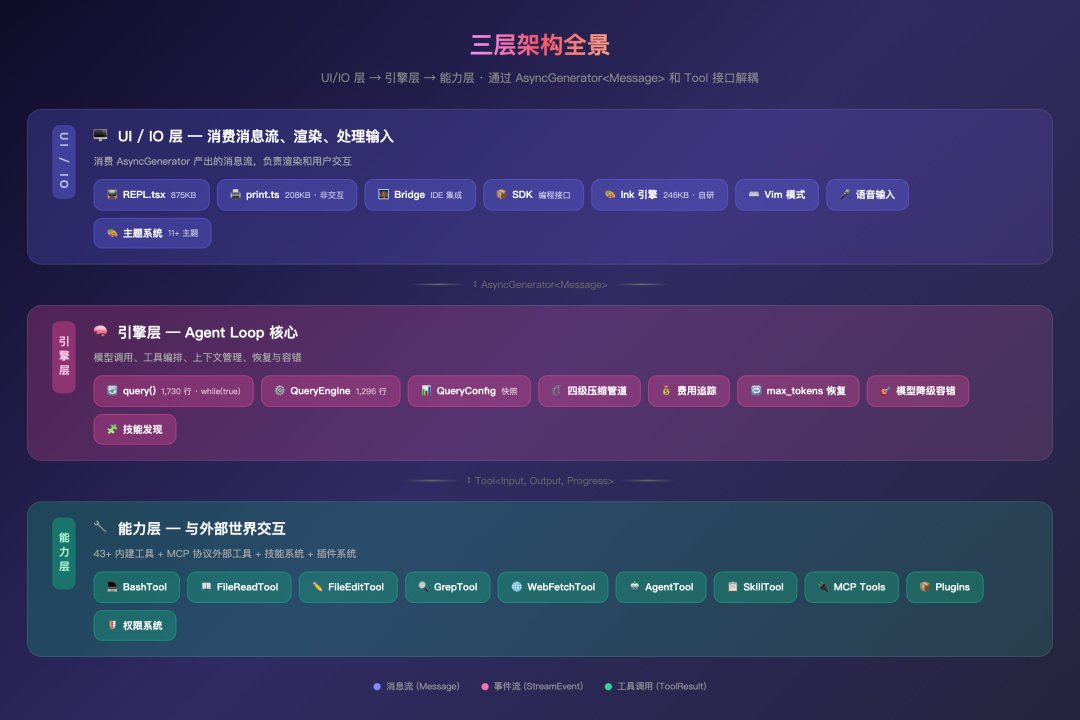
腾讯技术工程:顶级开发团队设计的 Harness 工程源码审计。他们对一个基于 TypeScript + Bun 的超大规模 AI 编程智能体做了全方位分析,规模是 1900 个文件、51 万行代码。几个值得看的亮点:Bun 并行预取实现亚秒级启动、异步生成器驱动的四级上下文压缩循环、支持多智能体编排的任务管理系统。这篇文章定位是 Harness 工程范式的实战指南,适合想自己搭生产级 Agent 框架的技术团队做参考。
Karpathy 谈 AI 能力认知鸿沟。他分析了公众对 AI 看法为什么越来越两极化,两个原因:一是很多人基于过时或免费版模型形成判断,根本没见过 Codex 和 Claude Code 这些最新系统的能力;二是 AI 的进步是尖峰式的,集中在编程和数学这种有可验证奖励函数的领域。亲眼看到前沿智能体自主解决复杂工程问题的人,会产生一种 Karpathy 称之为 AI 心理震撼的体验,而没见过的人完全理解不了这种感受。这个观察和今天精讲的 Token 经济学那条可以对照着看,都是在讨论 AI 变革的认知层面。

《晚点 LatePost》对话大疆汪滔:求真理、得自由、活成故事。汪滔反思了自己从早期觉得世界蠢得不可思议的狂傲,到经历团队危机后的深刻转变。他提出了一个管理学的熵减理论,认为管理比产品研发难度高十倍,分享了从个人英雄主义向系统驱动型组织转型的阵痛。访谈还聊了大疆在无人机、影像、机器人领域的战略布局,以及对创新和人才培养的新认知。和前面几条 AI 技术文章不同,这是一篇人物特写,如果你对创业和管理感兴趣,值得看。
Hex 构建 AI 数据智能体。LangChain 发的一个视频,Hex 的 AI 工程师 Izzy Miller 分享他们怎么构建数据智能体。核心洞察是数据分析的正确性是模糊的,不像代码有明确的对错。他介绍了 Hex 内部的评估系统 Shoe box(鞋盒),以及一项 90 天的模拟实验,测试智能体如何在长周期里积累专业直觉。这个视频的价值在于,它揭示了人在回路反馈系统对保持数据准确性的重要性,对做数据类 Agent 的团队启发很大。
今日阅读路径
时间有限?推荐优先读这三篇:
- 精讲一:Anthropic 顾问策略——如果你在今天只有时间看一条,看这条。它是一个立刻能用在生产环境的成本优化方案,SWE-bench 提升 2.7 分、成本反降 11.9%,一次 API 请求就能完成模型分工。
- 精讲二:通义 VimRAG——如果你在做多模态知识库或文档问答,这是方向性框架,动态记忆图 DAG 替代线性历史的设计可以直接借鉴。
- 精讲四:Token 经济学七问——如果只有时间看一篇长文,选这篇。它能帮你建立一个理解整个 AI 产业的新框架,5% Token 创造 80% 价值的分层规律尤其值得记住。
原文信息
原文地址:
- 作者:BestBlogs(@hongming731),BestBlogs.dev 主理人,AI 驱动内容精选服务
- 发布时间:2026-04-10
- 来源:X Article
暂无评论,快来抢沙发~