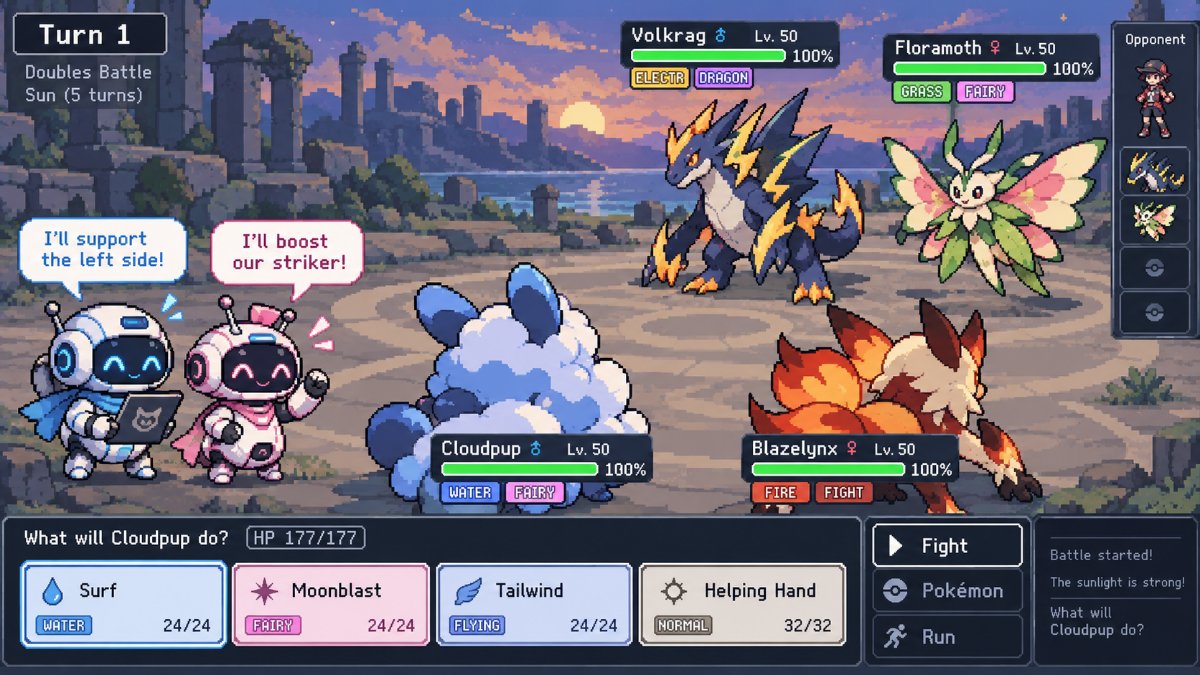
宝可梦 2v2 对战环境中的多智能体 LLM 协同
📌 One-Sentence Summary
本研究考察了大型语言模型智能体在宝可梦 2v2 对战中的协同与沟通能力,发现自由交流能显著提高对阵最大伤害机器人时的胜率,但也会增加计算成本。
📝 Summary
本研究在 Pokémon Showdown 的 2v2 模式中,让 Qwen3.8-27B 智能体组成的队伍对阵最大伤害机器人,以此评估多智能体协同能力。结果显示,能够自由交流的智能体胜率为 64%,而无法交流的智能体胜率仅为 42%。研究还利用该环境对模型表现进行基准测试,发现 Qwen3.8-27B 队伍的胜率较高,表现优于较小的模型队伍(Qwen3.5-2B 和 Qwen3.5-9B)。
💡 Main Points
交流能提升协同能力
允许智能体自由交流时,胜率为 64%,显著高于无法交流时的 42%,也高于只能有限交流时的 52%,这表明对话对于有效执行策略至关重要。
交流的成本
自由交流虽然能提升表现,但与无法交流相比,计算成本也增加了 3.8x,因为每条消息都要求模型重新读取完整的对战记录和对话历史。
区分不同模型的能力
该环境能够有效区分不同规模的模型:Qwen3.8-27B 队伍对阵 Qwen3.5-2B 队伍时胜率为 96%,对阵 Qwen3.5-9B 队伍时胜率为 74%,这证实了该基准测试能够灵敏反映模型质量差异。
💬 Key Quotes
未来属于 LLM 协作,因此我们需要了解智能体在协同工作、沟通和协商行动方面的能力。
📊 Article Meta
AI Screening: 85
Source: Hacker News - Newest: "LLM"
Author: grabnero
Category: 人工智能
Language: 英文
Read Time: 3 min
Word Count: 743
Tags:
AI 与智能应用 , 强化学习 , AI Agent , Agent编排 , 模型评测与基准
支持作者,持续关注中。
有没有更详细的教程,期待后续。
赞同,实践出真知。
内容翔实,正好需要,先收藏再看。
看标题就点进来了,内容果然没让人失望。
有没有更详细的教程,期待后续。
写得挺用心的,支持一下。
支持作者,持续关注中。
赞同,实践出真知。
路过
收藏了,以后慢慢研究。
支持作者,持续关注中。