BabelDOC 把 PDF 翻译做成了 ACL 论文:中间表示如何保住公式、表格和排版
今天,想和大家分享一个对沉浸式翻译团队非常重要的阶段性进展:BabelDOC 的 ACL 2026 System Demonstrations 论文已发布在 arXiv。
论文标题是:BabelDOC: Better Layout-Preserving PDF Translation via Intermediate Representation
我们讨论的并非某个悬在半空的学术猜想,而是无数沉浸式翻译用户每天都在经历的真实痛点:如何真正做好一份 PDF 的翻译?
无论你是需要死磕全英文学术期刊的学生,面对满屏 API 说明的开发者,还是每天处理复杂双栏报告、术语密集的专利白皮书的研究员——我们面临的痛点是相通的:这些文档,从来都不是纯文本。
AI 翻译工具拿到这种文档,任务往往在第一步就卡住:怎么把语言模型生成的译文,重新放回原来的版面里。
PDF 翻译的核心挑战,绝非简单的”把英文换成中文”。真正让人头痛的是:翻译完之后,这篇文档还能不能正常阅读?
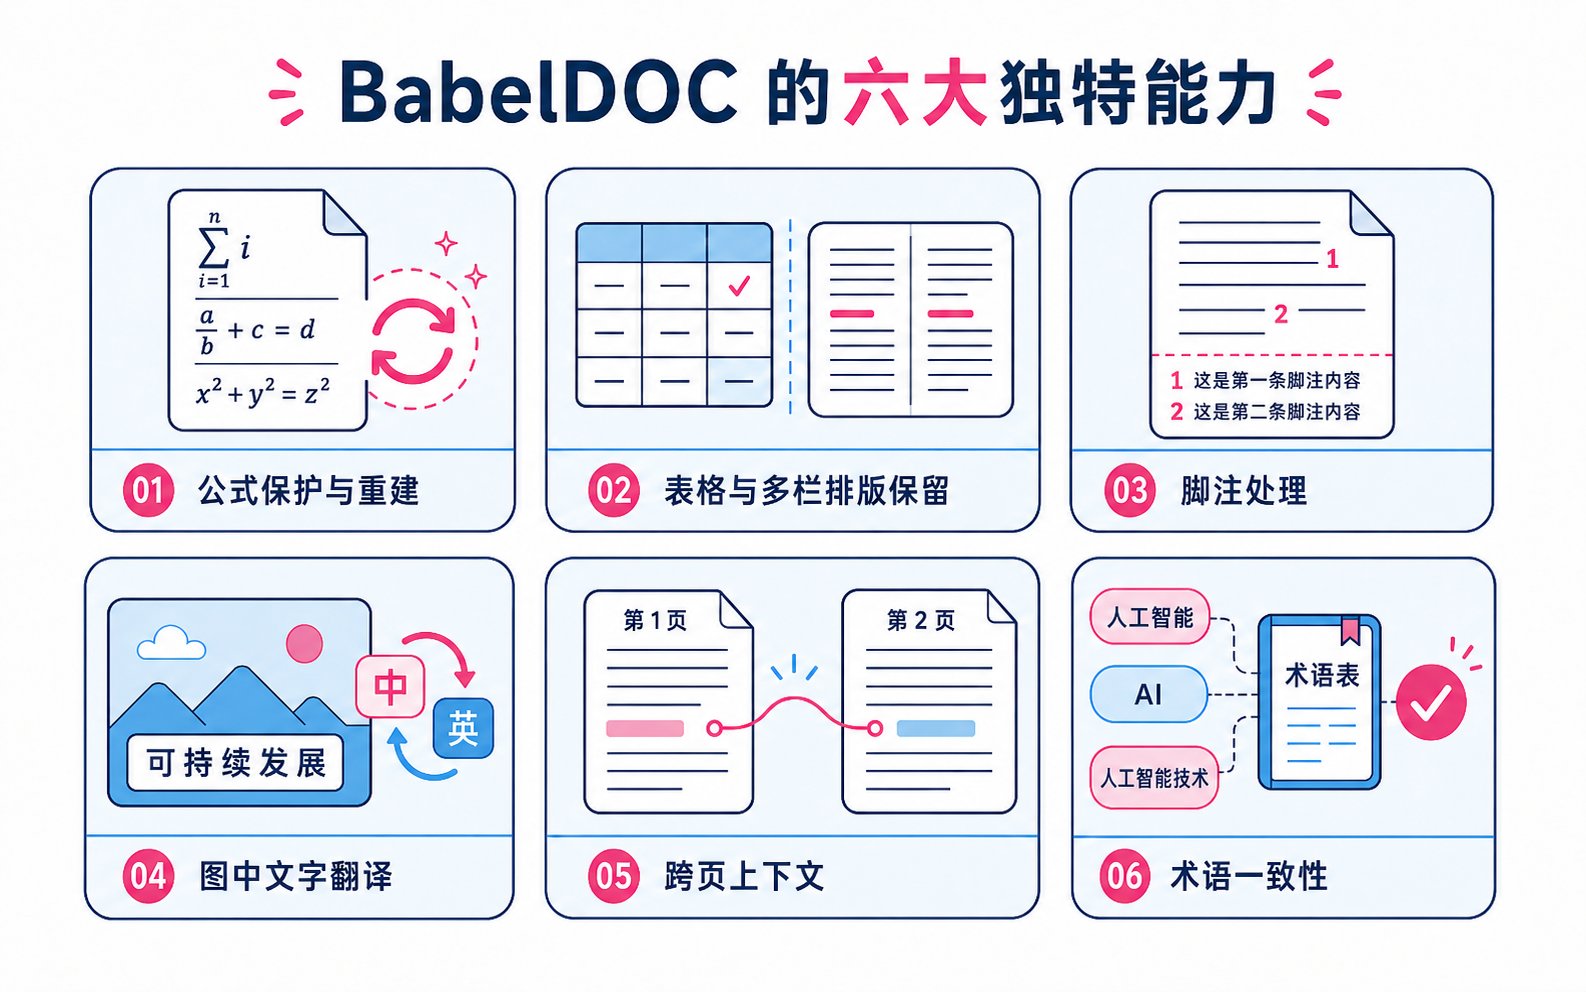
- 公式还在不在原位?
- 复杂表格仍是 PDF 翻译中的难点,翻译后能否尽量避免变形?
- 能否尽量保留和翻译可识别的脚注文本?
- 能否支持处理 PDF 中可抽取的图内文字或图注?
- 跨页的多栏排版会不会像面条一样串行?
- 译文变长后,还能不能尽可能自适应地贴合原来的页面空间?
这就是 BabelDOC 诞生的全部理由,也是我们死磕到底的方向。

BabelDOC 论文入选 ACL 2026 System Demonstrations
从交出”产品答卷”,到开源”底层图纸”
大家可能还记得,我们去年发布过一篇技术解析《BabelDOC:极致PDF翻译体验是这样打造的》(注:此处为历史文章标题)。当时我们写过一句话:“当专业 PDF 遇到机器翻译,信息完整性很容易受损。”
当时,我们更多是在用产品经理和工程师的视角,解答 BabelDOC 是如何解决这些糟糕体验的。而这一次,我们把这套体验背后的”底层设计图纸”进行了系统化,并向整个开源和学术社区公开。
为什么 PDF 翻译这么难?因为它是一张被”画”出来的纸
从技术的视角来看,PDF 根本不是一篇文章,而更像是一张被程序精确绘制出来的视觉画布。
它只关心一个字应该被”画”在屏幕的哪个坐标上,用多大的字号,和旁边的图形保持几毫米的距离。我们之前把它比作”一张充满二进制代码和文本的纸”,它的首要目标是稳定显示,而不是让你去编辑和翻译。
这就导致了一个存在已久的行业两难:
- 传统翻译工具擅长处理流动的自然语言,但拿到 PDF 后,很容易把精心设计的文档结构破坏掉。
- 文档解析系统擅长把 PDF 抽离成 Markdown 或结构化文本,但翻译完之后,想再把中文准确地放回原位,往往困难重重。
要么翻译顺畅但版式错乱,要么版式保留了但翻译生硬。BabelDOC 决定打破这个僵局。

核心解法:欢迎来到 BabelDOC 的”无尘拆解车间”
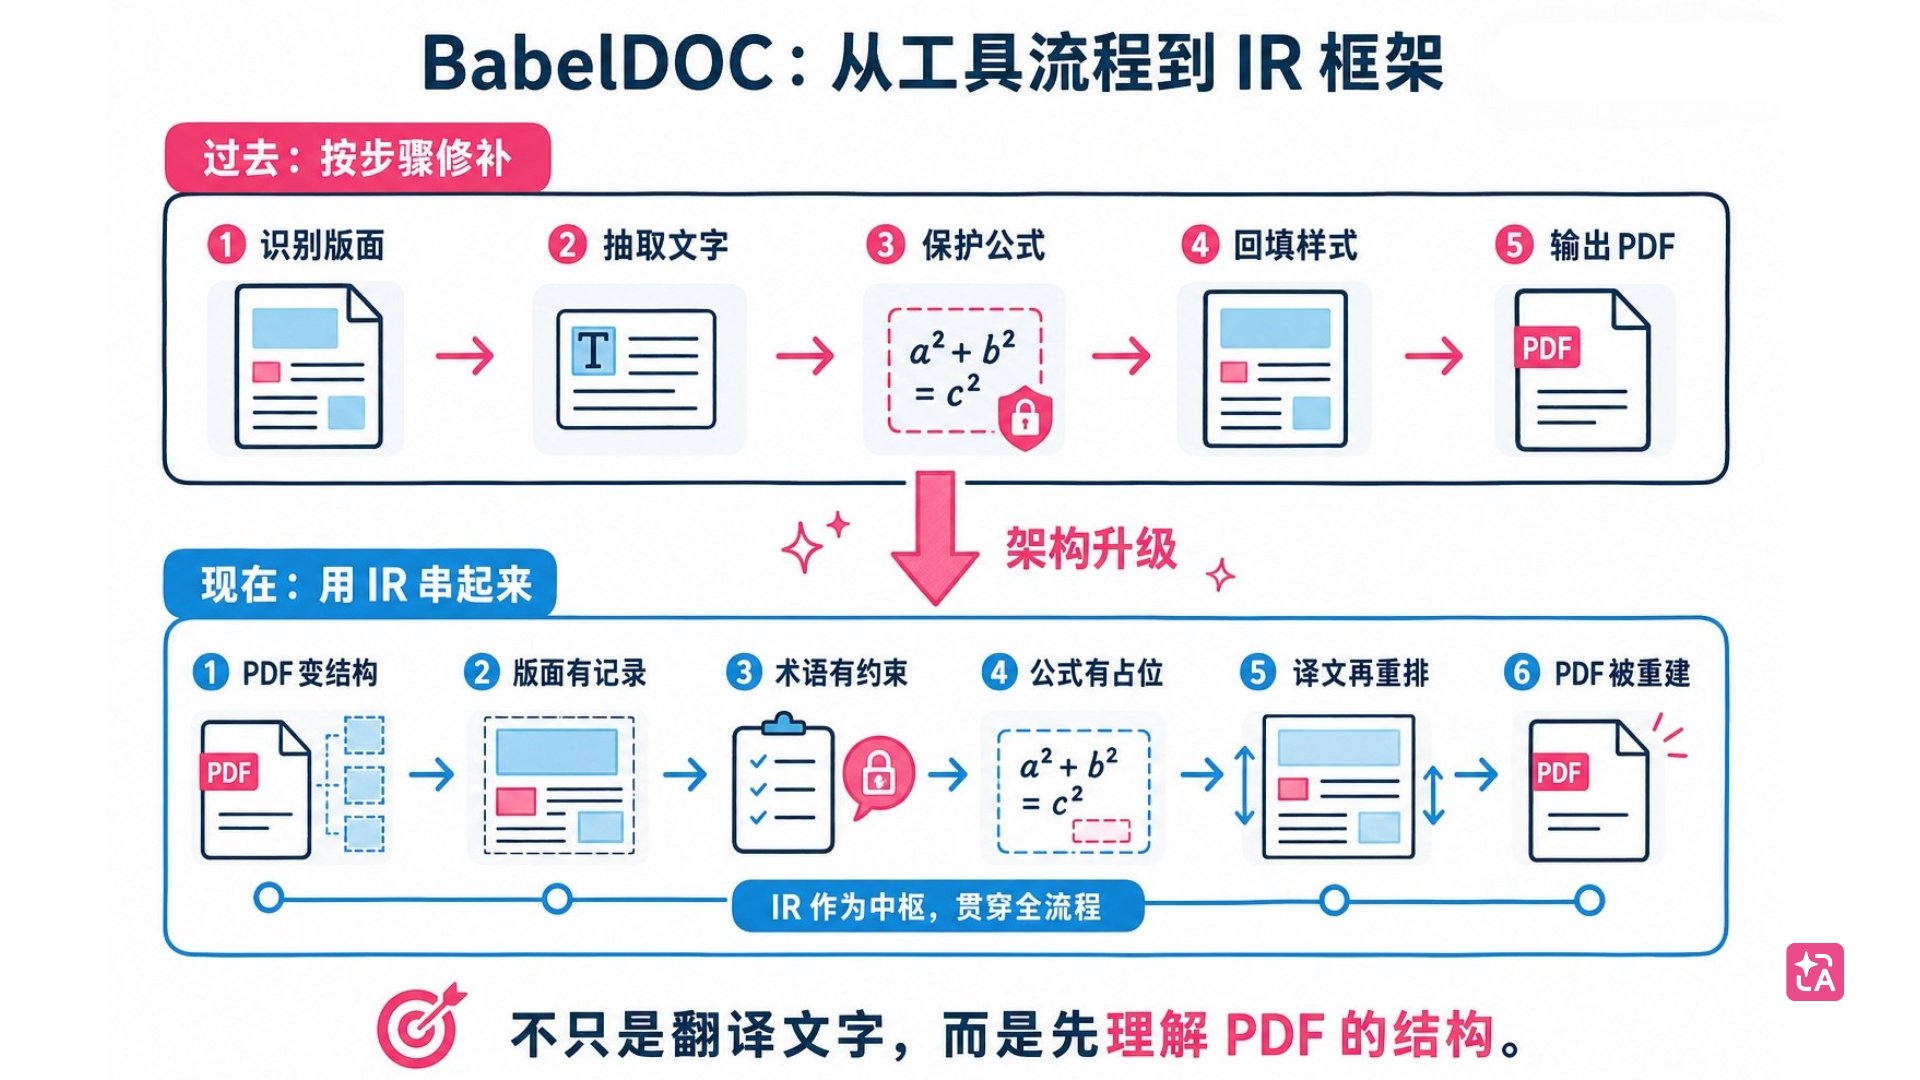
BabelDOC 的核心突破,在于论文中提出的一个关键概念:Intermediate Representation(中间表示,简称 IR)。
为了不让大家被学术名词绕晕,我们不妨把 BabelDOC 想象成一个高度精密的多语言”无尘拆解车间”。
我们不会把一整块 PDF 粗暴地塞进翻译机。相反,BabelDOC 会先用结构化的方式,将 PDF 进行拆解,通过 IR 解耦语义内容和视觉版式信息:
- “语义零件”: 把字符、文本行、段落线索、版面坐标、公式等结构片段拆下来,送进 IR”流水线”。
- “视觉骨架”: 把坐标、字体、文本框、图形区域、多栏布局等内容妥善封存保护。
在这个过程中,翻译引擎可以心无旁骛地处理核心的语义问题,而版式信息得到了妥善的保留。
等翻译流水线完工后,BabelDOC 再启动它的自适应排版引擎,尽量在原有版面约束下重新排版,通过自适应排版改善版式保留效果。
这不是简单的”文本替换”,而是一套完整的文档级处理工作流。这也是论文标题中 Layout-Preserving(版式保留)的灵魂所在。

这些技术细节,如何拯救你的阅读体验?
技术架构听起来很酷,但对用户来说,更关心的是:它能不能让我不再对着乱码的文档抓狂?
有了 IR 这个车间的调度,很多以前棘手的问题迎刃而解:
- 学术论文: 复杂的数学公式,通过自适应透传机制降低了被翻译模型误改的风险,用于保护和重建可识别的公式片段。
- 技术文档: 自动识别文档中的领域术语,作为上下文注入大模型,引导模型遵循统一术语表翻译,有效改善同一术语前后译法不一致的情况。
- 多栏排版文档: 即使段落被切断、跨页,系统也能通过启发式规则,改善跨页、跨栏段落被切断后的上下文衔接。(大语言模型 LLM 翻译专属能力)
这正是为什么我们坚持认为PDF 翻译不只是翻文字,而是面向整份文档的智能处理。
200 页的深度压力测试
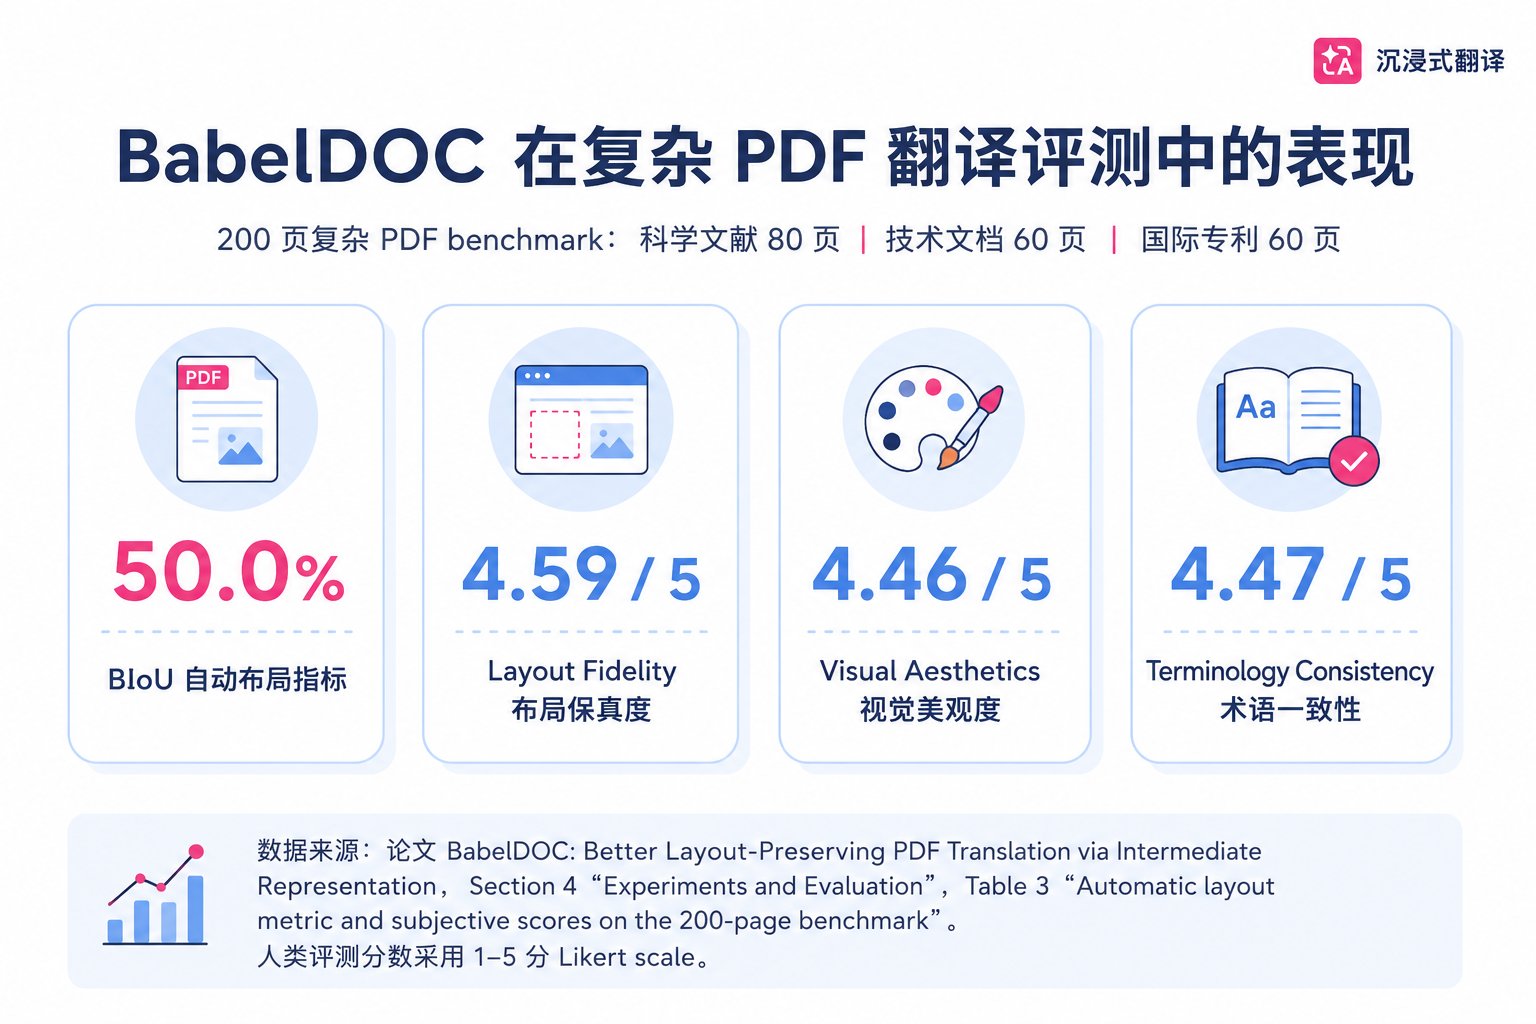
为了验证这套框架的实力,论文中构建并报告了一个 200 页复杂 PDF benchmark 的评测结果,涵盖了满是公式的科学文献、嵌套结构的开发者文档、以及术语密集的国际专利。
评测结果令人振奋:在论文评测中,BabelDOC 在布局保真、视觉美观和术语一致性上表现突出;同时,复杂 PDF 的抽取与渲染鲁棒性仍是后续优化方向。
但我们想澄清一点:BabelDOC 的目标从来不是”干掉所有的翻译工具”。
相反,它面向复杂 PDF 翻译提供了一个更可控、可扩展的框架——
大语言模型负责提供高质量的语言,而 BabelDOC 负责处理排版保留、术语控制、公式保护和最终的文档重建。
在论文、技术文档、专利、报告等复杂 PDF 场景中,BabelDOC 尝试在翻译质量、版式保留和阅读体验之间取得更好的平衡。
基础设施:开放的设计图纸
BabelDOC 从来不想只做一个封闭的”黑盒”。随着论文的发表,BabelDOC 也在向开源文档翻译基础设施演进,开发者可以通过 CLI、上层项目集成和本地部署方式参与使用与扩展。
它的模块化设计意味着:
- 开发者可以通过 CLI 处理 PDF 翻译任务。
- 可作为底层引擎被上层项目集成(注:当前 Python API 仍偏内部接口,开发者可优先参考 README 推荐调用方式。)
- 在配置本地或私有 OpenAI-compatible endpoint 的前提下,可用于更可控的本地或私有化部署场景。
知识无国界,且应当拥有更优雅的载体
从网页翻译解决浏览障碍,到双语对照解决实时理解,沉浸式翻译团队一直走在”降低人类跨语言阅读门槛”的路上。
但当我们面对教材、专利、财报、顶会论文、数据手册等时,我们清楚地知道:结构决定了阅读的路径,排版决定了信息的尊严。 这就是为什么我们在 PDF 翻译上持续投入。
这次 ACL Demo Paper 的发布,对 BabelDOC 只是一个阶段性的标记。它生于用户的真实痛点,也希望将这套实践经验反哺给学术与技术社区。
我们会继续推进 BabelDOC 在复杂 PDF、扫描文档、术语一致性、多语言覆盖、开发者接口和本地部署等方向上的能力。PDF 兼容性仍是后续持续优化方向,我们也将持续扩展更多语言和排版场景的覆盖能力。
希望能有那么一天,全人类的知识,再也不会被语言的壁垒和冰冷的文档格式所阻挡。
论文与开源项目地址见文末原文信息段,感兴趣的读者可以前往 arXiv 阅读全文,或在 GitHub 上查看 BabelDOC 的代码与文档。
原文信息
- 作者:沉浸式翻译(@immersivetran),沉浸式翻译官方团队,浏览器 AI 翻译扩展
- 发布时间:2026-05-25
- 论文地址:《BabelDOC: Better Layout-Preserving PDF Translation via Intermediate Representation》,arXiv:2605.10845(行内代码
arxiv.org/pdf/2605.10845) - 开源仓库:
github.com/funstory-ai/BabelDOC
原文地址:
暂无评论,快来抢沙发~