Anthropic 发布 FlashProve:证明回复来自已承诺模型权重的密码学证明
📌 One-Sentence Summary
FlashProve 是 Anthropic 开源的 zkSNARK 系统,可通过密码学证明验证模型回复来自已承诺的模型权重,从而让人们无需信任中间方,也能验证 Llama 4 Maverick 等大型模型的 AI 推理结果。
📝 Summary
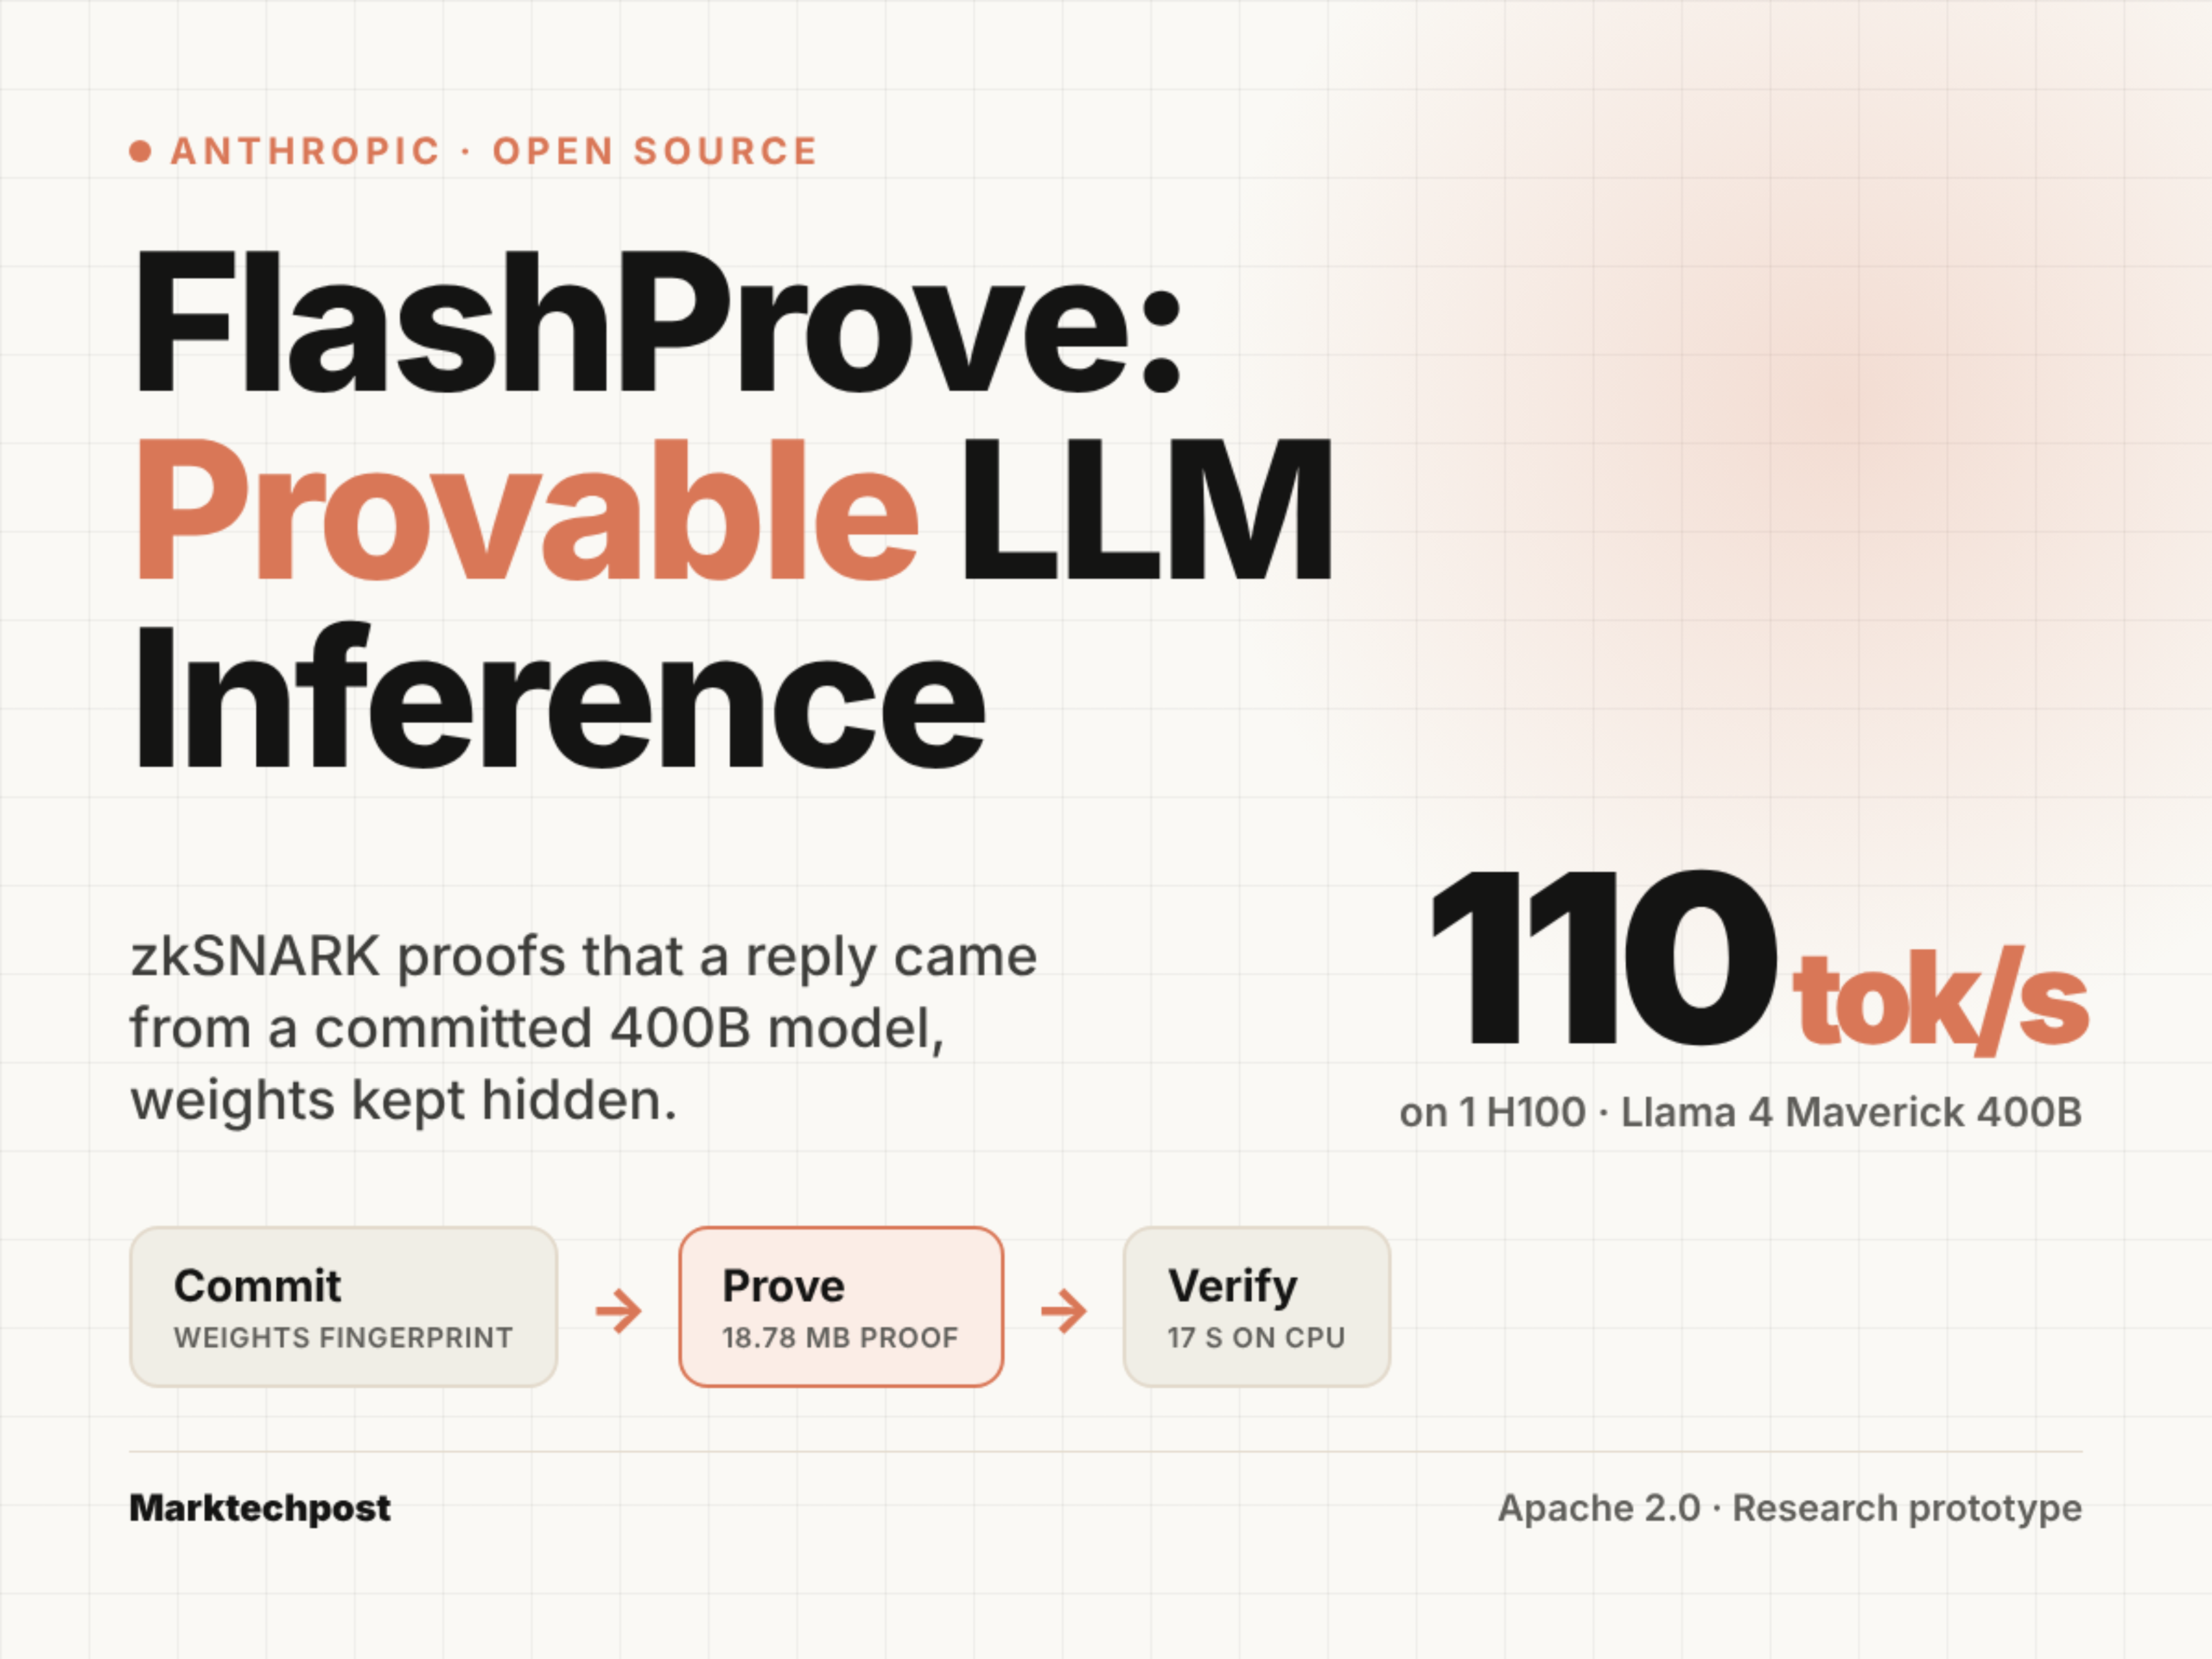
FlashProve 是 Anthropic 前沿红队推出的开源研究原型,实现了一套可证明推理的 zkSNARK 系统。该系统可生成密码学证明,证明特定模型回复由已承诺的模型权重生成,同时不泄露权重本身。系统分为两个阶段:离线承诺阶段(处理约 1,600 万次请求需 39 分钟)和在线证明生成阶段。在 Llama 4 Maverick(400B MoE,每个 token 约有 17B 个激活参数)上,FlashProve 使用 1 张 H100 进行证明时可达到约 110 tokens/秒;大小为 18.78 MB 的证明可由 CPU 在 17 秒内完成验证。该系统通过基于哈希的证明提供后量子安全性,类似 Starknet 等采用有效性证明的 L2 网络。主要应用包括监管合规、防篡改检测和文本来源验证。不过,与纯 vLLM 推理相比,生成证明所需的 GPU 时间高出 70-95 倍;目前,该系统仅支持 MoE 模型,且上下文长度限制为 1,024 tokens,并采用贪心解码。
💡 Main Points
用于模型验证的密码学证明系统
FlashProve 使用 zkSNARK 技术生成证明,表明回复来自已承诺的模型权重,同时不泄露权重本身,从而无需信任中间方即可验证 AI 推理输出。
在大型模型上的高性能实现
在 Llama 4 Maverick(400B MoE)上,FlashProve 使用 1 张 H100 进行证明时可达到约 110 tokens/秒,大小为 18.78 MB 的证明可在 17 秒内完成验证;每个 token 实际只使用约 17B 个激活参数,而非完整的 400B 模型规模。
采用离线承诺的两阶段运行方式
系统分为离线阶段(用 39 分钟发布覆盖约 1,600 万次请求的承诺)和在线阶段(GPU 为每次请求生成证明)。权重从主机内存流式传输,因此单张 80GB GPU 即可满足需求。
计算开销显著
与纯 vLLM 推理相比,生成证明所需的 GPU 时间高出 70-95 倍。尽管只对激活参数进行证明并采用批处理提高了效率,计算开销仍然很高。
在 Lean 中进行形式化安全验证
Anthropic 使用 Lean 定理证明器对协议进行形式化,以证明其完备性、可靠性和零知识属性。系统提供两个验证器:适用于日常使用的快速 C++ 版本,以及速度较慢但具有形式化保证的 Lean 验证器。
💬 Key Quotes
FlashProve 是 Anthropic 推出的 zkSNARK 系统,可以证明回复来自已承诺的模型。证明不会泄露任何模型权重信息。
在 Llama 4 Maverick 这个 400B 混合专家模型上,它使用 1 张 H100 进行证明时,速度约为 110 tokens/秒。
如今,你无法核实究竟是哪个模型回答了你的 API 调用。
该证明系统使用哈希函数,将交互式预言机证明编译为密码学证明。Anthropic 表示,这能提供后量子安全性。
生成证明所需的 GPU 时间约为纯 vLLM 推理的 70 到 95 倍。
📊 Article Meta
AI Screening: 85
Source: MarkTechPost
Author: Asif Razzaq
Category: 人工智能
Language: 英文
Read Time: 4 min
Word Count: 942
Tags:
AI 与智能应用 , AI 安全与对齐 , 模型训练与推理 , AI Agent , 模型评测与基准
整理得太全面了,省了我不少时间。
这个比较实用,已转发给同事。
内容翔实,正好需要,先收藏再看。
讲解得很细致,新手也能看懂。
很有价值的分享,感谢整理。
有没有更详细的教程,期待后续。
看完了,收获满满,期待更多更新。
有没有更详细的教程,期待后续。
这篇文章分析得很透彻,收藏了!
楼主辛苦了,内容很有参考价值。
作者写得真不错,学到了不少。
实测过类似工具,作者说的基本属实。