按长度分批而非逐项循环以优化 SLM
📌 One-Sentence Summary
本文演示了长度分桶批处理如何通过最小化填充开销和克服内存带宽瓶颈,显著提升小语言模型(SLM)推理吞吐量,并在 Qwen2.5-0.5B 上通过基准测试验证。
📝 Summary
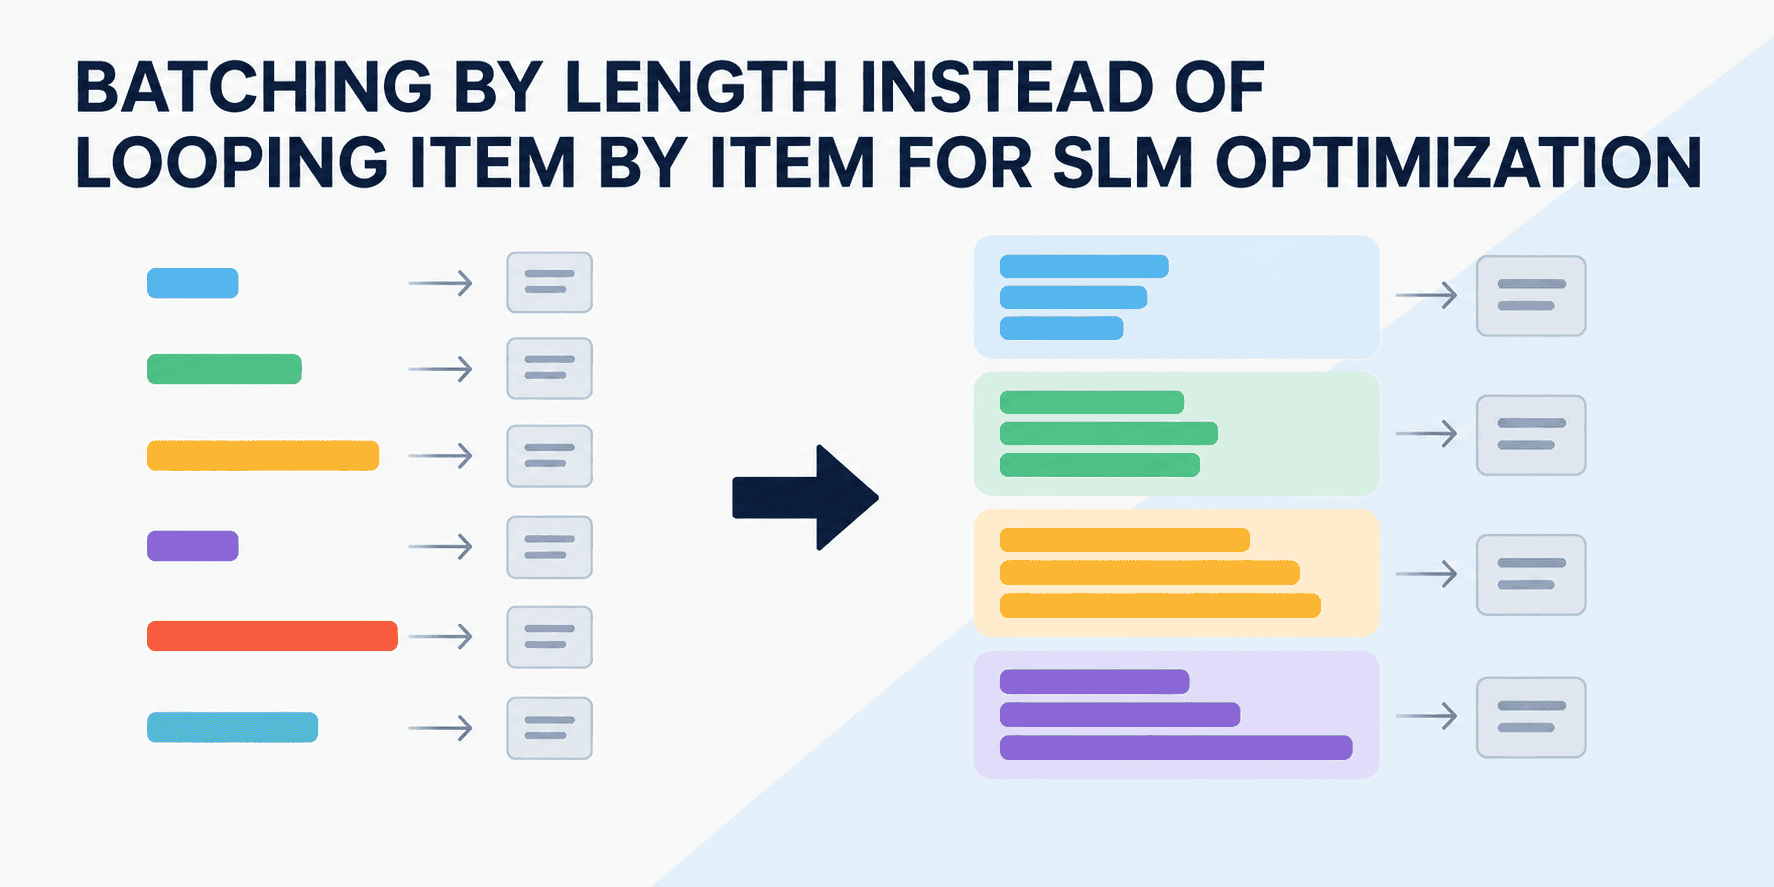
针对针对窄自动化任务优化小语言模型(SLM)系列的最后一篇,聚焦于长度分桶批处理技术。作者解释说,逐项处理效率低下,因为小模型通常受限于内存带宽而非计算能力,即硬件大部分时间花在加载权重而非计算上。虽然标准批处理可分摊权重加载成本,但会因将序列填充至批次中最长项而引入大量浪费。通过在形成批次前按 token 长度对输入排序,每个批次仅填充至其局部最大值,大幅减少无效计算。在 M2 MacBook Air 上使用 Qwen2.5-0.5B-Instruct,文章展示长度分桶批处理使吞吐量较顺序处理近乎翻倍,同时保持完全相同的预测准确性。关键实现细节包括:使用左填充以确保正确提取 logits、将输出 logits 限制在最后一个位置以节省内存,并对照单项基线验证正确性。文章最后给出关于调整批次大小和处理前缀缓存交互的实用建议。
💡 Main Points
SLM 顺序处理主要受限于内存带宽而非计算能力。
批次大小为 1 时,硬件必须为每个序列从内存加载所有模型权重,导致算术单元闲置。批处理将此成本分摊到多个序列上,使瓶颈转向计算利用率。
长度分桶批处理通过将相似大小的输入分组,最小化填充开销。
标准批处理将批次中所有序列填充至最长项长度,若数据呈长尾分布,可能导致 3 倍以上的无效计算。按 token 长度排序可使每个批次仅填充至其局部最大值,将填充开销保持在低水平(如约 7.6%)。
正确实现需特别注意填充侧与 logit 提取。
在索引 -1 处提取 logits 时必须使用左填充,以免读取填充 token。此外,使用 `logits_to_keep=1` 可避免为未使用位置分配巨大张量,这对批处理较长序列时的内存效率至关重要。
优化必须对照基线验证,确保不改变模型预测。
文章强调,任何改变输出的加速都非优化。通过将批处理预测与单项预测严格对比,确认长度分桶批处理在提升吞吐量的同时保持了准确性。
💬 Key Quotes
每次前向传递仅处理一张工单是整个流程中最大的浪费来源。
改变预测结果的优化不是优化,而是带着秒表的退步。
此处必须设置 `padding_side = 「left」`,而非可选。若用右填充,`logits[:, -1, :]` 对于所有短于批次最大长度的行都会落在填充 token 上,欺骗性地产生垃圾预测。
📊 Article Meta
AI Screening: 86
Source: KDnuggets
Author: Matthew Mayo
Category: 人工智能
Language: 英文
Read Time: 10 min
Word Count: 2354
Tags:
AI 与智能应用 , 性能优化 , AI 工程 , LLM 推理优化 , AI 工作流
有没有更详细的教程,期待后续。
刚好最近在找这方面的资料,太及时了。
这个观点很中肯,深有同感。
这个比较实用,已转发给同事。
思路清晰,干货满满。
不错不错,已加入书签。
赞同,实践出真知。
赞同,实践出真知。
路过
实话,说的不明不白
实话,说的不明不白
赞同,实践出真知。