99%、99.9%、99.99%:AI 推理可用性每个九背后的故障域、架构代价与选型问询清单
一句话结论
每个”九”都是一道不同的工程题,不是同一道题的加强版:99% 要求架构能扛住节点级故障,99.9% 要求能扛住整个机房消失,99.99% 要求能扛住一个区域出事。选 AI 推理供应商时,先问清 SLA 数字背后覆盖哪层故障域、基础设施归谁所有、故障切换是否长期跑真实流量。
可靠性数字的问题所在
AI 推理服务宕机,挂在它上面的产品就跟着宕机。GPU 跑 AI 推理的失败方式与传统服务不同:硬件有独特的失败模式,系统又为了性能压得很紧——单 GPU 每分钟 100 万 token、200 TPS,语音模型用定制内核做到 50ms 以下首 token 延迟,这种系统没有多少余量,每加一个九,AI 推理可靠性的成本指数级上升。
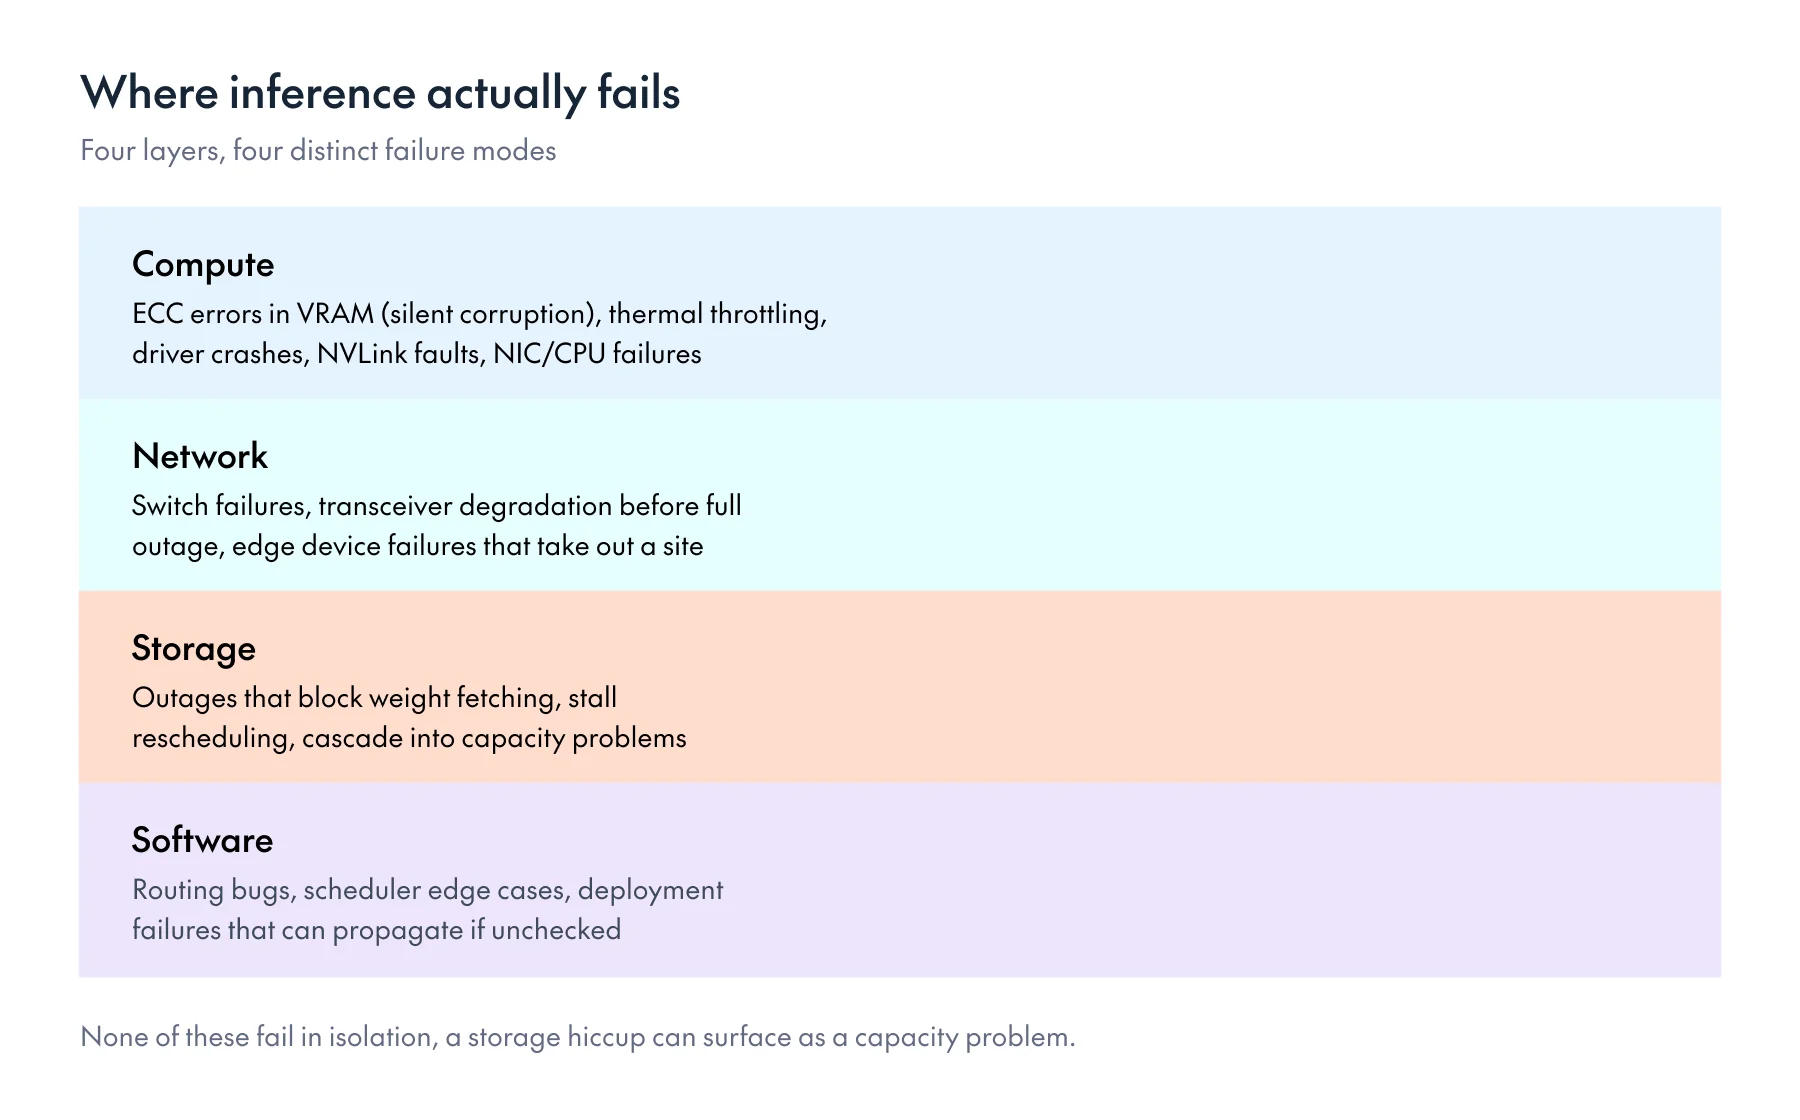
有用的心智模型是分层,每层失败模式各不相同:
- 计算层:显存 ECC 错误(最常见的静默故障——权重被悄悄污染,请求照常返回但输出不可信)、热节流、驱动崩溃、NVLink 故障、网卡或 CPU 挂掉导致整机报废。
- 网络层:交换机故障、收发器劣化(先降性能再全断)、边缘设备故障带走整个站点。
- 存储层:存储中断阻塞权重拉取、卡住重调度,级联成容量问题。
- 软件层:路由 bug、调度器边界情况、部署失败,处理不当会扩散。
这些故障从不孤立出现:存储抖动表现为容量问题,热事件在健康告警触发之前就表现为输出质量下降。做好运维的本质,是从误导性症状里读出真实信号。
每个九实际要求什么
99%:扛住节点故障
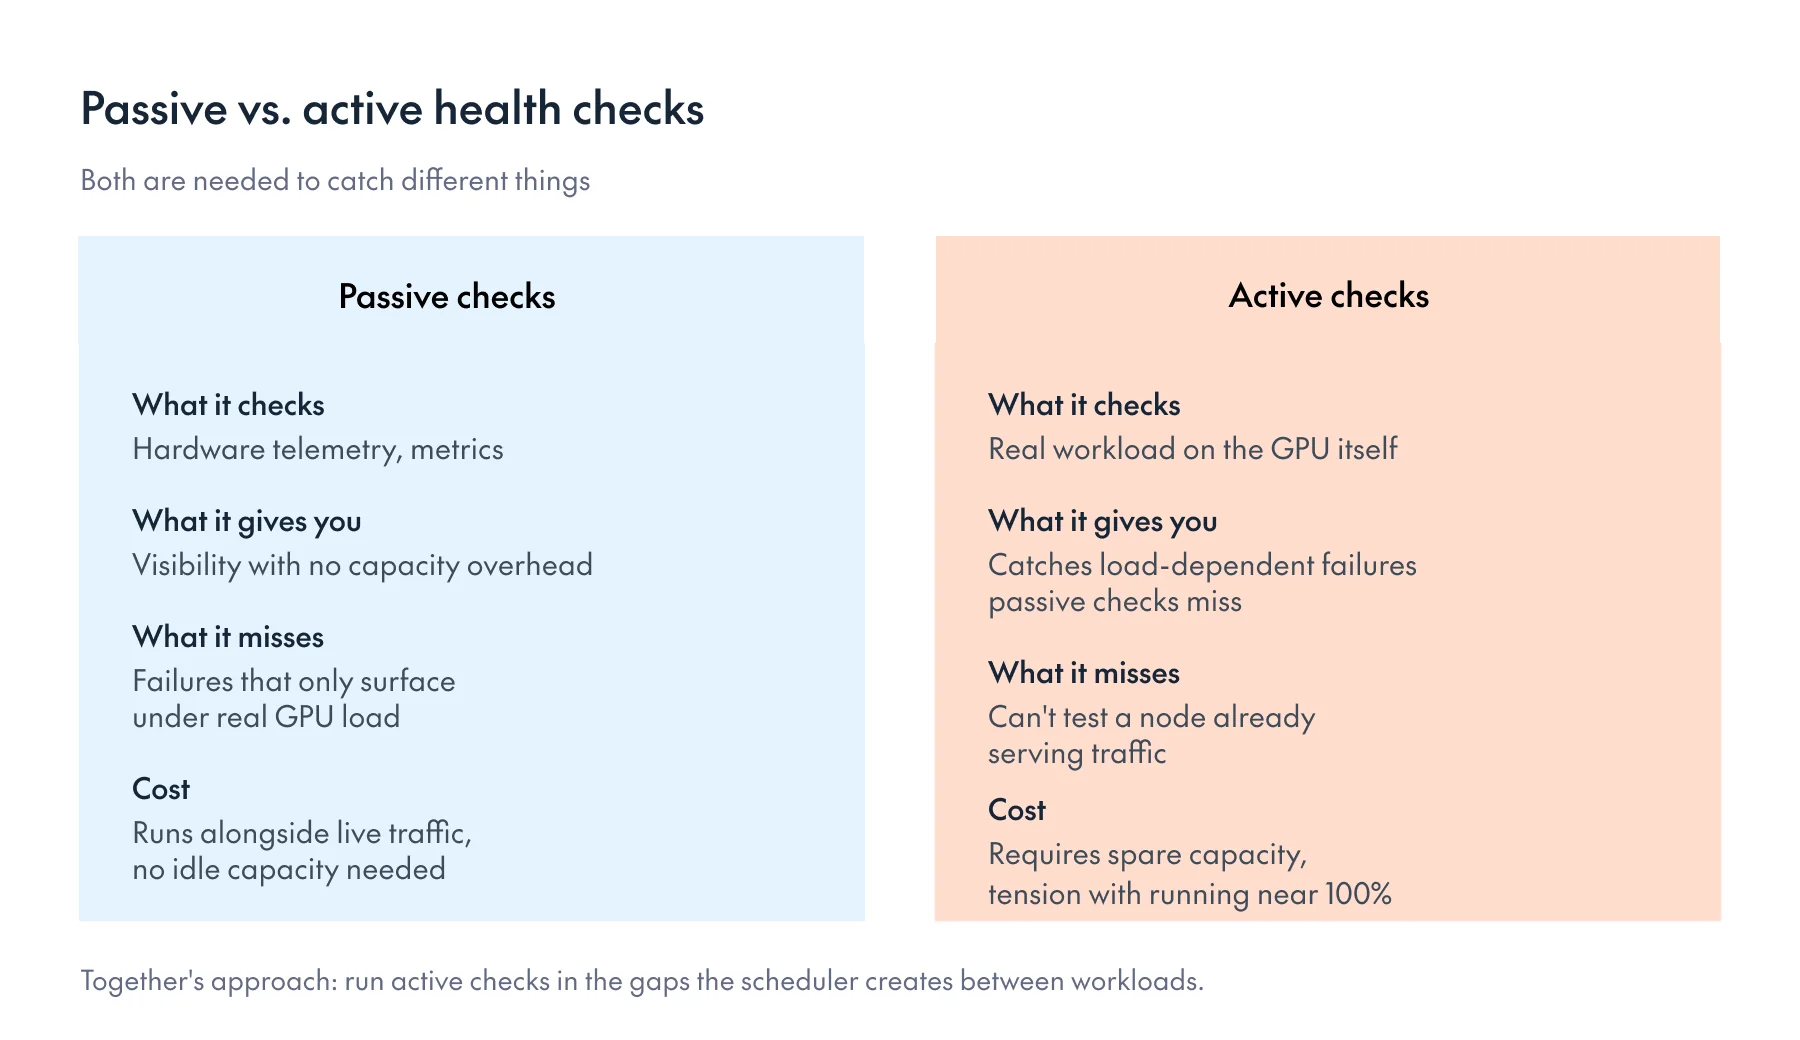
目标是让劣化中的节点在请求到达前被发现:快速检测、排水、替换。真正难的工程问题是可观测性。被动健康检查(硬件遥测、指标)不占容量就能给可见性,但抓不到只在真实 GPU 负载下才暴露的故障;主动健康检查能抓到,但需要容量来跑——你不能拿一台正在服务流量的 GPU 做体检。人人都想跑接近 100% 利用率,为体检留余量就是拿可靠性换效率。Together 的解法是把检查与调度器集成、塞进工作负载间隙里跑,并把检查本身做得尽量快。
这一层的天花板是机房本身:供电、制冷、边缘路由,任何一项都能把单机房部署整体打掉。多数供应商有备份系统,但一套没在真实条件下定期演练过的冗余系统,等于让半年没训练的替补队员上场——故障切换写在纸面上是一回事,真管不管用是另一回事。
99.9%:扛住整个机房故障
这层的失败域是整座设施:电力、制冷、网络入口、边缘网络。活下来的要求是:模型权重部署在两座设施、每侧都有足够容量吃下全部负载、流量路由能干净切换。决定供应商是否真做到这一层的架构选择是:两座设施持续跑真实流量,还是只养冷备。Together 选持续双跑。多数 99.9% SLA 承诺隐含的就是这一层——问题是承诺背后的架构是不是真为它建的。
基础设施所有权在这里具体生效:从超大规模云或 neocloud 租容量的供应商不拥有自己的故障域,电力或制冷层出事时他们只能给真正的主人开工单。凌晨三点供应商给云厂开工单、云厂再排队是什么体验,见过的人都懂。Together 一张工单覆盖硬件、网络、存储和软件,因为整个全球足迹从芯片到 token 都可见。
99.99%:扛住区域级故障
这层的底层矛盾是:要在本质上不可靠的硬件上建可靠基础设施。GPU 故障率显著高于 CPU,每种失败模式都必须被计入。四个九要求多区域部署加可用区冗余,且故障切换区域要有预留容量、大到能吃下整个区域的事故。关键词是”预留”——不是”我们可以把流量导过去”,而是”那里现在就闲着足够的位置”。
签约供应商前该问的问题
SLA 只是起点。这些问题直指数字背后的架构、故障时谁负责什么、恢复有多快:
基础设施所有权
- 模型托管在哪里,单区域还是多区域?
- 基础设施是自有还是从超大规模云/第三方租的?
- 数据中心的电力、制冷、专线谁负责?有物理访问权,还是走工单队列?
- 一个机房出事时,部署多快能迁走?是否专门为此保留备用容量,还是跑得很紧?
全栈能力
- 全链路是否有芯片到 token 的可见性,推理与硬件之间有没有观测盲区?
- 出故障时团队有硬件直接访问权,还是依赖第三方诊断响应?
- GPU 硬件专长有多深,超出推理软件之外还有多少?
容量与切换
- 故障切换怎么测试:持续真实流量,还是周期性演练?
- 故障切换真要执行时,现实的 RTO 是多少?
SLA 计量口径
- 每档 SLA 实际覆盖哪个故障域:节点、机房还是区域?
- SLA 在负载均衡器上量,还是在推理成功完成处量?
- 客户端重试算不算进你的可用性统计?
数字口径公开
AI 服务模糊的 SLA 定义正是”承诺”与”交付”之间差距的藏身处。Together 的口径:交付可用性按推理端点成功服务请求的百分比计,在推理完成处计量而非负载均衡器——到达负载均衡器但 GPU 上失败的请求,在他们的账上就是宕机。单机房合同 SLA 99%,多机房 99.9%,已稳定交付 99.9%;机房故障后流量切到健康容量的时间为秒级;计量窗口内服务推理请求超 20 亿 TPM。
还有一条:可用性和性能是两份合同。在预留吞吐产品里买的是 GPU 配额交付指定 TPS,不只是端点有响应——一个”活着”但只交付合同吞吐 30% 的服务没有履约。
结论
每家供应商都会给你一个数字。重要的是数字背后的架构是否撑得住、保障必须成立的那层基础设施归不归它自己。这些是可回答的问题:要求任何供应商逐层讲清每个 SLA 档位背后的架构、是否拥有基础设施、故障切换路径是否跑真实流量。了解自己基础设施的供应商,能很快回答。
原文信息
- 作者:Together AI
- 发布时间:2026-07-16 原文地址: