7 款小型专业模型,在单项任务上胜过大型 LLM
📌 One-Sentence Summary
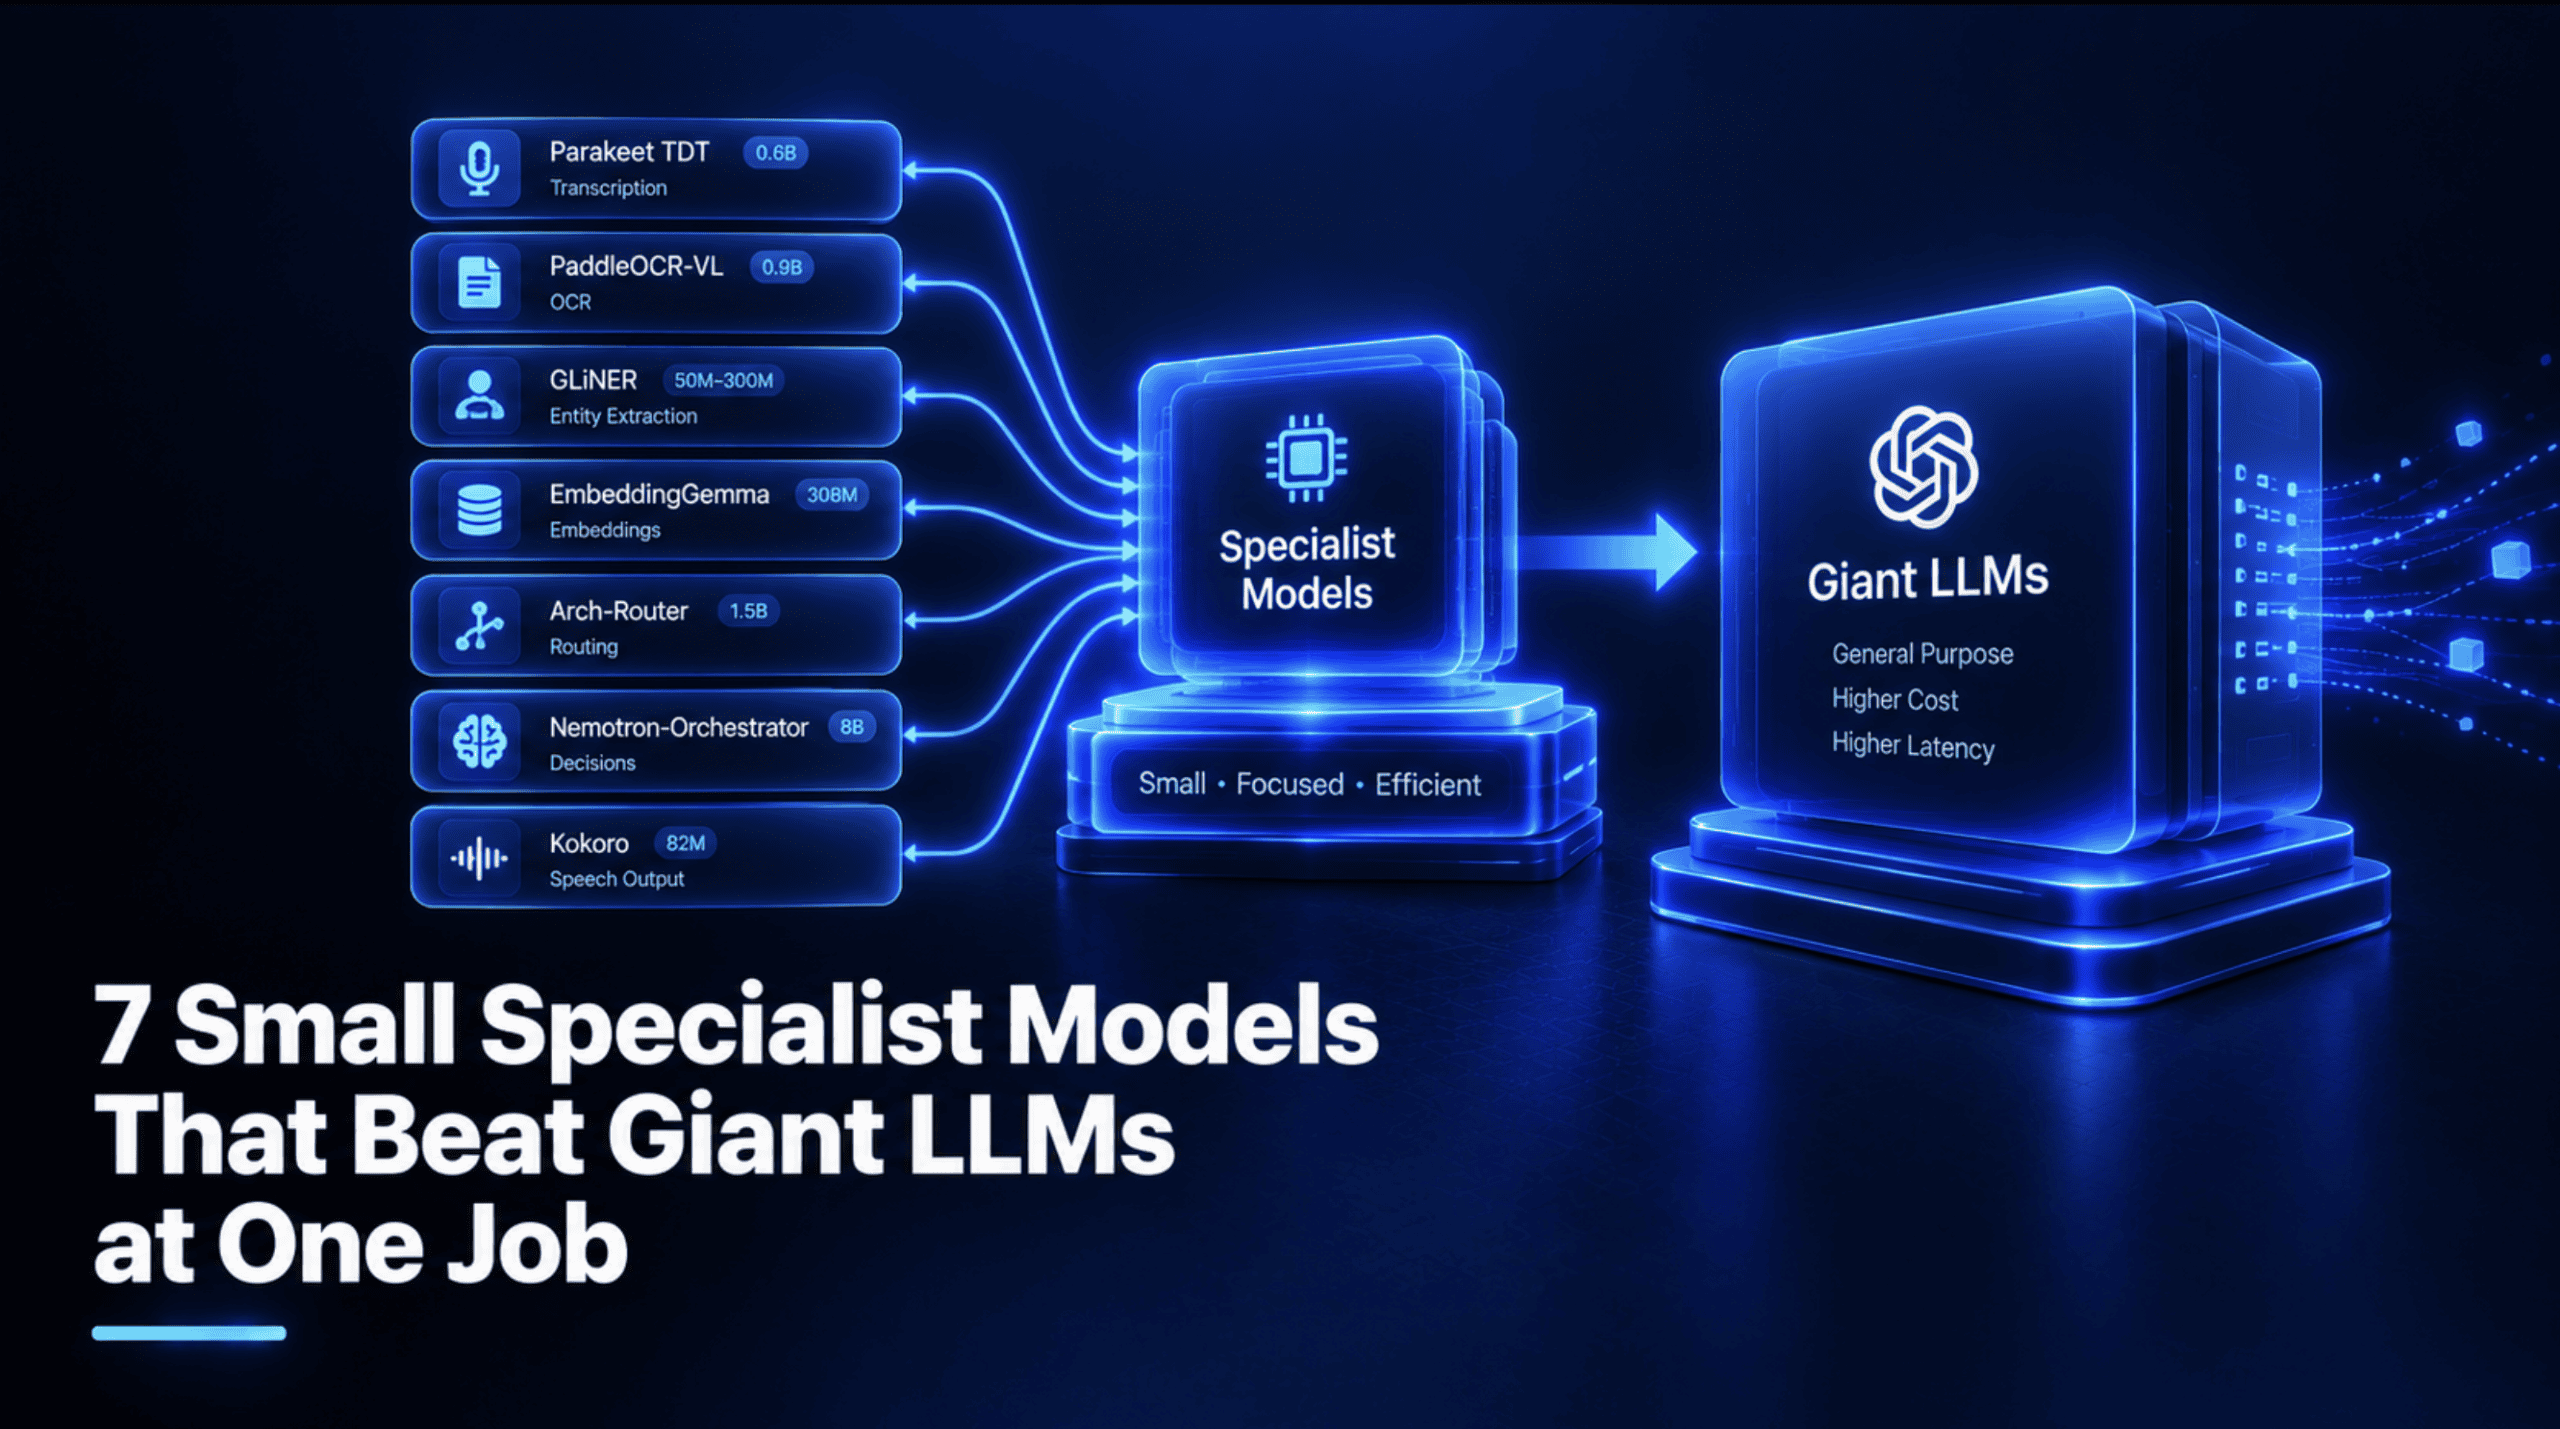
本文介绍了 7 款参数量低于 10B 的开源专业模型,它们在转录、OCR、实体抽取、嵌入、路由、决策和语音合成等特定任务上的表现胜过更大的 LLM。
📝 Summary
本文介绍了 7 款开放权重专业模型,每款参数量均低于 10 billion,在各自的单项任务上表现出色,优于更大的通用 LLM。这些模型包括用于转录的 Parakeet TDT 0.6B(准确度和速度均胜过 Whisper large-v3)、用于 OCR 的 PaddleOCR-VL-1.6(在 OmniDocBench 上表现优于 Gemini 3 Pro 和 GPT-5.2)、用于实体抽取的 GLiNER(零样本 NER 表现超过 ChatGPT)、用于嵌入的 EmbeddingGemma(在 MTEB 上排名最高的 500M 以下开放模型)、用于路由的 Arch-Router 1.5B(准确率达到 93.17%,而专有模型为 85.46%)、用于决策的 Nemotron-Orchestrator-8B(在 Humanity's Last Exam 上得分 37.1%,高于 GPT-5 的 35.1%),以及用于 TTS 的 Kokoro-82M(在盲听测试中胜过更大的模型)。每个部分都介绍了模型规格、许可证、基准测试结果,以及可在本地部署的可运行代码。文章最后指出,这些专业模型无法在所有场景中取代通用 LLM,并讨论了它们的局限性。
💡 Main Points
7 款参数量低于 10B 的开源专业模型,在特定单项任务上的表现胜过更大的 LLM
每款模型都针对一项任务进行了优化:Parakeet 用于转录,PaddleOCR 用于文档解析,GLiNER 用于实体抽取,EmbeddingGemma 用于生成嵌入,Arch-Router 用于路由决策,Nemotron-Orchestrator 用于工具选择,Kokoro 用于文本转语音。它们符合以下标准:权重开放、任务目标明确、已发布基准测试数据证明效果,且体量较小,适合在单台机器上部署。
Parakeet TDT 0.6B 的词错误率为 6.32%,速度为 3,330 RTFx,胜过词错误率为 7.44%、速度为 146 RTFx 的 Whisper large-v3
这意味着推理速度约快 23x,且错误更少,使其非常适合用于转录流程。不过,它只支持 25 种语言,而 Whisper 支持 99 种。
Arch-Router 1.5B 的路由准确率达到 93.17%,平均比 GPT-4o 和 Claude-Sonnet-3.7 高 7.71%
该模型只需 50ms 即可完成路由决策,而 Gemini-2.0-flash-lite 需要 510ms,Claude-Sonnet-3.7 需要 1,450ms。这表明它能显著提升编排任务的效率,同时仍可在需要时调用更大的模型。
Nemotron-Orchestrator-8B 在 Humanity's Last Exam 上得分 37.1%,超过 GPT-5 的 35.1%,成本仅为其 30%,速度快 2.5x
该模型的优势在于判断应调用哪个工具或模型,而不是完全取代大型模型。在 τ²-Bench 上,它的得分为 80.2%,高于 GPT-5 的 77.7%;但仍有约 40% 的步骤需要大型模型参与。
由于不同模型框架之间存在依赖冲突,部署时需要使用彼此独立的虚拟环境
不同模型使用的技术栈各异,例如 PyTorch、NeMo、Paddle 和 vLLM,若将它们安装在一起,依赖可能发生冲突。文章为每款模型提供了具体的 pip install 命令和环境配置说明,也介绍了如何处理 EmbeddingGemma 这类需要通过 Hugging Face 身份验证才能使用的受限模型。
💬 Key Quotes
其中大多数步骤都是单项任务,而小型专业模型正是为此而打造的。
Parakeet v3 的平均词错误率为 6.32,Whisper large-v3 为 7.44;吞吐量则分别为 3,330 和 146(RTFx,数值越高越快)。这意味着它的速度约快 23 倍,错误还更少。
在 PaddleOCR-VL-1.6 论文中,该模型在 OmniDocBench v1.6 上的总分为 96.33,而 Gemini 3 Pro 为 92.91,GPT-5.2 为 86.59。
GLiNER-S 的参数量为 50M,在零样本 NER 上的平均得分为 52.7,高于 ChatGPT 的 47.5。
该论文报告称,其总体路由得分为 93.17%,在测试的专有模型中,包括 GPT-4o 和 Claude-Sonnet-3.7,平均高出 7.71%。
在 Humanity's Last Exam 上,它的得分为 37.1%,GPT-5 为 35.1%;它的成本约为 GPT-5 的 30%,速度则快 2.5 倍。
这些针对特定任务的模型不会在所有场景中取代大型语言模型(LLM),最后一部分会介绍它们不适用的情况。
📊 Article Meta
AI Screening: 86
Source: KDnuggets
Author: Shittu Olumide
Category: 人工智能
Language: 英文
Read Time: 11 min
Word Count: 2633
Tags:
AI 与智能应用 , 开放权重模型 , 模型训练与推理 , 本地与端侧 AI , 机器学习
不错不错,已加入书签。
实话,说的不明不白
不错不错,已加入书签。
实测过类似工具,作者说的基本属实。
实测过类似工具,作者说的基本属实。
楼主辛苦了,内容很有参考价值。
赞同,实践出真知。
这篇文章分析得很透彻,收藏了!
看完了,收获满满,期待更多更新。
讲解得很细致,新手也能看懂。
点赞,必须点赞
看标题就点进来了,内容果然没让人失望。