5 个真正提升 LLM 输出效果的提示优化策略
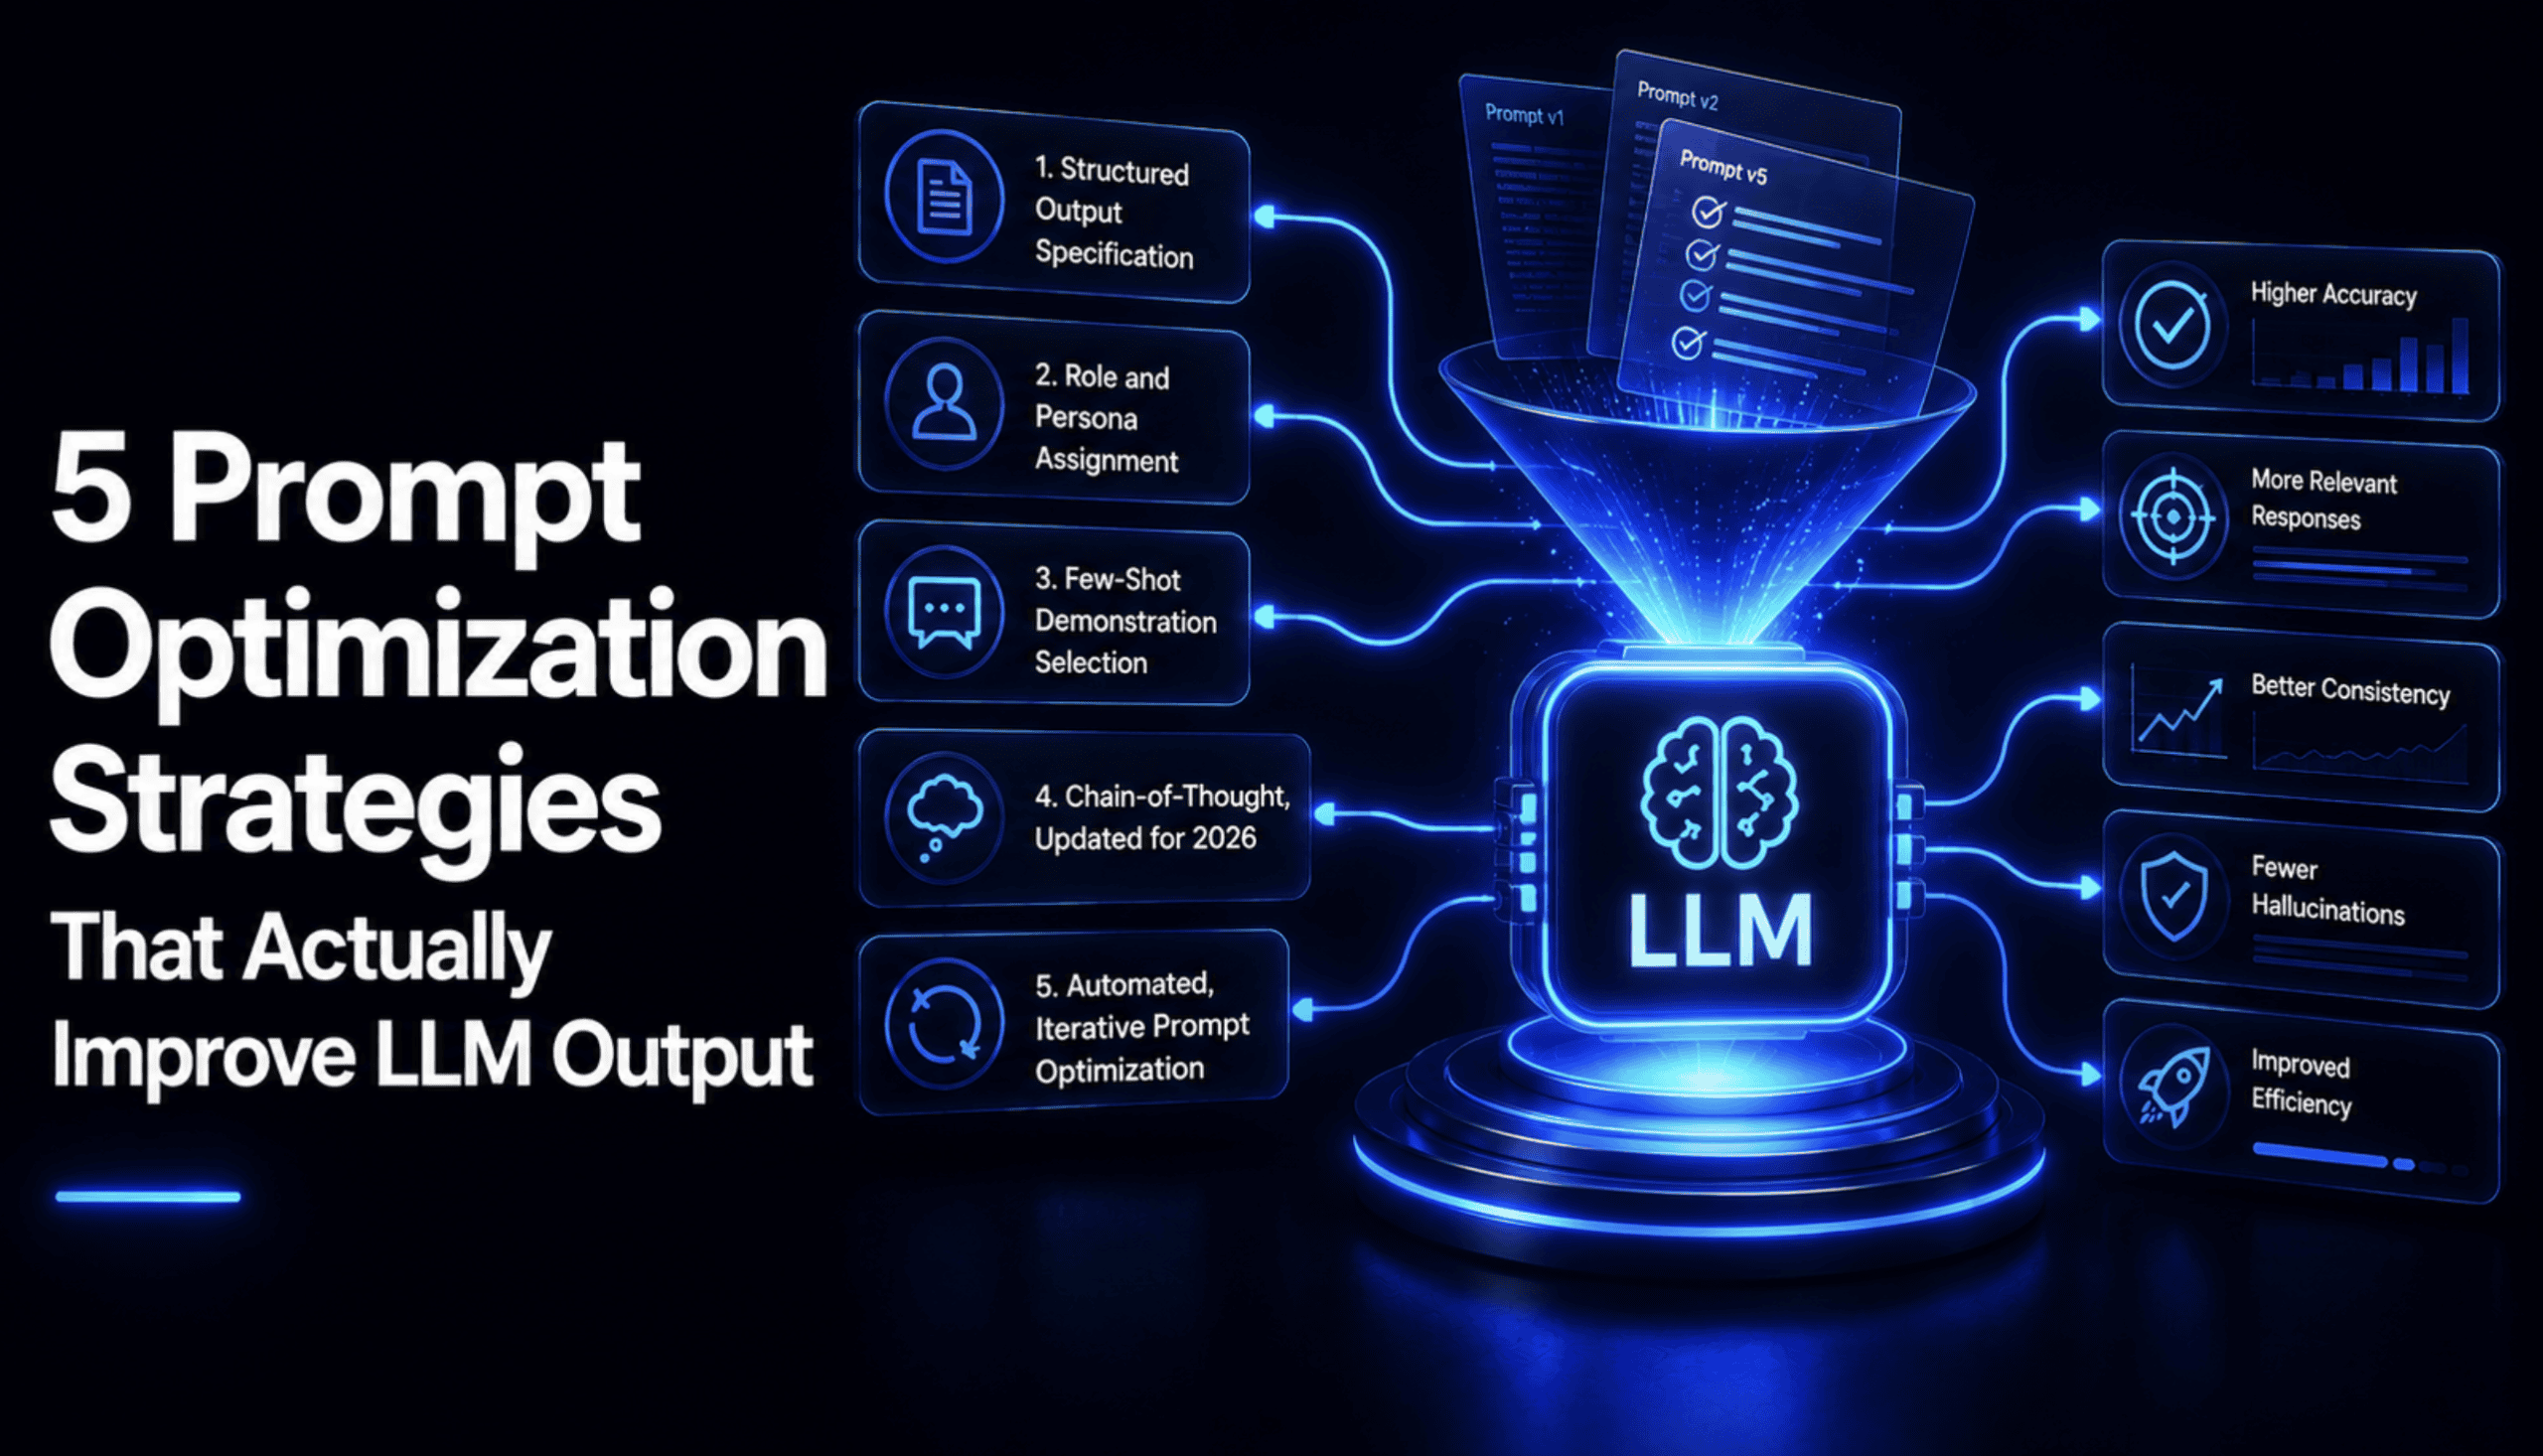
📌 One-Sentence Summary 本文区分了提示优化与提示工程,并针对一份刻意设计的混乱会议记录,展示了五种有证据支持的策略——结构化输出、角色分配、多样化少样本选择、思维链和自动迭代搜索。 📝 Summary 文章认为提示优化(优化现有提示)不同于提示工程(从头设计),且大多数从业者需要前者。它使用一份单独的混乱会议记录,包含三个已知的困难案例——对话中途重新分配、任务被合并到另一个任务中,以及一个明确未解决的负责人——作为持续的测试平台。展示了五种策略并逐一验证:(1) 用 Pydantic 模式指定结构化输出,将无法解析的文本转化为三个经过验证的对象;(2) 分配角色和个性,使模型为模糊性做好准备;(3) 通过 TF-IDF 余弦相似性选择多样化少样本演示,捕获了一对几乎重复的样本;(4) 思维链提示,对于真正模糊的案例仍然有价值,并提到 Chain of Draft 作为 token 效率变体;(5) 通过爬山法在候选指令片段上进行自动迭代提示优化,在五个片段中仅用三个就达到了完美的 1.000 综合得分。结尾部分将每个失败症状映射到解决它的策略。 💡 Main Points 提示优化通过具体性、结构化和迭代优化现有提示,而提示工程从头设计——大多数从业者需要前者。 这种区分很重要,因为询问如何获得更好 LLM 输出的人通常已经有一个可用的提示;他们需要知道哪些具体变化能起作用,而不是空白页面框架。 指定结构化输出是最可衡量的杠杆,将流畅的文本转化为可解析的、经过验证的对象。 在记录上测试,模糊提示的响应完全无法解析并返回 None 及验证错误,而使用明确 Pydantic 模式请求相同信息则干净地解析为三个经过验证的 ActionItem 对象——这是代码可用输出与需要手动转录的输出之间的区别。 分配角色和个性使模型在开始阅读前就预期模糊性。 通用指令没有理由关注对话中途重新分配或未解决的负责人,而像细致的行政助理这样的角色知道人们会在句子中途改变主意,正好标记这种模糊性——在混乱记录中最为重要。 你选择哪些少样本示例比指令措辞更重要,且多样性感知选择优于朴素选择。 研究表明演示选择可能比指令措辞影响更大。TF-IDF 余弦相似性选择器捕获了一对几乎重复的样本,而朴素的前三个选择会在三个槽位中浪费两个,替换为一个真正不同的模式。 思维链提示在真正模糊的案例中仍然值得其成本,尽管前沿模型现在原生推理。 对于移动评论重新分配,提示模型追踪整个对话中的所有权,防止锁定第一个看似合理的分配。Chain of Draft 仅使用低至 7.6% 的推理令牌就能达到思维链的准确性。 自动迭代提示优化将「我需要哪个修复」从猜测转化为可衡量的搜索。 在候选指令片段上爬山法,以召回率、负责人准确性和捏造惩罚评分,从 51.6% 开始,在三次迭代中使用五个片段中的三个达到 1.000——找到最小有效修复,而不是将所有指令扔向问题。 💬 Key Quotes 提示工程从头设计提示;提示优化通过具体性、结构化和迭代优化你已有的提示,而不触及模型本身。 这就是结构化输出提示带给你的真正区别:不是更好看的文本,而是你的代码实际可用的输出与需要人类重新阅读和手动转录的输出之间的区别。 大多数人忽略的细节是,这不是「添加几个示例」——而是哪些示例。一组偶然间同一模式的三个变体几乎教不了模型任何它已知的东西。 五种策略,但其实是一个潜在的纪律:停止猜测什么可能改善提示,开始针对真实案例测试具体的、可单独验证的变化。 搜索找到了最小有效修复,而不是将所有可用指令扔向问题,这正是针对真实案例测量而非猜测哪些片段听起来应该有帮助的优势。 📊 Article Meta AI Screening: 88 Source: KDnuggets Author: Shittu Olumide Category: 人工智能 Language: 英文 Read Time: 10 min Word Count: 2279 Tags: AI 与智能应用 , 提示工程 , AI 工程 , LLM 推理优化 , 推理模型 Read Full Article
暂无评论,快来抢沙发~