Together 最快语音转文字栈拆解:五步把 ASR 延迟打到极致的工程方法
一句话结论
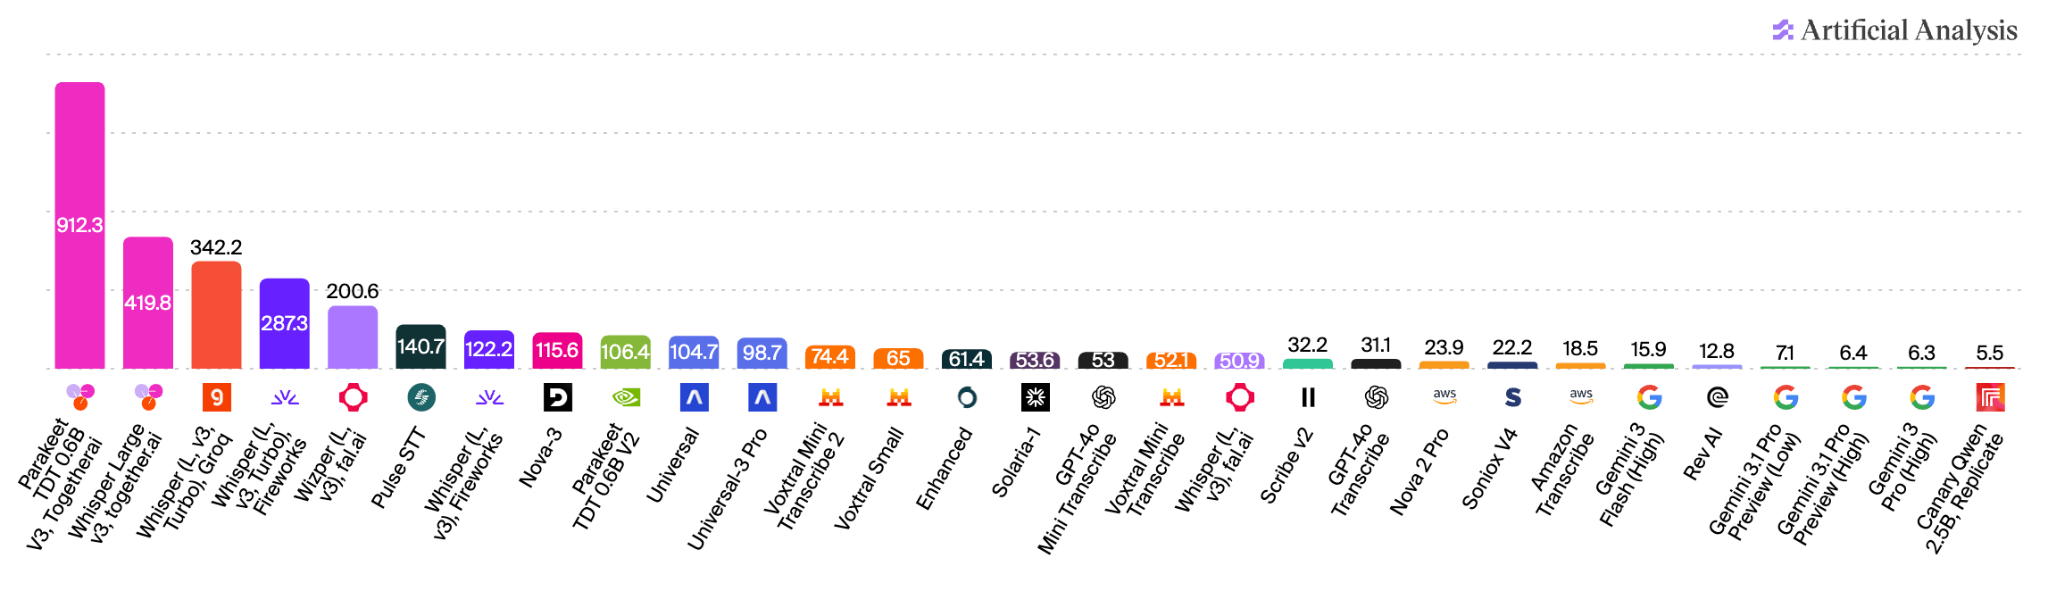
Together AI 的 ASR 栈服务着 Artificial Analysis 排名中两个最低延迟的语音转文字模型(NVIDIA Parakeet-TDT 0.6B v3 和 OpenAI Whisper Large v3),其中 Parakeet v3 可以在 10 秒内转写约 20 小时语音。这篇文章完整拆解了背后的五步性能工程:TensorRT 多 profile 编码器、条件 CUDA Graph 解码、CPU 零拷贝数据通路、epoll 事件 IO、gc.freeze 运行时治理——每一步都是可以直接借鉴到自家 AI 语音服务部署与推理优化的实操方法,选择哪一步动手、怎么验证收益都有数据。
为什么 ASR 是全链路系统问题
模态决定了问题的形状。一个 1M token 的文本提示能装下整部哈利·波特全集,体积才约 5 MB;文本到推理几乎是”即拿即用”——分词、组批、过模型。但同一套哈利·波特的有声书是 5 到 10 GB,比文本大三个数量级。在到达 GPU 之前,服务器要先解容器、重采样、降噪、VAD、切分语音、算音频特征——全是 CPU 密集活。
模型侧也反过来:LLM 有几千亿上万亿参数, serving 的工作自然集中在 GPU 里(量化、KV cache、注意力内核、组批、并行);语音转文字模型小得多,往往只有几亿到几十亿参数,因此周围的数据通路占比大得多。这使 ASR serving 成为一个横跨 GPU 执行、CPU 预处理、内存搬运、传输、连接调度和运行时行为的全链路系统问题,也意味着部署成本和延迟优化的操作空间大部分在模型之外。
同一套栈还要服务两种负载:离线转写拼吞吐,流式转写拼延迟和抖动。做语音 Agent 的人都知道:ASR 是”ASR→LLM→TTS”级联的第一环,它的延迟和抖动决定了用户可感知响应时间的最早上限。
第一步:按真实音频形状编译编码器
Parakeet 是编码器-解码器架构,约 95% 的权重在编码器。编码器接收变长语音段、产出声学帧给解码器,是优化的第一站。
音频输入长度跨度极大:从 200ms 的流式包到 30 秒连续语音。为一个形状调好的内核计划换到另一个形状可能慢得多——引擎必须在编译期就知道它将服务的形状分布。TensorRT 的价值在于提前构建优化执行计划:融合内核、调内存布局、为预期形状范围跑基准选内核变体。
关键细节是 profile 调优。只用最大输入形状调的单引擎会把短音频逼进填充路径,对流式块和短语句代价尤其高。多 profile TensorRT 引擎在内存中只保留一份编码器权重,同时按请求选择正确的优化 profile。内存从约 6 GB 降到 5 GB 是小头;大头是避免了坏形状匹配——在小输入区间,profile 感知的 TensorRT 比让请求走大填充 profile 快几倍。
编码器快了之后,解码器循环成为下一个瓶颈,profiling 继续往下挖。
第二步:把 CPU 从解码器循环里赶出去
Parakeet 的解码器在声学帧上迭代,每帧要么产出 token、要么吐 BLANK 不推进文本。代码本质上是:state = init() → for frame: token = predict(frame, state) → if token != BLANK: emit(token) → state = update(state, token)。
Profiling 发现 predict 和 update 都很快,单次 GPU 工作以微秒计。贵的是那个分支:if token != BLANK 要求 CPU 从 GPU 显存把 token 读回来决定走哪条路。这个宿主同步让解码循环无法被捕获成单个 CUDA Graph,每次迭代都要往返 Python——GPU 干几微秒的活、等 CPU、再启动下一个内核,每个请求重复几千次。
条件 CUDA Graph 节点把这个分支搬上 GPU:一个小的设备侧内核算条件、告诉 CUDA 运行时是否进入”发 token + 更新状态”子图。分支在 GPU 内解决,整个解码循环——计数器、条件、发射、状态更新——被捕获成一个 CUDA Graph 一次发射。CPU 离开解码内环,解码器快了 2 到 3 倍。

第三步:别再拷贝音频字节
编码器和解码器跑顺之后,剩余延迟来自模型周围的 CPU 路径。Together 审计过的大多数 ASR 代码,延迟预算都花在冗余拷贝、热路径上不必要的进程跳转、以及本可并行的单线程函数上。
第一个杠杆是砍进程边界。音频预处理——文件解码、重采样、VAD、特征提取、分块——大多是释放 GIL 的 I/O 或原生 C/C++ 工作。典型微服务架构把预处理拆到三四个进程,付出工作负载并不需要的隔离代价;把大部分工作收进更少进程,省掉内核拷贝和序列化往返,大文件上能省几百毫秒。
真正需要进程间通信时,ZeroMQ 这类常见方案也有不小开销。在 Together 的负载里,持久 Unix domain socket 上跑自定义协议、直接传原始音频字节,在高并发下表现最好——帧格式极简、免重复建连。
大文件上 socket 仍要两次拷贝(发送方用户态→内核缓冲→接收方用户态)。要绕开这条路就用共享内存:两个进程映射同一物理区域,生产者写入的数据对消费者立即可见,零内核往返、零拷贝数据通路。复杂度代价是真实的,只有数据量配得上时才值得上。
第四步:流式用事件 IO
流式 ASR 还有连接生命周期问题。第一版实现是每连接一线程:几百路流同时发块,几百个线程一起醒来,GIL 争抢爆炸、尾延迟飙升。
改成一个线程阻塞在 epoll 上。epoll 让单个线程注册几千个连接、用一次系统调用问内核”哪个有数据了”;消息到达时内核返回完整就绪集,这个线程处理完活跃 socket 再回去睡。同样负载、调度压力小得多。对流式 ASR 转写任务,可预测性尤其重要——部分转写结果迟到会让语音系统”感觉慢”,哪怕平均延迟很好看。

第五步:冻结启动状态,消掉 GC 尾延迟
这一步几乎被漏掉。流式负载下 p50/p90 延迟健康,但 p95 会周期性飙高约 200ms。日志显示队列深度正常、GPU 时间正常,但平时 5ms 内跑完的 CPU 函数突然要 100ms+——有东西在后台偷请求循环的时间。
Profiling 定位到 Python 垃圾回收器。Python 用引用计数管大部分内存,另有一个检测循环引用的分代回收器;最老一代装着长寿对象,完整回收要遍历巨大对象图。团队在启动时预分配了一大池缓冲区、模型状态和查找表,正是为了稳态零分配延迟——但这些长寿对象全落进了最老一代,每次完整 GC 都要遍历几十万引用,这就是那 200ms 停顿。
修复只需在启动预分配后配置一行代码:运行 gc.freeze()。它告诉 Python 把预分配状态排除在后续 GC 扫描外;正常请求作用域对象照常回收,巨大的初始状态不再被反复扫描。p95 尖峰消失,p50 也因流量更平滑而改善。教训:profiling 不要停在模型——GPU 时间、队列深度、模型执行都正常时,延迟尖峰可能藏在 Python 运行时里。
语音延迟是端到端系统问题
这五步优化打在链路的不同部位:TensorRT 多 profile 引擎针对真实音频形状调编码器执行;条件 CUDA Graph 把 CPU 往返赶出解码循环;持久 socket + 共享内存 + epoll 压低 CPU 路径开销;gc.freeze 消掉运行时级 p95 失败模式。同一条约束适用于整条语音栈:每一级都必须同时控制中位延迟和尾延迟——模型执行、预处理、传输、调度、运行时行为,一处拉胯全链路买单。
Parakeet-TDT 0.6B v3 是 v2 的继任者:v2 是英语单语模型,曾在 Hugging Face Open ASR 榜单上保持单语吞吐最快;v3 把语言支持从英语扩到 25 门欧洲语言、无需语言提示即可自动检测语言,训练数据 170 万小时(含 NVIDIA Granary 多语料库)。
原文信息
- 作者:Sebastien Beurnier(Together AI)
- 发布时间:2026-05-29 原文地址:
实测过类似工具,作者说的基本属实。
整理得太全面了,省了我不少时间。
不错不错,已加入书签。
点赞,必须点赞
点赞,必须点赞
写得挺用心的,支持一下。
内容翔实,正好需要,先收藏再看。
收藏了,以后慢慢研究。
讲解得很细致,新手也能看懂。