MiniMax M3 高效推理上线实战:1M 上下文与多模态的四个服务端优化

一句话结论
MiniMax 发布 M3 模型(1M token 上下文、原生多模态、Sparse Attention 架构)后,Together AI 的推理与内核团队通过四项服务端工程——KV-Block-Major 稀疏注意力内核、MSA 与分页注意力集成、解码索引打分内核优化、Rust 多模态预处理网关——在不同并发水平下把吞吐提升 81%–125%,让这个前沿模型可以经济地在生产环境运行。对自建推理或选型推理平台的团队,这是一份”新架构模型上生产要解决哪些工程问题”的完整清单。
背景:M3 是什么,为什么难服务
MiniMax M3 是一个全能模型:代码能力第一梯队、支持智能体工作流、原生多模态推理,同时设计目标就是”1M 上下文 + 服务成本友好”。它适合长文档、代码库、工具调用、图像和迭代推理混在一起的高上下文真实任务。
但对比上一代,服务 M3 的挑战也更多:稀疏注意力计算、更大的 KV cache 管理、多模态处理都要重新优化。Together AI 是 M3 的首选云伙伴,在开放权重发布后也会直接提供开发者端点。这背后是推理与内核团队的深度性能优化,保证这个把工程边界推到极限的模型达到生产级可靠性。
新架构:MiniMax Sparse Attention(MSA)
M3 架构上最大的变化是 MiniMax 稀疏注意力(MSA),解决 M2.7 时代注意力计算瓶颈。其块稀疏机制给每个 query 能注意到的 token 数量设上限,大幅降低长上下文处理成本,使超长上下文窗口变得可行:prefill 阶段加速超过 9 倍,解码阶段加速超过 15 倍。

MSA 的计算分两步:先算分数选出每个 KV 组最相关的 K 个块,再在 query 与这些块之间做稠密注意力。这个设计在保留 KV 组维度表达力的同时,限制了每个 query 实际处理的 KV token 上限——注意力计算不再随上下文长度呈 N² 增长,天然适合长上下文负载。
在 B200 上、智能体流量形态(60k 前缀缓存)、并发 8 的条件下实测,MSA 显著降低了每次迭代中注意力计算占用的墙钟时间占比。

除注意力架构外,M3 还附带视觉组件与新的图像/视频预处理功能,工程侧复杂度进一步上升。两大挑战摆在面前:支撑 1M 上下文长度本身就是系统工程难题;视频和图像处理天然比文本 tokenization 复杂。
优化一:KV-Block-Major 稀疏注意力内核
Prefill 阶段,注意力计算仍是长上下文的大头——每个 token 都要计算 Selected Block × KV Head Group × Tokens。块稀疏注意力的特性是多个 query 会注意同一批 KV 块:如果按 query 迭代、逐个与 KV 块算注意力,同一批 KV 数据会反复从 HBM 搬进 SRAM,白白浪费带宽。
把外层循环从 query 换成 KV 组、内层循环算 query,KV cache 只需搬运一次,算术强度大幅提高。实现上需要重排 {q, kv block} 到 {kv block, q} 的映射并重写注意力内核;因为每个 kv block 只算部分输出 O,最后要基于 Log-Sum-Exp 做一次归约,把输出 O 重缩放后求和。

优化二:把 MSA 集成进分页注意力
现代推理引擎普遍用分页注意力(paged attention)管理 KV cache,而高度优化的注意力内核大多只支持固定页大小。卡点是:不同 KV 组选中的块不一样,现成内核用不了。
Together AI 提出了一种新集成方式:解码时先按选中的块构建页表,把 KV-group 维度展平进 batch 维度,再利用 KV cache 张量的跨步视图(strided view)给注意力内核提供取 KV 页所需的指针。关键在跨步设计:页地址按 D 前进以选虚拟页起点,token 按 Hkv × D 前进,把一个物理张量解交错成逐头页——每条展平行可以用不同的页表。
这个设计让现有支持 GQA 的注意力内核无需重写就能直接复用,不必从零写支持稀疏注意力的新内核;又因为每个 query 选中的块有限,块到页映射的计算开销极低。最终带来 5% 的解码吞吐提升。
优化三:解码索引打分内核
MSA 把解码成本的大头从稠密注意力挪到了 score/top-k 索引器上:每个解码 query 都要把 query 侧索引向量与候选 key 侧索引向量比对,把每个 128-token 的 KV 块约减成一个分数,只保留 top 块进入真正的注意力内核。这个扫描在每个生成 token 的关键路径上,上下文越长候选块越多。
它呈”小 query 索引 × 长 key 索引”的形状,看似能拼成一个大 GEMM,但 score/索引步骤不是纯矩阵乘:每个请求和 K 组有自己的候选块范围、掩码、逐块约减和 top-k 边界。强行拼接会留下参差的 gather-and-reduce 问题,还把填充和簿记压上关键路径。
优化后的路径采用 AB 交换的 HMMA 布局:把 128-token 的 key 索引块作为 MMA 的 M 维,query 侧只填充到更小的 N 维。内核用异步拷贝预载 128-token 的 K 索引、预取下一页、用 HMMA 算 bfloat16 点积,每页约减为一个块分数。

优化四:网关侧多模态预处理
SMG(Serving Model Gateway)是一个 Rust 写的模型网关,位于 OpenAI 兼容 API 与推理引擎之间。除了路由和 tokenization,它对多模态模型做了最关键的一件事:在请求到达 GPU worker 之前,把所有视觉预处理在 CPU 上完成。
图像和视频输入在进入视觉编码器前需要大量 CPU 工作:下载、解码、抽帧、缩放、转成 patch 张量。这些活放进推理引擎会占用本该用于生成的资源。SMG 在网关全部搞定:取视频、用 FFmpeg 抽帧、按帧率选子集、缩放归一化、带时间维度地 patchify,输出一个扁平 patch 张量和一个小网格元数据张量,打包成 gRPC 消息——worker 直接跑视觉编码器,端侧零预处理。
SMG 的多模态管线围绕 Rust traits 组织,把模型特定预处理逻辑与管线管道代码分离。接入 M3 只需用 M3 特定常量实现这些 trait,管线本身零改动。同一架构适用于绝大多数带视觉的开源模型,可跨推理引擎运行时复用。

性能结果
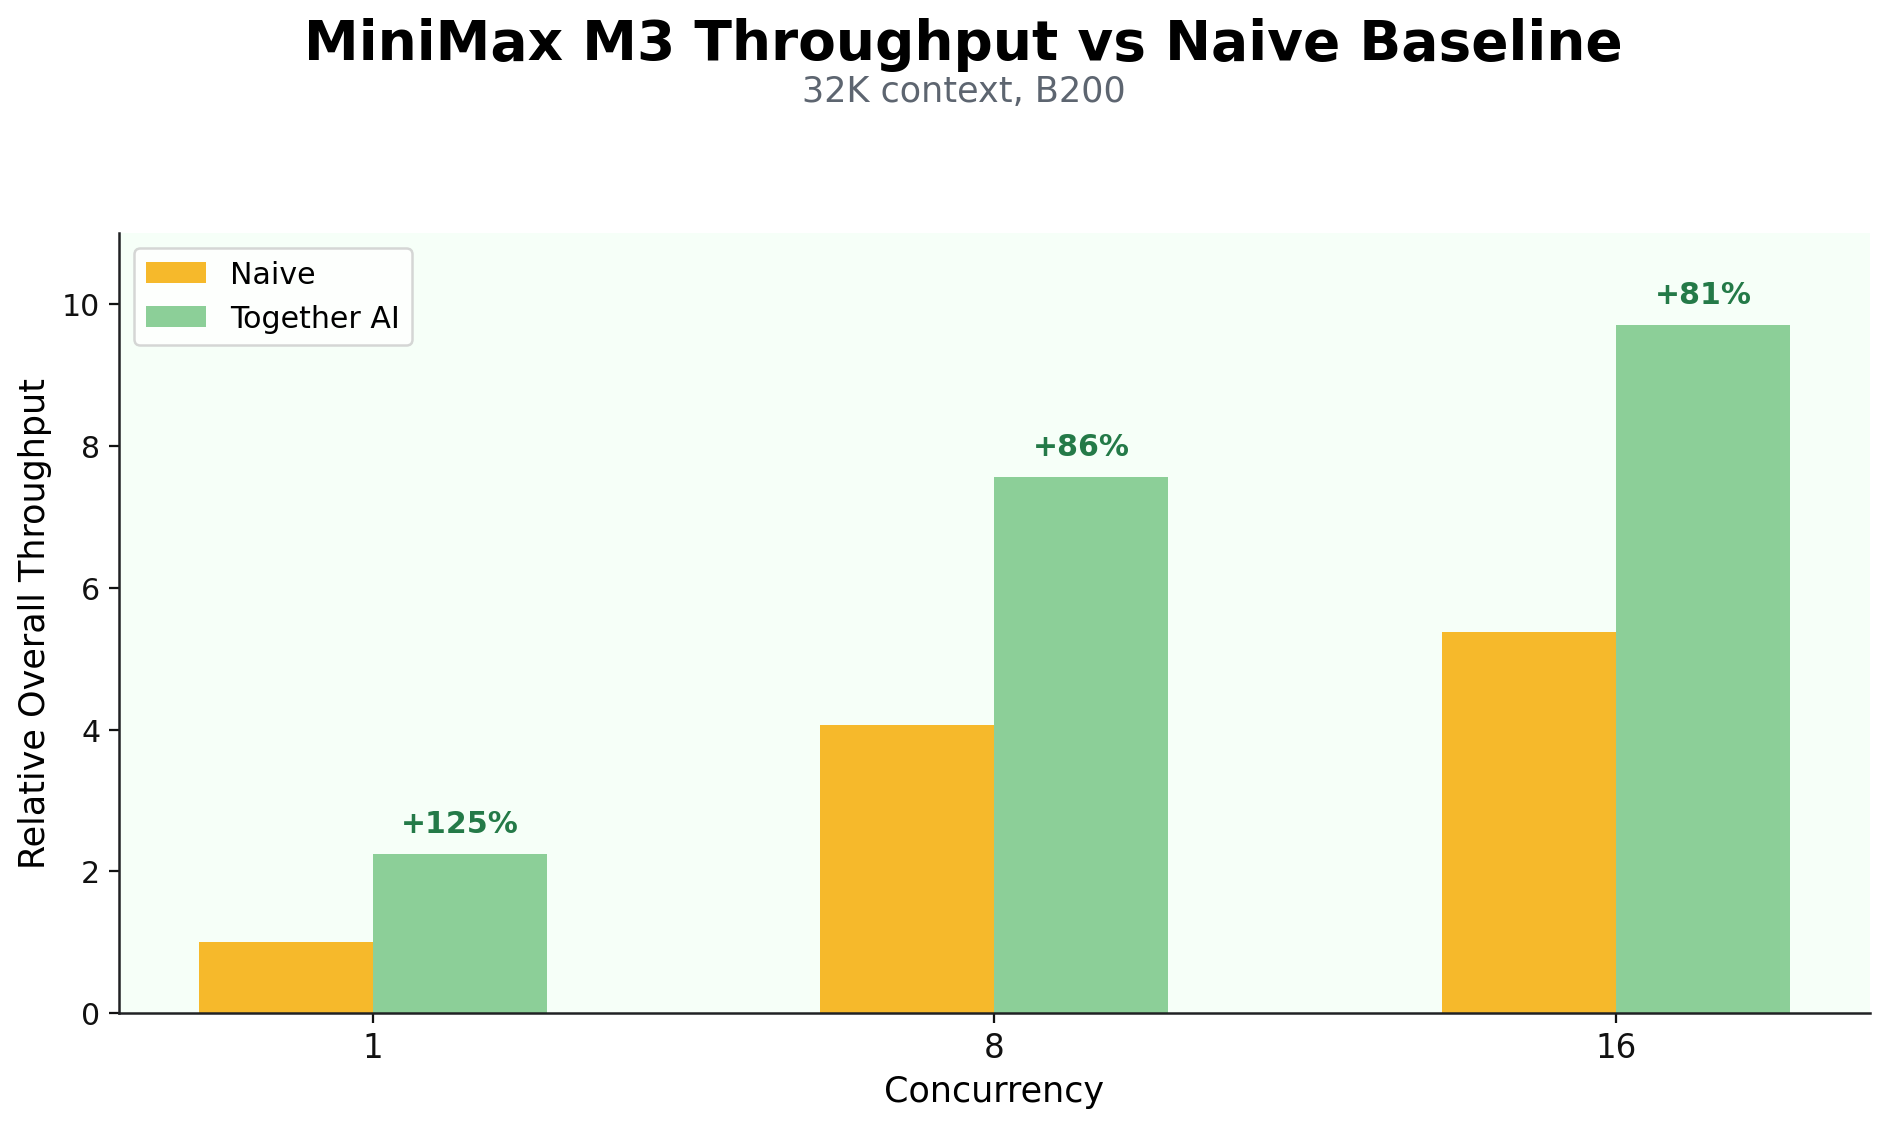
从拿到 M3 权重和架构起,Together 团队持续优化推理性能:在常见智能体流量形态下,各并发水平吞吐提升 81%–125%。
后续方向
新架构带来新的基础设施与工程挑战,团队正在推进两件事:其一,稀疏注意力架构引入更多小内核(KV 块 top-k、q-kv 映射重排等),存在大量内核融合机会,内核智能体研究团队正在开发能写生产级内核的智能体;其二,k-index 的 CPU cache offloading 与实际 KV cache 现在可以分离,正在实现全量加载 k-index、按 top-k 选择按需加载 KV cache。
原文信息
- 作者:Yubo Wang、Michael Granado、Connor Li、Jue Wang、Brian Mak、Wei Gong、Hiral Jasmani、Yineng Zhang、Dan Fu(Together AI)
- 发布时间:2026-06-02 原文地址:
点赞,必须点赞
收藏了,以后慢慢研究。
很有价值的分享,感谢整理。