前沿智能其实很便宜:GPT-6 Astra 对决开源模型,什么工作该换、什么工作该留
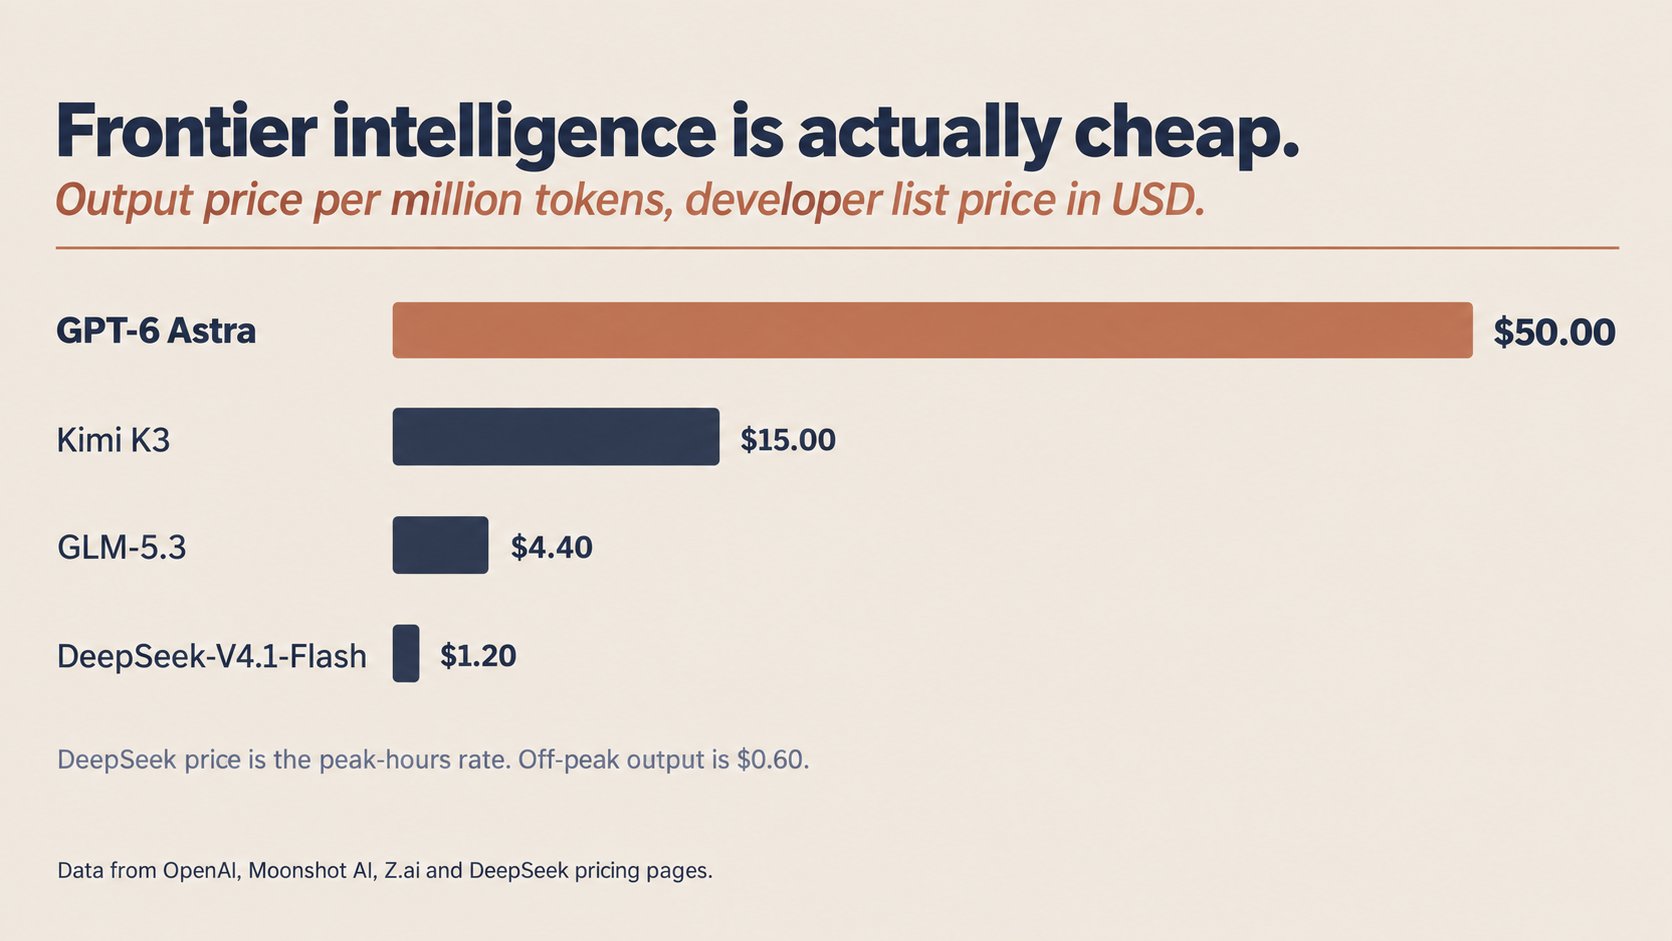
OpenAI 对 GPT-6 Astra 的定价是每百万输出 token 50 美元。DeepSeek 对 DeepSeek-V4.1-Flash 的定价是 1.2 美元,而在两家公司都发布了同一版本基准分数的那一项编码测试上,两个模型只差 0.1 分。超过 40 倍的价格,换来十分之一分的差距。
这就是全部问题所在。如果你在为 Astra 付费,你买到了哪些开源模型做不到的东西?对大多数工作来说,答案是你注意不到任何差别。例外是真实存在的,而且具体到可以一一点名。
本文的每一个数字都满足同一条标准:该模型的开发者和 OpenAI 都在同一个基准版本上发布了分数。我取自开发方自己的模型卡、README 和发布文章。
先弄清你的工作长什么样
在看任何数字之前,先把你自己的工作分成两类。
第一类是你描述清楚、模型就能做完的任务。修这个 bug、从这些资料里回答这个问题、起草这份文档、重构这个模块。任务有明确的终点,你可以检查结果。这是开源权重模型已经追上来的领域。
第二类是一台你整个交出去的电脑。模型打开应用程序、读屏幕、点击、输入、从遇到的任何状况中恢复,并且无人值守地运行几个小时。这是 OpenAI 发布了数据、而没有任何开源权重开发者发布可比数据的领域。
下文所有内容都按这条线整理。如果你知道自己的工作在哪一边,可以直接跳到你的章节。
编码
编码是大多数人正在做决策的岗位,它一分为二。
对于范围明确的活,数字是一样的。DeepSWE v1.1 是一个由有明确终点状态的真实仓库任务组成的基准。OpenAI 报告 Astra 得分 74.1。DeepSeek 报告 V4.1-Flash 得分 74.2。100 分制上 0.1 分的差距分不出高下,可以理解为平手。
唯一需要注意的细节是,OpenAI 没有说明它的分数由哪个 agent 框架产生,而 DeepSeek 说了(mini-SWE-agent),所以 OpenAI 之外没有人能把两次运行完全对齐。这是一个你无法验证的平手,也是不宣布任何一方获胜的理由。
对你的工作意味着什么:如果你的编码工作是工单、bug 修复、测试、重构和代码评审,就是你拿着清晰简报外包给承包商的那种活,你在为基准检测不到的差距支付 40 倍的 token 价格。
对于长时间无人值守的会话,数字就不一样了。Terminal-Bench 4.0 给 agent 一台真实终端和一个困难的多步骤任务,考察它能否完成。OpenAI 报告 Astra 得分 57.9。
DeepSeek 报告 V4.1-Flash 得分 31.2,发布于 2026 年 9 月 10 日,是 4.0 版本上的首个开源权重分数。差距是 26.7 分。在一个最好的模型也只能完成一半出头任务的基准上,这就是「你可以放心走开的 agent」和「你必须盯着的 agent」之间的差距。
对你的工作意味着什么:如果是模型驱动自己的环境连跑数小时,做资源调配、迁移、在没人检查每一步的系统里跨组件调试,Astra 能完成开源模型完成不了的任务,这 50 美元买到了真东西。
这个区间的选择是 DeepSeek-V4.1-Flash,前提是你能接受一个 2026 年 9 月 10 日才公开权重的新模型。
Kimi K3(DeepSWE v1.1 得分 67.5,输出 15 美元)和 GLM-5.3(66.9 分,4.40 美元)是公开记录更长的备选,两者都在 Astra 的 7 分以内。如果价格比最后几分更重要,GLM-5.3-Flash 在同一基准得 63.4 分、输出价格 0.50 美元,比 Astra 低 10.7 分,价格只有百分之一。

研究与知识工作
BrowseComp 测试模型能否通过搜索网络找到难以定位的事实。OpenAI 报告 Astra 得分 91.5。Moonshot AI 报告 Kimi K3 得分 91.2。
两家公司为同一个第三方模型 GPT-5.6 Sol 引用了相同的参考分 90.4,这是两家实验室测量了同一样东西的最好迹象。
在 GPQA Diamond(研究生级科学题)上,OpenAI 报告 Astra 得分 96.0,Moonshot AI 报告 Kimi K3 得分 93.5,2.5 分的差距,而两个模型在这个测试上都答对十分之九以上。
对你的工作意味着什么:查证事实、文献综述、研究综合、从长文档里回答问题、基于资料起草。差距在噪声范围内,而 Kimi K3 的输出价格是每百万 15 美元对 50 美元,不到三分之一。如果你不想依赖单一供应商,Qwen3.8-2.4T-A95B 在同一科学测试上落后 Astra 3.4 分。
结论?这里没有任何为 Astra 付费的理由。
电脑使用与陌生环境
这是 Astra 理由最充分的地方,也是开源模型证据缺失的地方。
OpenAI 报告 OSWorld 2.0 得分 72.6(模型操作真实桌面的基准),以及 ARC-AGI-3 得分 99.9——模型要在从未见过的环境里学习规则并高效行动。
OpenAI 的发布文章引用 ARC 奖金会的 Greg Kamradt,说 Astra 在 96% 的关卡上通过了人类行动效率基线。
没有任何开源权重开发者发布 ARC-AGI-3 分数。在 OSWorld 上,Moonshot AI 为 Kimi K3 发布了 58.3 分,但用的是与 OpenAI 不同的基准切分,两个数字无法并排放置。
OpenAI 还报告了 ScreenSpot-Pro(在屏幕上定位界面元素的测试)得分 92.7,同样没有开源权重开发者发布这项分数。
对你的工作意味着什么:如果你付费让 Astra 代你操作软件,或处理它没见过的情况,没有任何已发布证据表明开源模型能做这份工作。也没有已发布证据表明它不能,因为缺席不是分数。
稳妥的读法是:这是唯一一个 50 美元买到了开源模型没有证明自己能匹配的东西的工作负载,在任何开发者发布同版本分数之前,这一点不会变。
结论:留在 Astra 上,或者迁移前先在你自己的任务上跑自己的测试。不要假设编码结论可以直接搬过来,这是两种不同的技能。
切换在实践中意味着什么
开源权重给你两条路,值得诚实面对你会选哪一条。
路线一是下载权重。上面提到的每个模型(Qwen3.8-27B 除外)都运行在数千亿参数规模,六张模型卡没有一张说明需要什么硬件,每一张都把你指向 vLLM 或 SGLang 的部署方案。
唯一能装进单卡的 Qwen3.8-27B,在 DeepSWE v1.1 上落后 Astra 32 分,直接出局。
路线二是开发方自己的 API。DeepSeek、Moonshot AI 和 Z.ai 都以上述报价出售这些模型。输出价格便宜 3 到 40 倍,但本质还是租用:你的 prompt 发往他们的服务器,适用他们的条款。
许可证不会成为你选择的理由。六家全部是 MIT 或 MIT 式许可,附加条款只在收入超过 2000 万美元时才生效。
所以对大多数读者来说,「拥有你的技术栈」的实际含义是:先用 API,等 token 用量撑得起一台服务器时再迁到自己的硬件。并且随时保留迁移的选项,因为权重存在而 Astra 的不存在。
这个选项才是你真正拥有的东西,也是即使你从未下载过一个文件、这次对比依然值得做的理由。
决策
范围明确的编码、研究、写作,任何有明确终点、你能验收的活:换。想留一把 Astra 的 key 做抽查也行。
长时间自主的终端工作:留在 Astra。26.7 分的差距是真实的,没有任何开源权重开发者发布过缩小它的数字。
电脑使用与陌生环境:留下,或先在自己的任务上测试。两个方向都没有可信的开源权重数字。

Astra 于 9 月 3 日发布。在编码上与它打平的开源模型发布于 9 月 10 日。本文中的差距每周都在变动,所以在按任何分数行动之前,先核对每个分数的日期。
原文信息
作者:Alex(@alex_verem),AI 研究者 原文地址:
楼主辛苦了,内容很有参考价值。
讲解得很细致,新手也能看懂。
看标题就点进来了,内容果然没让人失望。
收藏了,以后慢慢研究。
作者写得真不错,学到了不少。
支持作者,持续关注中。
楼主辛苦了,内容很有参考价值。
写得挺用心的,支持一下。
刚好最近在找这方面的资料,太及时了。