不开剪映、不录音,用AI+代码做口播短视频:完整实操教程
最近把做短视频的工作流又升级了一遍,现在这条线已经比较稳定,从写稿到出成片基本不用自己动手剪。这篇把最新方案完整拆出来,你可以直接照着搭一套。
先说最终能做出什么:一条知识口播短视频,画面文字零错误、声音是本人音色、风格统一、后续可批量复用,全程不开剪辑软件、不录一句音。
先区分一个概念。这套做法不是用 AI 视频模型(Sora、可灵这类)输入一句话直接生成画面。视频模型生成的画面不可控,无法稳定呈现一句话、一组对比、一张清单,不适合知识口播。这套做法是:用 Remotion 框架以代码方式精确绘制画面,用 F5-TTS 克隆本人音色配音,写代码、配环境、渲染全部交给编程类 AI 完成。

01 最终效果与整体流程
成片规格:1920×1080 横版、30fps、H.264 + AAC、MP4,时长由配音决定(示例片 75 秒)。
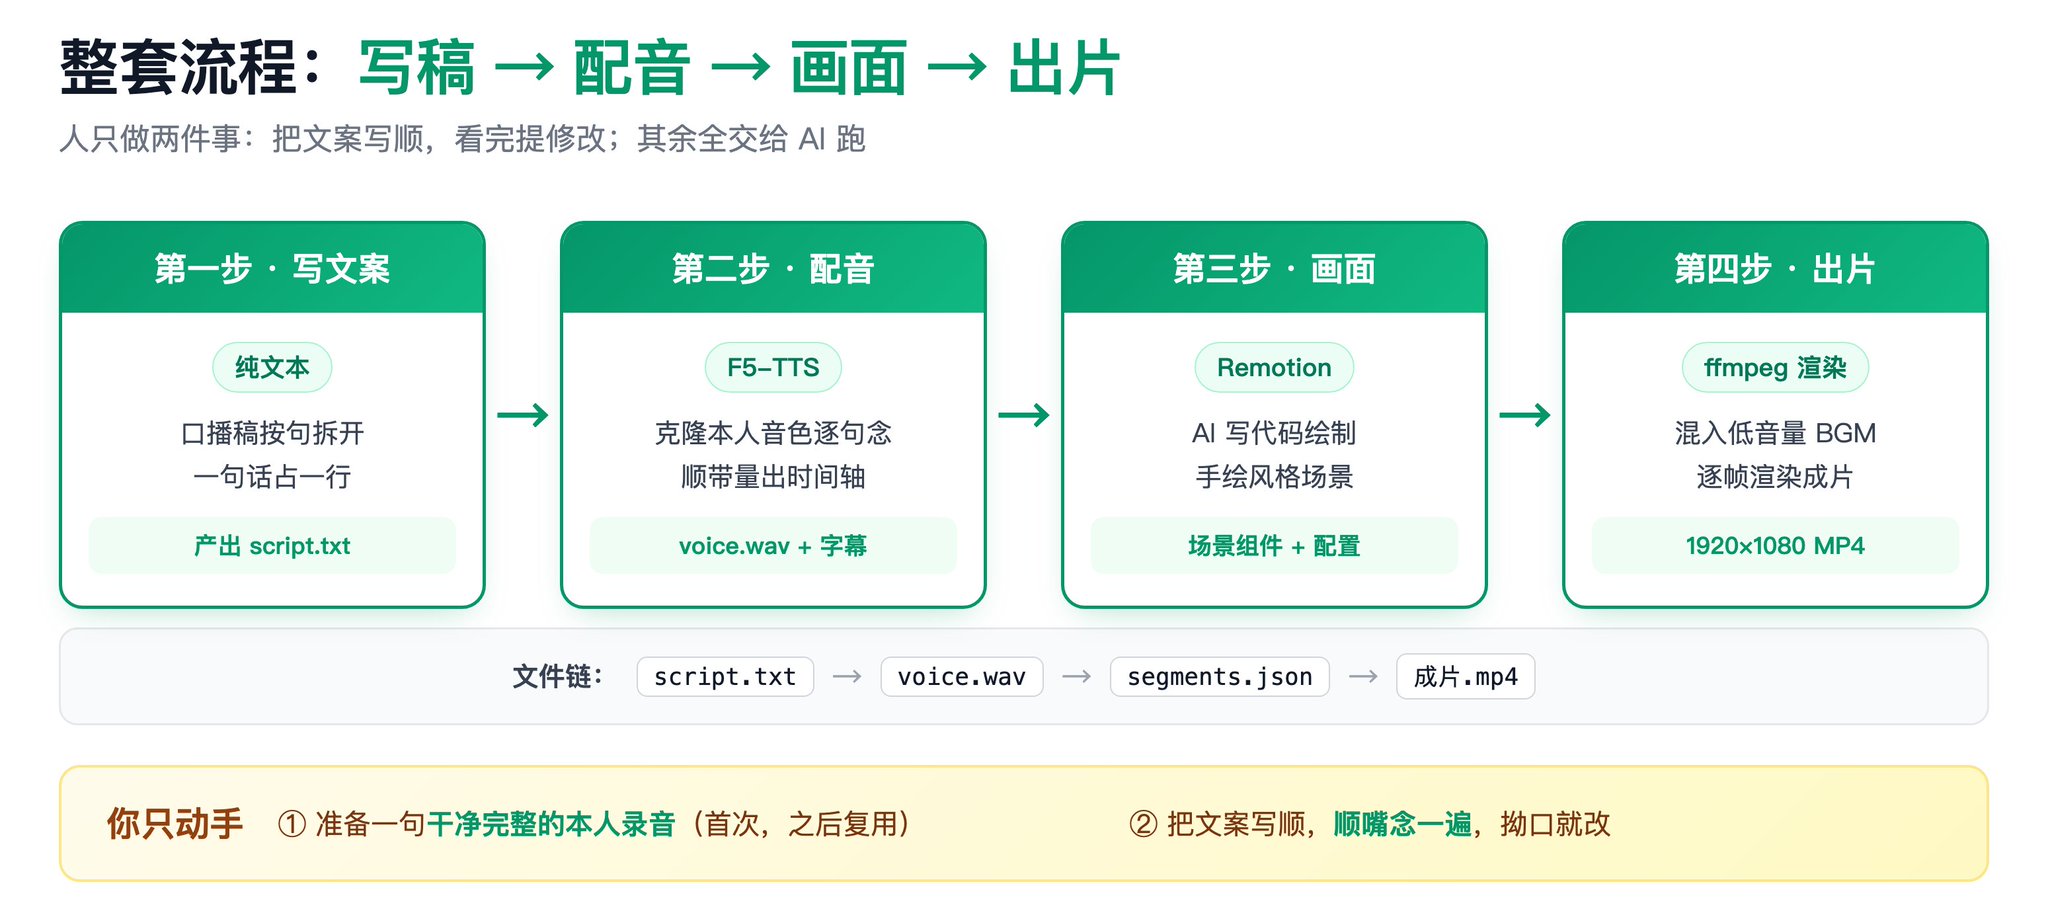
整条流程分四步:
- 写口播文案:一句一行,存成纯文本。
- 合成配音:F5-TTS 用本人音色逐句念出,同时生成逐句时间轴(即字幕时间轴)。
- 制作画面:AI 用 Remotion 按文案和时间轴写代码,绘制手绘风格场景。
- 混音渲染:ffmpeg 混入低音量背景音乐,Remotion 渲染出 MP4。
人只负责两件事:把文案写顺、审看成品并提出修改。
02 开始前准备
准备工作主要是两项:本机安装 F5-TTS 与 Remotion 环境,以及准备一段本人录音作为音色参考。

F5-TTS 模型首次运行自动下载(数 GB),之后离线可用。安装步骤直接让 AI 按 F5-TTS 官方文档在本机完成,无需手动操作。
03 第一步:写口播文案(一句一行)
格式要求:全文按句子拆分,一句话占一行,保存为 script.txt(UTF-8 纯文本)。示例:
老有人问我,AI越来越强,人到底还剩什么价值
我想了挺久,答案其实就四件事
这四件你亲自做,剩下的,都可以交给AI
第一件,定义问题,你到底要解决什么
参考量:一条 75 秒的片约 350 字、拆成 18 句左右。
为什么必须拆句:
- 逐句合成时,句号、问号后能产生长短不同的停顿,听感接近真人;整段合成会变成匀速念稿。
- 每句的起止时间直接对应一条字幕,省去后期字幕对齐。
注意事项:
- 写完通读(最好默念)一遍,拗口、不像口语的句子直接改,稿顺音频才顺。
- 每行控制在 20 字以内更适合字幕显示,长句在标点处断成两行。
产出:script.txt。
04 第二步:合成配音,顺带得到字幕时间轴
工具:F5-TTS(开源、本地、免费,录音不上传)。
原理:提供一段本人录音 + 该录音的文字(参考音频),模型记住音色;再逐句输入新文案,即用该音色念出新内容。
操作:让 AI 调用批量合成脚本,输入参考音频、参考音频文字、script.txt,输出整段配音和逐句时间轴。命令形态(参数由 AI 按实际环境填):
python f5_batch.py <参考音频.wav> "<参考音频对应文字>" script.txt voice.wav voice_segments.json mps 0.9 32
关键参数:
- speed=0.9:语速。
- nfe=32:音质档,固定用 32,不要为提速降到 16。
两个必须盯的点:
- 参考音频必须是一句完整的话,不能截在半句;其文字要和录音一字不差。截在半句会导致新音频开头带出参考录音的残字。有底噪可先让 AI 做降噪和响度归一化。
- 语速按数字调,不要凭感觉。知识口播真人语速约 200–230 字/分钟(取 210 上下)。用「句字数 ÷ 合成秒数 × 60」反算每分钟字数,超出区间就调 speed,一次即可定准。
产出两个文件:
- voice.wav:整段配音。
- voice_segments.json:逐句时间轴,每条形如:
{ "text": "我想了挺久,答案其实就四件事", "start": 4.51, "end": 7.43 }
字幕为何自动对齐:声音逐句合成,每句真实时长在合成时即被精确测量,因此字幕的文字(来自原稿,天然正确)和进度(来自时间轴,天然对齐)同时就绪,无需再用语音识别转写和改错字。
例外:若改用真人整段录音,则没有逐句时长,仍需用 Whisper 等语音识别生成时间轴。
05 第三步:用 Remotion 绘制画面
这一步是和「AI 一键生成视频」差别最大的环节,也是知识口播画面质量的关键。
原理:Remotion 把视频当网页(React 组件)渲染。标题、卡片、图标、柱状图、对勾叉号全部是代码绘制的矢量图形,放大不糊、位置精确、可逐帧控制。你不需要学 Remotion,由 AI 写组件。
5.1 规划场景
把文案按内容分组,每组对应一屏,并写一份场景标题清单 titles.txt,一行一个标题(第一行是封面标题)。示例片 350 字分 6 屏,封面 1 屏 + 内容 5 屏。
人只做这四件事,其他交给AI
定义问题,并且自己拍板
定好标准,AI才有章法
把每屏要呈现的内容用大白话描述给 AI,格式建议:屏幕标题 + 左侧放什么 + 右侧放什么 + 底部压一句什么。例如「左边放四条待办清单逐条点亮,右边一张蓝色说明卡,底部一句结论」。
5.2 画面规则(直接要求 AI 照做)
手绘质感分两层实现:
- 图形层:套一个很轻的 SVG 扭曲滤镜(feTurbulence + feDisplacementMap,scale 约 2.4),让方框和线条边缘轻微抖动,呈手绘感。
- 文字层:不套该滤镜。中文一旦跟随扭曲会发虚、看似缺笔画。

字体:中文用开源免费可商用的「霞鹜文楷(LXGW WenKai Screen)」,英文数字配手写体(如 Chalkboard SE)。字体文件需内联打包,避免无头渲染时缺字。
信息密度要求:每屏必须实际承载「说明、对比、案例」中至少一类,标准摆法是「主概念 + 若干具体例子 + 一句判断」。禁止无标签的小人头、空括号、纯图标无文字等占位元素。
封面即第一帧:开场做一张完整封面,主标题作钩子,停留 2.6 秒再进正文。平台抓首帧即得封面,无需另做。
字幕:底部居中,每行不超过十几个字,超长按标点拆两行,按时间轴进出,不加花哨特效。
5.3 静帧质检(必做,省返工)
整片渲染前,先让 AI 把每一屏渲染成静态图(renderStill),像翻 PPT 一样逐屏检查,专找三类问题:
- 文字与文字、文字与图形重叠;
- 图形压住标题;
- 元素拥挤、间距不足。
示例片在这一步查出并修掉三处:清单末条被底部卡片压住、柱状图顶到标题、封面装饰线与气泡贴连。静帧改完再渲整片,避免渲完才发现问题。
产出:通过质检的 Remotion 场景组件与场景时间配置。
06 第四步:混入背景音乐并渲染成片
背景音乐处理(ffmpeg):音乐从头到尾循环贯穿,音量压到比人声低约 15dB(约 -30dB 电平),只垫节奏不抢话;首尾各加淡入淡出;人声出现时轻微压低 BGM。
给 AI 混音时明确两个坑:
- 多轨混合默认会做音量归一化、把人声响度砍半,必须关闭归一化。
- BGM 闪避要轻(压缩比约 3、阈值 0.12)。压太狠会把整段话期间的 BGM 全压没,留下不自然的空档。
渲染:Remotion 用无头浏览器逐帧渲染,输出 1920×1080、30fps、H.264 视频 + AAC 音频的 MP4。75 秒成片渲染约 2–3 分钟。
产出:最终 MP4。
07 验收清单
成片出来后逐项检查:
- 封面在第一帧即完整、干净,无元素叠压;
- 字幕与配音逐句对齐,无错字;
- 背景音乐全程存在但不盖人声;
- 画面文字清晰不发虚、无重叠、无占位空图形;
- 视频参数为 1920×1080、30fps、H.264 + AAC。
建议从最终 MP4 抽几帧复核(封面帧、信息最密的一屏、结尾帧),因为改动封面需要整片重渲。
08 适用范围与成本
适合:需要持续产出知识口播、要求画面信息准确、不想手动剪辑的人。模板一旦做好,后续每条片复用同一套画面代码,改文案即可,改一句配音只重新合成那一句。
不适合:需要炫酷运镜、真人特效、电影感画面的内容(应用专业剪辑或视频模型);完全不想使用编程类 AI 的用户(直接用剪映更省事)。
首次成本:主要是安装环境和把画面模板调到满意,需要一次性投入。之后每条片约为写文案 + 合成配音(数分钟,后台运行)+ 渲染(2–3 分钟)。
09 核心结论
AI 做视频不等于只能靠视频模型一键生成。把 AI 当作会写代码、会执行流程的助手,跑通一套自己可控的技术方案,得到的是稳定、可复用、风格统一的成片。
新手建议从最短的稿子起步:先让 AI 跑通「配音 + 一屏画面」,再补齐其余场景和混音,最后连成完整流程。
原文信息
作者:xiaoluv12o(@xiaoluv12o) 原文地址:
这个比较实用,已转发给同事。
看标题就点进来了,内容果然没让人失望。
这篇文章分析得很透彻,收藏了!
支持作者,持续关注中。
这篇文章分析得很透彻,收藏了!
这个比较实用,已转发给同事。
作者写得真不错,学到了不少。
写得挺用心的,支持一下。