Together 微调平台大扩容:17 个新 AI 模型、实时实验追踪、专家层 LoRA 与早停退款
一句话结论
把一个开放权重 AI 模型调教成高性能任务模型,靠的是一连串测量精准的实验:团队得知道模型在什么数据上训练、每轮训练进展如何、该调整配方还是停手、哪个检查点最好。Together Fine-Tuning 本次扩容覆盖这条完整链路:新增 17 个最新开放权重模型(含 GLM-5.3、Kimi K2.7-Code、DeepSeek-V4-Flash)、训练全程实时指标追踪、专家层 LoRA、早停自动退款、数据预处理透明化,训练价格最高降 70%。
新模型清单按需求分层选
新开放权重模型几乎每次发布都在拉高质量或效率的标准线,团队想把新模型快速带进生产,不想花几周啃每个新架构的技术细节。本次新增按三类需求分层:
- 冲前沿性能:GLM-5.3 在 Terminal-Bench 2.1 拿 88.2 分,距最领先的闭源模型不到一分;同级还有 Kimi K2.7。
- 性能与成本平衡:Qwen 3.8-27B 或 Gemma 4。
- 端侧本地部署:Qwen 3.5 家族从 0.8B 到 9B 参数全档位。
提交 AI 训练任务后,架构相关的复杂度由平台在后台处理。
实验追踪:训练曲线实时可见
每轮实验的轨迹越早可见,下一个决策越早能做——是调数据、改超参还是放行跑完。本次更新让微调任务在每个训练和评估步骤都记录指标,直接通过 API、CLI 和控制台仪表盘暴露。
每个任务记录核心训练信号:损失、梯度范数、学习率。加了验证集后,评估损失和指标随训练指标同步追踪。仪表盘里每个任务有专门的指标页,曲线在任务运行中实时更新;还能选中多个任务画在同一坐标系上,一次参数扫描看成一整张图,不用开十几个浏览器标签。用 Python SDK 也一样:一条命令、终端里出曲线。


API 返回底层完整序列(每个记录步,可按区间过滤或降采样),可以直接拉进笔记本或已有内部仪表盘。
专家层 LoRA:让 MoE 模型真正学到新知识
混合专家(MoE)模型里,超过 90% 的参数和模型真正「知道」的东西都在专家层。标准 LoRA 微调从不碰它们——适配器挂在注意力层,专家层一直冻结。现在可以把 LoRA 适配器直接放到专家层上,让 AI 训练触达知识真正存储的那几层。
差距在需要模型学习全新知识的任务上最明显。Together 团队教模型 200 条虚构事实(基础模型一条都没见过):带专家层的适配器能召回最多 89% 的新知识,只挂注意力的适配器同一模型上只有 15%;前者还保留了更多既有知识,MMLU-Pro 直接胜出,75.3% 对 71.5%。

训练动力学解释了这个差距:只用注意力适配器时,被路由到的专家中越来越多在微调过程中掉出使用;带专家适配器则让整个混合专家体系保持活跃。

开启方法简单:把专家模块加进 lora_trainable_modules 即可,其余微调流程与普通 LoRA 任务完全一致。
早停与任意批大小
训练不再空烧钱:开启早停、提供验证集后,平台在每个评估点盯着验证损失,曲线走平就停掉任务,保留验证损失最好的检查点作为最终模型,没用掉的训练步数自动退款。耐心值、小改善敏感度、预热步数都可细调。
有些任务需要的批大小塞不进 GPU 内存:长序列、大模型或为超大全局批调的配方。现在用 gradient_accumulation_steps 让梯度跨微批累积后再做一次优化器更新,有效批大小等于批大小乘以梯度累积步数,想设多大设多大。
训练降价:最高 70%
训练栈持续优化后成本直降,LoRA 适配器每百万 token 训练价变动如下:Qwen3.5-9B SFT 从 0.48 降到 0.34 美元;Qwen3.8-27B 与 Gemma-4-31B 从 1.50 降到 1.05;gpt-oss-120b 从 5.00 降到 2.50(降 50%);gpt-oss-20b 降幅最大,SFT 从 1.50 降到 0.40(约 73%),DPO 从 3.75 降到 1.00。
数据处理透明化:训练前就能看 token 化结果
以前数据处理在微调任务里是个黑盒:看不到数据怎么被分词和打包。聊天模板用得和设想不一样、标签掩错位置、行被悄悄截断——质量下降却难溯源。现在训练开始前就能预览任意上传文件的分词结果,用即将微调的基础模型同款分词器和聊天模板,token ID、token 字符串、逐 token 标签、参与损失计算的字段区间、是否在最大序列长度处被截断,全部可见,预览几秒出结果。
训练后还能核对训练循环真正消费了什么:每个任务暴露一份完整准备好的数据集切片(分词、打包、整理成训练器收到的原样),通过 Python SDK 和任务页的下载链接都能拿。

三条配套能力:
- 样本权重。现代数据集常混合多来源多领域——人工标注配合成数据、一个领域配另一个领域——但默认每条样本对训练的影响力相同。现在在 JSONL 文件里给任意样本加 weight 字段,训练时按权重缩放它对损失的贡献,所有 JSONL 格式和训练方法都支持。
- 预检文件校验。数据集校验以前在训练任务里跑:文件第 59000 行有个坏的工具调用,要等任务排队、调度、启动后才发现。现在 JSONL 一上传完就触发完整服务端检查,结果落在文件对象上,建任务前就能看到问题。检查覆盖全部结构:消息结构与角色、工具定义与调用/响应对、推理字段、多模态内容与图片解码、偏好对结构、样本权重类型与范围,报错带具体样本序号。校验成功还报告检测到的数据特征(格式、行数、是否含权重/工具/推理轨迹/图片),确认平台按你的本意读了数据。
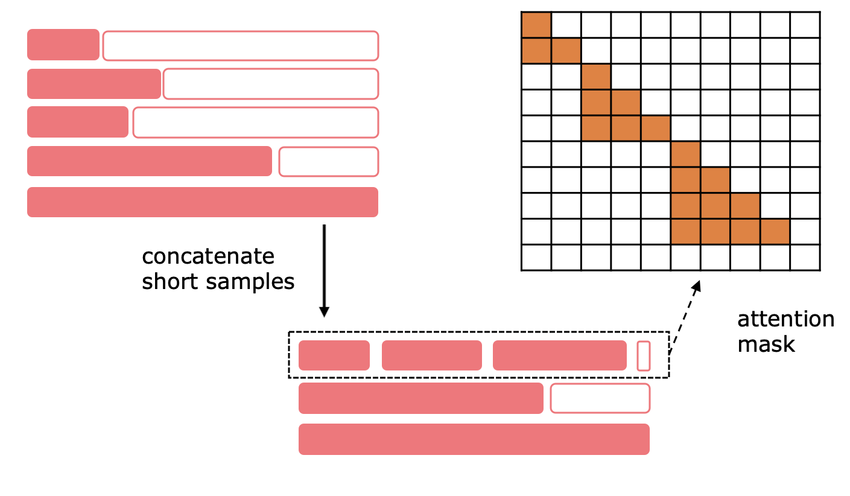
- 打包控制。序列打包把多条序列拼成一条省去填充浪费,默认开启。但小数据集上打包会让每轮优化步数太少。现在可以一个开关整体关掉,或用预分词数据里的
position_ids精确控制打包程度。
下一步:边训边部署
即将支持训练中途部署中间 LoRA 适配器:不用等整个任务跑完,第一个适配器一保存就能通过专用模型推理部署,或挂到已运行端点的 Multi-LoRA 配置上,省掉每个实验单开端点的成本与启动时间。首批支持 GLM-5.3,随后 Kimi K3。
原文信息
- 作者:Together AI
- 发布时间:2026-09-11 原文地址:
内容翔实,正好需要,先收藏再看。
刚好最近在找这方面的资料,太及时了。
收藏了,以后慢慢研究。