为什么 AI 生成的视频为什么总是"哑巴"?
一句话结论
LTX-2 是 Lightricks 开源的音视频联合生成模型:文字进、声画同步视频出。核心是非对称双流架构(140 亿参数视频流 + 50 亿参数音频流)加双向交叉注意力,推理速度比同级 Wan 2.2 快约 18 倍,最长生成 20 秒。选视频生成工具时,它是少数免费开源且自带同步音频的选项。
为什么 AI 生成的视频为什么总是”哑巴”?
只有少数如 Veo3 和 Sora 2 等最新视频模型才有音画同步?
打开其他视频模型,生成的画面确实很震撼,人物表情生动,动作流畅,光影逼真。
但你会发现一个问题,整个视频是静音的。
人物张着嘴,但你听不到声音,车辆驶过,但没有引擎轰鸣,海浪拍打礁石,却听不见水花飞溅。
这就好比在看一部无声电影,视觉再精彩,少了声音,整个体验都不完整。
为什么会这样?
因为大多数 AI 视频模型只学会了”看”,没学会”听”。
视觉和声音,在 AI 的世界里是两个独立的任务。
想要视频有声音,得先生成视频,再用另一个模型给视频”配音”(Video-to-Audio,V2A)。
或者反过来,先生成音频,再根据音频生成视频(Audio-to-Video,A2V)。
但这种”分步走”的方式有个根本问题,声音和画面是相互影响的。
比如一个人在空旷的大厅说话,声音会有回声,但如果在小房间说话,声音就会被吸收。
视觉决定了声音的特征,声音也反映了视觉的环境。
你不能先单独生成一个视频,再让 AI 去”猜”应该配什么声音,就像你不能先写好一篇文章,再让 AI 去”猜”作者的写作意图。
Lightricks(就是做 FaceTune 和 Videoleap 的那家公司)最近发布了 LTX-2,一个真正意义上的”音视频联合生成”模型。
音视频联合生成(Text-to-Audio+Video,T2AV),从一段文字描述,同时生成匹配的视频和音频,并且声画同步。不是先生成视频再配音,也不是先生成音频再画视频,而是同时学习视觉和听觉的联合分布。
听起来很简单,但实现起来非常难。
为什么联合生成这么难?
最直接的办法是,把视频模型和音频模型”拼”在一起,让它们同时工作。
但这样做会遇到几个问题。
第一,视频和音频的”信息量”不对等。
视频是三维的(宽×高×时间),一帧 1080p 的视频有 200 多万个像素,每秒 30 帧,数据量巨大。
而音频只是一维的(时间),一秒钟的音频只有几万个采样点。
如果用同样大小的模型处理视频和音频,要么视频模型不够用(画面模糊),要么音频模型太浪费(用不完)。
Transformer,一种神经网络架构,核心是”自注意力机制”(Self-Attention)。可以想象成你在读一句话时,会自动关注句子中最重要的几个词,而不是平均分配注意力。Transformer 让 AI 能够”看到”输入数据的全局结构,而不是一个个局部处理。
如果用对称的双流 Transformer(两个模型大小一样),视频流的参数不够,画面质量下降,音频流的参数过剩,训练和推理都浪费。
第二,视频和音频的”节奏”不一样。
视频的运动是空间+时间的,一辆车从左边移动到右边,这是空间维度的变化。
而音频只有时间维度,车的引擎声从小到大再到小,这是纯时间的变化。
位置编码,告诉 AI”这个元素在哪里”。对于文本,位置编码是一维的(第 1 个词、第 2 个词…);对于图像,是二维的(第 x 行、第 y 列);对于视频,是三维的(第 x 列、第 y 行、第 t 帧)。音频只需要一维的时间位置,但视频需要三维的时空位置。
如果用同样的位置编码,音频会被迫处理它不需要的空间信息,视频又会丢失空间细节。
第三,声音和画面的”同步”很微妙。
人说话的时候,嘴唇动作和声音必须严格对齐,差几十毫秒你就能感觉到”对不上”。
一个物体掉落,撞击的瞬间必须有声音,早了或晚了都很假。
这种同步不是简单的”时间对齐”,而是因果关系。
嘴唇张开是因为要发”a”的音,物体撞击地面是因为有重力和碰撞,声音是物理事件的结果,不是独立的存在。
要让 AI 学会这种因果关系,不能只是把视频和音频”粘”在一起,而是要让它们真正”对话”,互相影响,共同演化。
LTX-2 的核心设计:非对称双流架构

LTX-2 的解决方案是,用两个不同大小的 Transformer 分别处理视频和音频,但通过”交叉注意力”让它们互相看见对方。
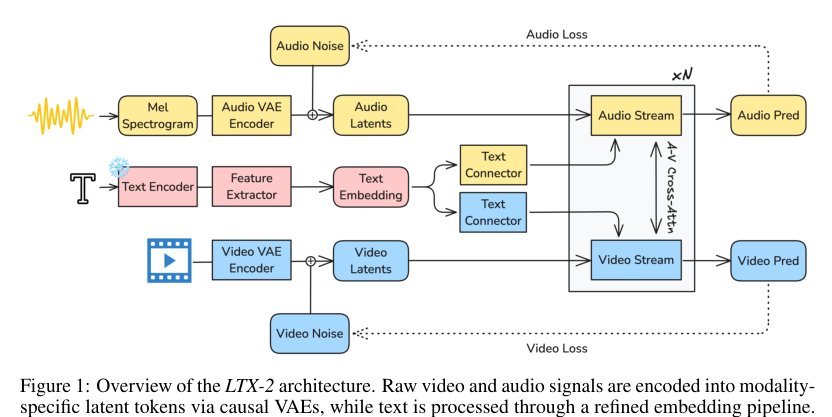
图 1:LTX-2 的整体架构。视频和音频信号通过各自的 VAE 编码器压缩成潜在表征(latent tokens),文本通过精细化的嵌入管道处理,然后双流 Transformer 通过双向交叉注意力联合去噪视频和音频潜在表征,最终生成同步的音视频输出。
非对称双流:给视频更多资源
视频流用了 140 亿参数,音频流只用了 50 亿参数。
为什么这样设计?因为视频的复杂度远高于音频。
参数,神经网络中的”权重”,可以理解为 AI 的”知识量”。参数越多,模型能记住的模式和细节越多,但计算量也越大。
140 亿参数的视频流可以处理复杂的空间纹理(比如人脸皮肤的细节)、运动动态(比如头发飘动)、光影变化(比如日落时的色温)。
而 50 亿参数的音频流足够处理语音的音调、节奏、情绪,以及环境音(背景音乐、脚步声、车辆声)。
这就像一家公司,销售部门人多(视频流),因为要处理复杂的客户需求,而财务部门人少(音频流),因为规则相对固定。
资源分配要匹配工作复杂度。
独立的潜在空间:不强行”混合”
很多多模态模型会把不同模态的数据”压”到同一个潜在空间里,比如 CLIP 把图像和文本映射到同一个向量空间。
但 LTX-2 不这样做,视频和音频用各自的 VAE 编码器,生成各自的潜在表征。
VAE(Variational AutoEncoder,变分自编码器),一种压缩技术,把高维数据(如图像、音频)压缩成低维的”潜在表征”(latent representation),就像把一本厚书浓缩成摘要。去噪时只需要处理这个摘要,最后再”解压”成完整的图像或音频。
为什么不合并潜在空间?因为视频和音频的”压缩率”不一样。
视频需要高度压缩,不然数据量太大。
一秒 30 帧的 1080p 视频,压缩成潜在表征后,每个 token 代表一个小的时空块(比如 16×16 像素×4 帧)。
而音频的压缩率可以低一些,每个 token 代表约 1/25 秒的音频。
如果强行用同一个潜在空间,要么视频压缩过度(画面模糊),要么音频压缩不够(浪费算力)。
独立的潜在空间让每个模态都用最适合自己的压缩方式。
更重要的是,独立的潜在空间让模型天然支持条件生成,给定视频生成音频(V2A),或给定音频生成视频(A2V),不需要额外的训练。
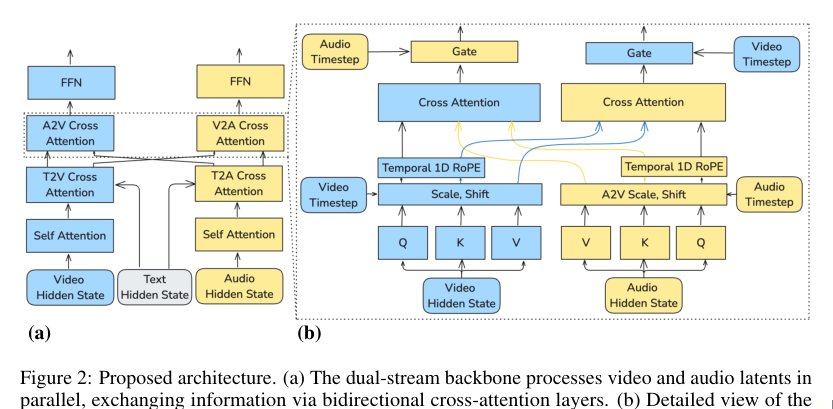
图 2:双流架构的详细设计。(a) 视频流和音频流并行处理各自的潜在表征,通过双向交叉注意力交换信息。(b) 交叉注意力模块的细节,使用时间维度的 1D RoPE 对齐位置,使用跨模态 AdaLN 实现时间步条件控制。
交叉注意力:让声音和画面”对话”
LTX-2 的关键创新是双向交叉注意力。
在每一层 Transformer 块里,视频流可以”看到”音频流的特征,音频流也可以”看到”视频流的特征。
这种双向的信息流让模型能够学习到声音和画面的因果关系。
交叉注意力,让一个序列”看见”另一个序列的机制。比如在机器翻译中,目标语言的每个词会”注意”源语言中最相关的几个词。在 LTX-2 中,视频的每个时空块会”注意”音频中最相关的时间片段,反之亦然。
举个例子,一个人在说话,视频流看到嘴唇的动作(视觉信息),通过交叉注意力,音频流知道”现在应该生成对应的语音”。
同时,音频流生成的语音特征(比如音调、音量)反过来影响视频流,让 AI 知道”嘴唇应该张多大、表情应该多夸张”。
这种双向影响不是后处理,而是在生成过程中实时发生的。
更妙的是,交叉注意力只用 1D 时间位置编码(Temporal RoPE),不考虑空间位置。
RoPE(Rotary Position Embedding,旋转位置编码),一种位置编码方式,通过旋转向量来表示位置关系。RoPE 的优点是可以自然地外推到训练时没见过的长度(比如训练时只见过 10 秒的视频,推理时可以生成 20 秒)。
为什么只用时间维度?
因为同步主要是时间上的对齐,而不是空间上的对齐。
一辆车从画面左边移动到右边,音频不需要知道车在画面的哪个位置,只需要知道车”现在”经过了,“现在”应该有引擎声。
时间对齐是核心,空间位置是次要的。
通过只关注时间维度,交叉注意力可以更精确地捕捉”撞击的瞬间""说话的节奏""音乐的鼓点”这些需要亚帧级对齐的事件。
当画面中有人说话时,音频流的注意力会聚焦在说话人的嘴唇区域,当有车辆驶过时,注意力会追踪车辆的运动轨迹。
这种”动态跟踪”能力让生成的声音更加真实,空间感更强。
跨模态 AdaLN:共享时间步信息
在扩散模型中,去噪过程是一步步进行的,每一步都有一个”时间步”(timestep),告诉模型”现在去噪到哪一步了”。
扩散模型,一种生成模型,通过逐步去除噪声来生成数据。想象你有一张模糊的照片,扩散模型一步步去除模糊,最终恢复出清晰的图像。去噪过程需要很多步(比如 50 步),每一步都去除一部分噪声。
LTX-2 引入了跨模态 AdaLN,让视频流和音频流共享时间步信息。
AdaLN(Adaptive Layer Normalization),一种条件归一化技术,根据外部条件(如时间步、文本嵌入)动态调整归一化的参数。就像你根据天气(外部条件)调整穿衣厚度(归一化参数)。
具体来说,视频流在某一层的归一化参数,不仅取决于视频流自己的时间步,还取决于音频流的时间步。
反之亦然。
为什么要这样做?因为视频和音频的去噪速度可能不一样。
视频的细节多,可能需要更多步数才能生成清晰的画面。
音频的细节少,可能更快就能收敛。
如果两个流独立去噪,可能会出现”视频还很模糊,音频已经很清晰”的情况,导致声画不匹配。
跨模态 AdaLN 让两个流能够”感知”对方的去噪进度,自动调整步调,保持同步。
文本理解:让 AI”读懂”你的描述
除了视频和音频,LTX-2 还有一个重要的输入:文本描述。
你可能会想,文本理解有什么难的?不就是把一段话输入到语言模型,提取特征,然后用这些特征去条件生成吗?
但对于音视频生成来说,文本理解的要求远比你想象的高。
举个例子,你输入”一个女孩用法语说’Bonjour, comment ça va?’,声音温柔,带着一点害羞”。
这段描述包含了:
- 语义信息:“女孩""法语""问候”
- 音素信息:“Bonjour”的发音,“comment”的鼻音
- 情感信息:“温柔""害羞”
- 韵律信息:语调的起伏,停顿的位置
AI 不仅要理解你在说什么,还要理解”怎么说”,甚至要理解”为什么这样说”。
多层特征提取:不只用最后一层
LTX-2 用的是 Gemma3-12B 作为文本编码器。
Gemma3-12B,Google 开发的一个 120 亿参数的语言模型,采用 decoder-only 架构(只有解码器,没有编码器),类似 GPT。它能够理解多种语言,包括法语、西班牙语、中文等。
但 LTX-2 不只是用 Gemma3 的最后一层输出,而是提取所有层的中间特征,然后融合起来。
为什么?
因为语言模型的不同层关注不同的信息。
- 浅层(前几层),关注词汇和音素。“Bonjour”是哪几个音节,“comment”的鼻音怎么发。
- 中层(中间几层),关注语法和语义。“Bonjour”是问候语,“comment ça va”是询问”你好吗”。
- 深层(后几层),关注上下文和情感。“温柔”意味着音调要柔和,“害羞”意味着音量可能较小,说话可能有停顿。
如果只用最后一层,浅层的音素信息会丢失,生成的语音可能发音不准。
如果只用浅层,深层的情感信息会丢失,生成的语音可能缺乏表现力。
所以 LTX-2 把所有层的特征拼接起来,用一个可学习的投影矩阵压缩到统一的维度,这样既保留了音素细节,又保留了语义和情感。
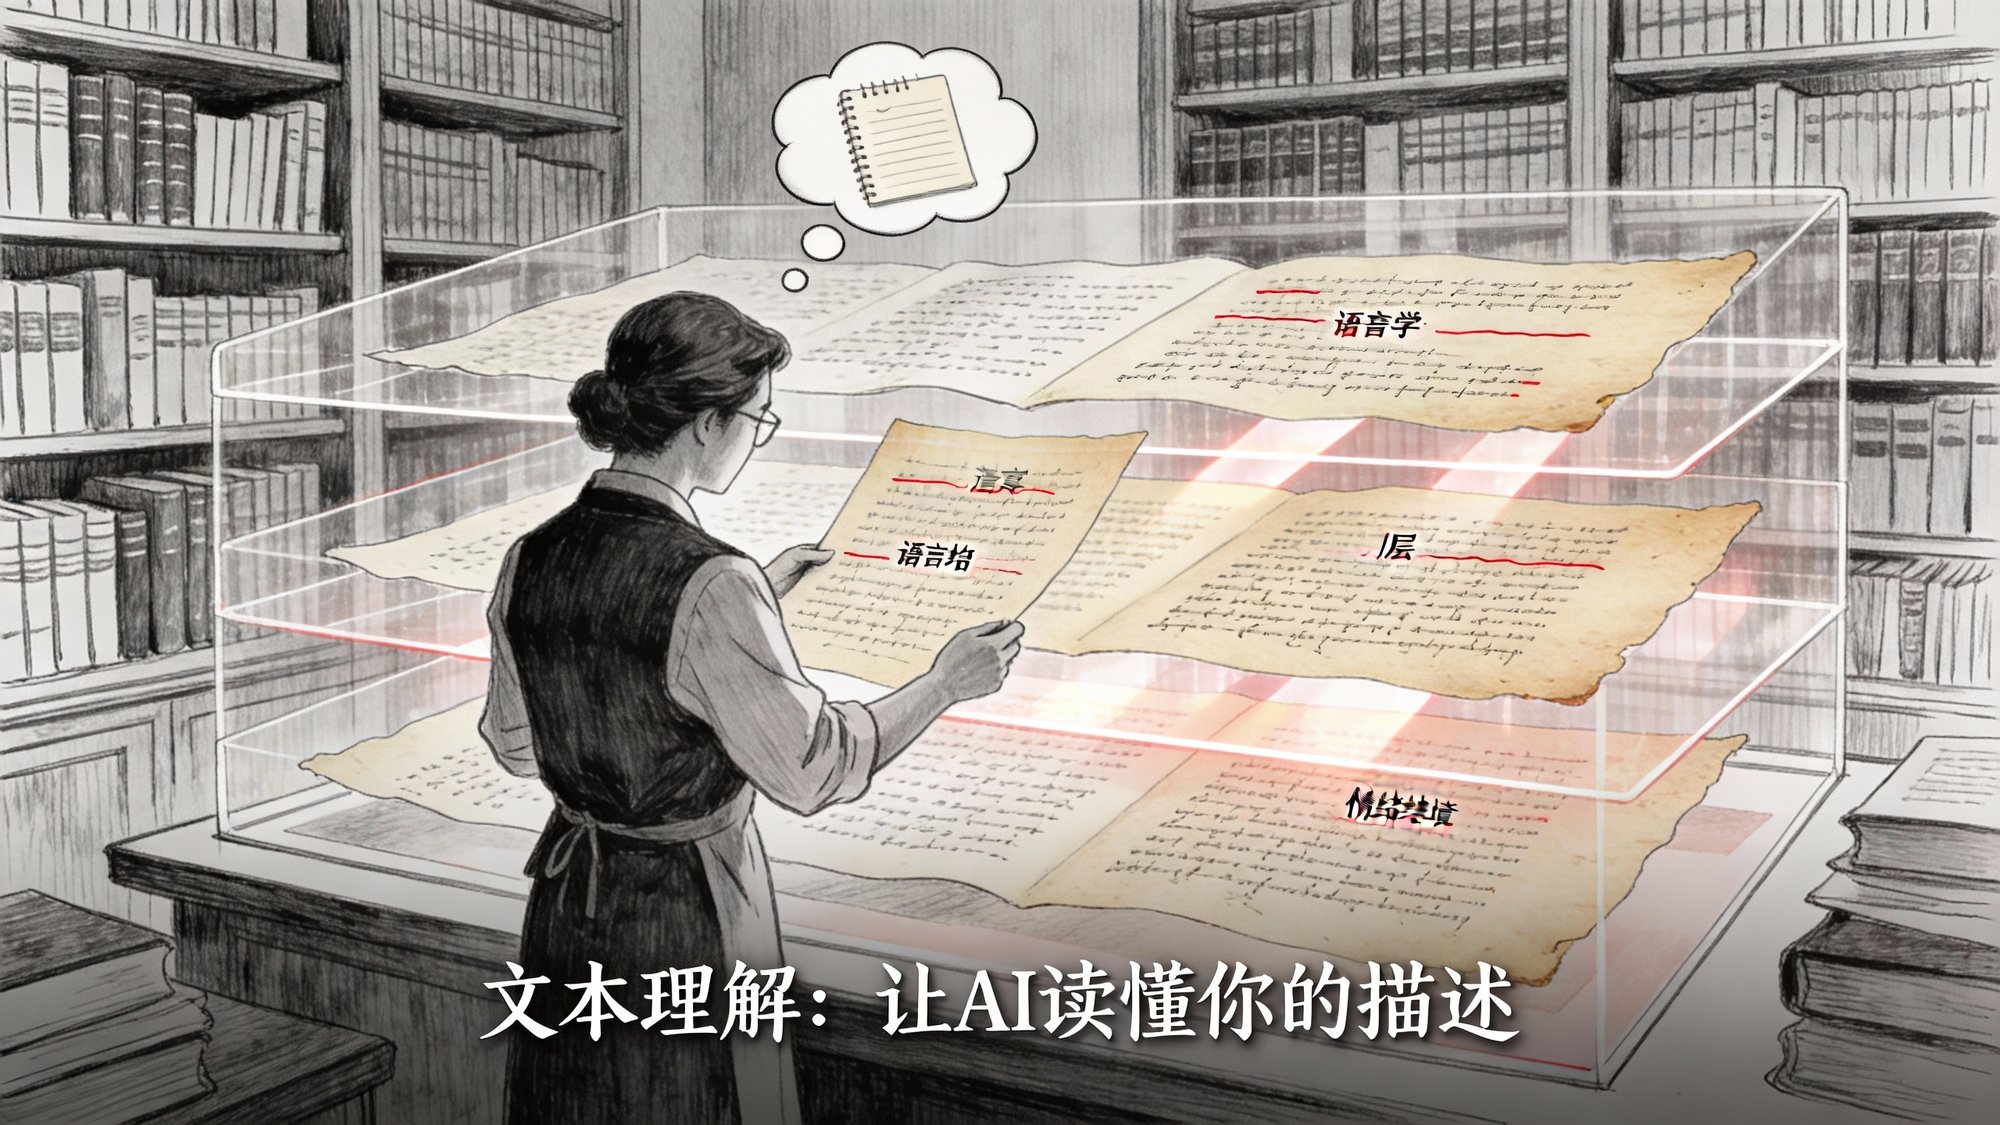
图 4:文本理解管道。文本提示通过 Gemma3 编码,然后经过特征提取器和文本连接器进行精细化处理,最终条件化各自的模态流(视频流和音频流)。
Thinking Tokens:给 AI”思考”的空间
更有意思的是,LTX-2 引入了 Thinking Tokens(思考令牌)。
在文本嵌入序列的末尾,LTX-2 会追加一些”空白”的 token,让模型自己去”填充”这些 token,用它们来存储”全局信息”或”缺失的细节”。
Token,可以理解为一个”信息单元”。对于文本,一个 token 可能是一个词或一个词的一部分(如”running”可能被分成”run”和”##ing”两个 token)。对于图像,一个 token 可能是一小块像素。
为什么需要 Thinking Tokens?
因为有些信息不容易在文本中直接表达,但 AI 需要它。
比如,“一个女孩害羞地说话”,AI 怎么知道”害羞”对应的音量、音调、停顿模式是什么?这些细节在文本描述中是模糊的,但在生成时是具体的。
Thinking Tokens 给了 AI 一个”缓冲区”,让它可以在生成之前,先”思考”一下,把模糊的文本描述转化成具体的生成参数。
这就像你在写作之前会先在脑海里整理思路,把抽象的想法转化成具体的句子。
Thinking Tokens 是 AI 的”草稿纸”。
双向注意力:弥补因果注意力的局限
Gemma3 是 decoder-only 架构,用的是因果注意力(Causal Attention),也就是每个 token 只能看到它前面的 token,看不到后面的 token。
因果注意力,一种单向的注意力机制,确保生成过程是自回归的(从左到右,一个 token 接一个 token 生成)。就像你写文章时,只能根据已经写好的内容来决定下一句要写什么,不能”偷看”后面的内容。
这对于文本生成是合理的,因为你不知道后面要写什么。
但对于文本理解来说,这是一个限制。
比如,“一个女孩用法语说’Bonjour’,声音温柔”,“温柔”这个词在句子的后面,但它应该影响整个句子的理解,包括”Bonjour”的发音和音调。
如果只用因果注意力,“温柔”只能影响它后面的词,影响不了前面的”Bonjour”。
所以 LTX-2 在 Thinking Tokens 部分用了双向 Transformer 块,让每个 token 可以看到整个序列(包括前面和后面的 token),充分整合上下文信息。
这样,“温柔”的信息可以”回流”到”Bonjour”,让 AI 知道”Bonjour”也应该带着温柔的语调。

推理阶段的工程细节
多模态分类器自由引导
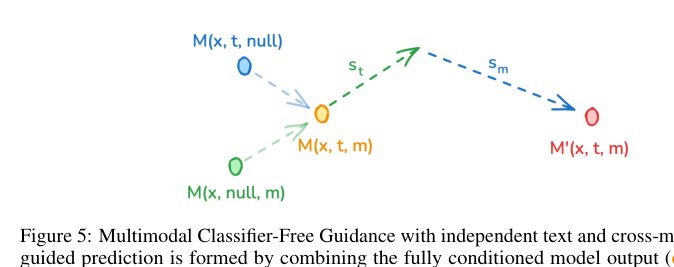
LTX-2 在推理时用了两个引导强度参数:st 控制文本引导,sm 控制跨模态引导。
比如,如果你的文本描述很详细(“一个女孩用法语说’Bonjour’,声音温柔,带着一点害羞,背景有鸟叫声”),你可能希望文本引导强一点(st 大),跨模态引导弱一点(sm 小),让生成严格遵循文本。
但如果你的文本描述很简单(“一个人说话”),你可能希望跨模态引导强一点(sm 大),让视频和音频自己”协商”出更自然的结果,比如根据人物的表情自动调整音调。
LTX-2 在实验中发现,视频流用 st=3、sm=3,音频流用 st=7、sm=3,效果最好。
引导强度参数,类似于”调味料”。st 是”盐”,控制文本的咸度,sm 是”糖”,控制跨模态的甜度。不同的菜(场景)需要不同的调味(参数)。

图 5:多模态分类器自由引导,独立控制文本和跨模态引导。引导预测由完全条件化的模型输出(橙色)与两个引导方向组合而成:文本引导项(绿色,由 st 缩放)和跨模态引导项(蓝色,由 sm 缩放)。这支持在推理过程中独立控制文本条件和跨模态对齐。
多尺度多分块推理
生成高分辨率视频(如 1080p)时,如果一次性处理所有像素,显存会爆炸。
LTX-2 采用了多尺度多分块推理。
- 基础生成,先在低分辨率(约 0.5 Megapixels)生成一个”草图”,确定场景的全局布局、运动和音视频同步。
- 潜在上采样,用一个专门的上采样模块,把低分辨率的潜在表征放大到高分辨率。
- 分块精细化,把高分辨率的潜在表征切成小块(tile),每一块单独精细化,添加细节(如皮肤纹理、发丝),然后在潜在空间中混合,避免接缝。
- VAE 解码,最后用 VAE 解码器把精细化后的潜在表征解码成 1080p 的视频帧。
这个策略就像画画,先用铅笔勾轮廓,再用细笔描细节。
分阶段处理,既节省显存,又保证质量。
实验结果:速度和质量的双赢
音视频质量:超越开源,接近闭源
Lightricks 团队做了人类偏好实验,让评估者对比 LTX-2 和其他模型生成的视频,从视觉真实感、音频保真度、时间同步(如唇同步、拟声效果)三个维度打分。
结果显示:
- LTX-2 明显优于开源模型 Ovi,在所有维度上都有显著优势。
- LTX-2 接近闭源模型 Veo 3 和 Sora 2 的水平,在某些场景下甚至超越它们。
这说明LTX-2 的联合生成策略和非对称双流架构是有效的,不需要海量参数和算力,也能达到一流水平。
视频质量:保持领先
虽然 LTX-2 是音视频联合模型,但视频流的质量没有下降。
在 Artificial Analysis 的公开排名中(2025 年 11 月 6 日数据):
- 图生视频排名第 3
- 文生视频排名第 4
- 超越了闭源的 Sora 2 Pro 和开源的 Wan 2.2-14B
这说明联合训练不仅没有损害视频质量,反而可能有协同效应,因为音频信息可以帮助视频更好地理解场景(比如环境音暗示了场景的空间特征)。
推理速度:碾压级优势
最震撼的是推理速度。
团队对比了 LTX-2(190 亿参数,音频+视频)和 Wan 2.2-14B(140 亿参数,只有视频)在 H100 GPU 上的推理速度。
测试条件:121 帧,720p 分辨率,单步 Euler 求解器,CFG=1。
| 模型 | 模态 | 参数量 | 每步耗时 |
|---|---|---|---|
| Wan 2.2-14B | 只有视频 | 140 亿 | 22.30 秒 |
| LTX-2 | 音频+视频 | 190 亿 | 1.22 秒 |
LTX-2 比 Wan 2.2 快了约 18 倍!
为什么 LTX-2 参数量更大(190 亿 vs 140 亿),但速度更快?
关键在于潜在空间的设计。
LTX-Video(LTX-2 的视频流基础)采用了极度压缩的深度潜在空间,每个 token 代表更大的时空块,token 总数更少。
而 Wan 2.2 的潜在空间压缩率较低,token 数量更多。
潜在空间的大小,就像压缩文件的大小。同样的内容,压缩率高的文件更小,传输更快,但解压需要时间。LTX-2 在训练时就优化了”压缩-解压”的平衡,让推理时的 token 数量最少,解码时的质量损失最小。
此外,由于非对称双流设计,LTX-2 把大部分参数分配给视频流,音频流只有 50 亿参数,计算量很小。
相比之下,Ovi 用的是两个对称的 50 亿参数流(总共 100 亿参数),虽然参数量少于 LTX-2,但没有优化潜在空间,速度反而更慢。
这就是架构设计的力量,不是参数越多越好,而是要”花在刀刃上”。
时长能力:最长 20 秒
LTX-2 可以生成最长 20 秒的连续视频和音频,超过了大多数竞争对手:
- Veo 3,12 秒
- Sora 2,16 秒
- Ovi,10 秒
- Wan 2.5,10 秒
20 秒是什么概念?足够讲完一个简短的故事,或者展示一个完整的场景。
比如,“一个女孩在海边弹吉他,唱了一首歌,然后笑着向镜头挥手”,这个场景至少需要 15-20 秒才能完整呈现。
更长的时长意味着更强的叙事能力。
局限性:还有哪些问题?
多语言和方言的支持不均
LTX-2 用的是 Gemma3-12B,支持多种语言,但训练数据中不同语言的比例不同。
英语和主流欧洲语言(如法语、德语)的数据多,质量高,所以生成的语音准确流畅。
但对于小语种或方言(如粤语、阿拉伯语),训练数据少,生成的语音可能发音不准,或者音视频对齐不好。
这是所有大模型的通病,训练数据的偏差会直接反映在生成结果中。
多说话人场景的角色混淆
当画面中有多个人说话时,LTX-2 有时会搞混”谁在说什么”。
比如,两个人在对话,本来应该是 A 说”你好”,B 说”你好吗”,但 LTX-2 可能生成的是 A 说了两句,或者 B 的话配到了 A 的嘴唇动作上。
为什么会这样?
因为多说话人场景需要更强的”角色绑定”能力,AI 不仅要知道”有人在说话”,还要知道”是谁在说话”。
这需要模型能够追踪每个角色的视觉特征(如脸部、服装)和声音特征(如音色、音调),并建立稳定的映射。
LTX-2 在这方面还有提升空间。
超过 20 秒的时间一致性
虽然 LTX-2 可以生成 20 秒的视频,但如果再长一点(比如 30 秒、1 分钟),会出现时间漂移(Temporal Drift),也就是场景逐渐变得混乱,音视频同步逐渐失调,或者画面主题逐渐偏离。
因为扩散模型是”一次性生成”的,不像自回归模型可以逐步累积上下文。
当时间跨度太长,模型很难保持全局一致性。
这就像你写一篇很长的文章,写到后面可能忘了开头讲的是什么,逻辑出现断裂。
解决方法可能是引入”记忆机制”,让模型在生成过程中记住之前生成的关键信息(如角色、场景、情节),或者用”分段生成+拼接”的策略,先生成 10 秒,再基于前 10 秒生成后 10 秒。
缺乏推理和世界建模能力
LTX-2 是一个生成模型,不是推理模型。
它可以根据文本描述生成对应的音视频,但它不”理解”物理规律、因果关系、常识。
比如,如果你输入”一个人从 10 层楼跳下,安全落地”,LTX-2 可能真的会生成这样的视频,因为它不知道”10 层楼很高,跳下去会受伤”。
它只是学习了训练数据中的统计规律,没有”世界模型”。
要让 AI 生成的内容更合理、更符合常识,可能需要结合大语言模型(LLM)做”前处理”,比如先用 LLM 把不合理的描述修正成合理的描述,再交给 LTX-2 生成。
社会影响:创作工具还是虚假信息武器?
创作民主化:人人都是导演
过去,拍一部有声视频需要摄像机、麦克风、录音棚、后期团队,成本高昂,门槛很高。
现在,你只需要一段文字描述,几秒钟就能生成一段高质量的音视频。
这对创作者来说是福音。
- 教育领域,老师可以快速生成教学视频,用不同语言和方言,让更多学生受益。
- 无障碍领域,视障人士可以通过音频描述”看到”视频内容,听障人士可以通过视频”听到”声音。
- 内容创作领域,UP 主、博主可以快速制作视频,不需要拍摄和录音,只需要好的创意和文案。
技术降低了创作的门槛,让更多人有机会表达自己。
虚假信息:Deepfake 的新战场
但同样的技术,也可以用来制造虚假信息。
如果有人用 LTX-2 生成了一段”某政治人物说了某些话”的视频,配上逼真的声音和嘴唇动作,发布到社交媒体上。
普通人很难分辨这是真的还是假的。
Deepfake,一种用 AI 生成的伪造视频或音频,通常用来冒充某个真实人物。技术越好,伪造越逼真,越难识破。
这不是杞人忧天,已经有很多 Deepfake 事件发生:
- 2019 年,有人用 Deepfake 生成了某 CEO 的声音,打电话给公司员工,骗走了几百万美元。
- 2020 年,有人用 Deepfake 生成了某政治人物的视频,在选举期间传播虚假言论。
LTX-2 的音视频联合生成能力更强,也意味着滥用风险更大。
如何负责任地使用?
Lightricks 在论文中强调,LTX-2 是为研究和创作目的设计的,使用者应该:
- 明确标注合成内容,让观众知道这是 AI 生成的,不是真实拍摄的。
- 遵守内容安全准则,不生成暴力、色情、仇恨、虚假信息等有害内容。
- 尊重隐私和版权,不未经许可冒充他人声音或形象。
但技术本身是中性的,关键在于如何使用。
我们需要更好的检测技术(如水印、指纹识别),更严格的法律规范(如要求标注合成内容),更强的公众意识(如媒体素养教育)。
技术的进步总是快于社会的适应,这是一场持久战。
开源的意义:为什么要公开代码和权重?
LTX-2 的所有代码和模型权重都是开源的,任何人都可以下载、使用、修改。
在很多公司把先进模型作为”核心竞争力”保密的时代,Lightricks 为什么选择开源?
加速研究:站在巨人的肩膀上
开源让全世界的研究者可以直接在 LTX-2 的基础上做改进,而不需要从头训练。
训练一个 190 亿参数的音视频联合模型,需要数千块 GPU,运行几周到几个月,成本数百万美元。
如果每个研究者都要自己训练,浪费太大,也太慢。
开源让研究更高效,让创新更快。
比如,有人可以基于 LTX-2 开发更好的多说话人角色绑定算法,有人可以优化 Thinking Tokens 的设计,有人可以尝试更长时长的生成策略。
这些改进又会反过来推动整个领域的进步。
透明性:让社会了解技术的能力和风险
闭源模型是一个”黑盒”,外界不知道它是怎么训练的,用了什么数据,有什么偏见和风险。
开源模型是透明的,研究者、监管者、公众都可以检查它的训练数据、模型架构、生成逻辑。
透明性有助于建立信任,也有助于及早发现和修正问题。
比如,如果发现 LTX-2 在某些语言上表现很差,社区可以贡献更多这些语言的训练数据,或者调整训练策略。
如果发现 LTX-2 容易被滥用(如生成虚假政治视频),可以开发检测工具或水印技术。
商业生态:不只是”免费的模型”
Lightricks 是一家商业公司,开源 LTX-2 不是纯粹的慈善行为。
开源可以带来:
- 品牌效应,展示技术实力,吸引人才和合作伙伴。
- 生态建设,让开发者在 LTX-2 基础上开发应用,扩大影响力。
- 社区反馈,收集用户的改进建议和 bug 报告,让模型更完善。
同时,Lightricks 还可以提供商业服务(如云端 API、定制化训练),赚取收入。
开源和商业不是对立的,而是可以共赢的。
未来:音视频生成的下一步是什么?
更长的时长:从片段到影片
现在的模型只能生成几秒到几十秒的片段,还不能生成完整的影片。
未来可能需要层次化生成,先生成”大纲”(场景列表、角色关系、情节发展),再逐场景生成细节。
或者引入自回归生成,像语言模型生成文本一样,一帧接一帧生成视频,保持长期一致性。
更强的控制:从描述到导演
现在的模型是”根据描述生成”,用户只能写一段话,不能精确控制生成结果。
未来可能支持多模态条件生成,比如:
- 输入一张参考图(角色长什么样)+ 一段音频(说什么话)+ 一段文字(做什么动作),生成精确匹配的视频。
- 支持”关键帧编辑”,用户指定几个关键帧的内容,AI 自动插值生成中间帧。
让用户从”观众”变成”导演”。
交互式生成:从单次生成到对话式创作
现在的模型是”一次性生成”,生成后不满意只能重新生成。
未来可能支持交互式生成,用户可以:
- “把这个人的声音调得更温柔一点”
- “让背景音乐更激烈一点”
- “把这个场景的镜头推近一点”
AI 成为你的创作助手,而不是自动机。
多模态理解:从生成到推理
现在的模型只会”生成”,不会”理解”。
未来可能结合大语言模型(LLM)和世界模型,让 AI 不仅能生成音视频,还能理解音视频的内容,推理因果关系,回答问题。
比如:
- “这个视频中的人为什么笑了?”
- “如果把这个场景的天气从晴天改成雨天,声音应该怎么变化?”
生成和理解的融合,才是真正的通用智能。

结语:从”看”到”听”,AI 的多感官时代
LTX-2 不是第一个音视频生成模型,也不会是最后一个。
但它的意义在于,它证明了”联合生成”是可行的,也是更好的。
声音和画面不是独立的,而是同一个物理世界的不同感官呈现。
一辆车驶过,你看到它的运动轨迹,也听到它的引擎声和风声,这两者是同一个事件的不同侧面。
AI 要真正理解世界,不能只”看”,也不能只”听”,而是要把多种感官整合起来。
LTX-2 迈出了这一步,从单模态(视频或音频)走向了双模态(视频+音频)。
未来,可能还会有更多模态的整合:
- 视觉 + 听觉 + 触觉(虚拟现实)
- 视觉 + 听觉 + 嗅觉(沉浸式体验)
- 甚至是”第六感”(情感、直觉)
AI 的下一个战场,不是单一模态的精进,而是多模态的融合。
LTX-2 告诉我们,这个未来不是遥不可及的梦想,而是已经到来的现实。
作为用户,我们可以期待更好的创作工具。
作为研究者,我们可以探索更深的技术边界。
作为社会,我们需要思考如何负责任地使用这些技术。
技术本身没有善恶,但使用技术的人有选择。
LTX-2 开源了,选择权在我们手中。
原文信息
- 作者:向阳乔木(@vista8)
- 原文发布日期:2026-01-08 原文地址:
看完了,收获满满,期待更多更新。
作者写得真不错,学到了不少。
讲解得很细致,新手也能看懂。
讲解得很细致,新手也能看懂。
讲解得很细致,新手也能看懂。
很有价值的分享,感谢整理。
赞同,实践出真知。
这个比较实用,已转发给同事。
收藏了,以后慢慢研究。