为什么最聪明的AI,连3岁小孩都打不过?
你家里有小孩吗?
如果有,试着观察一下,一个3岁的孩子,在没学会说话之前,就已经会做很多事情了。
他知道球滚到沙发底下还在那里,只是看不见而已。
他能追踪一只猫从树后走出来,尽管只看到尾巴。
他看到杯子放在桌边一半悬空,会伸手去扶。
他甚至能分辨出两只长得很像的老虎图案,其中一只耳朵少了一道纹路。
这些能力,叫做”前语言视觉推理”。
前语言视觉推理(Pre-linguistic Visual Reasoning):人类在学会语言之前就掌握的视觉理解能力,包括物体追踪、空间感知、模式识别等基础视觉能力。就像婴儿不会说”球还在那里”,但知道球没有消失。
而现在最先进的AI模型,在这些测试上,成绩还不如一个6岁小孩。
并非夸张,是一篇最新论文《BabyVision》的实验结果。
论文用婴儿认知测试去测AI,发现了一个事实:
Gemini 3 Pro得了49.7分,6岁孩子轻松碾压,成年人平均94.1分。
这意味着什么?
意味着我们现在的AI,虽然能通过律师考试、写出漂亮的代码、生成逼真的图片,但在最基础的视觉理解上,还不如一个刚学会走路的小孩。
AI的”倒挂”能力

正常人的认知发展是这样的:
先有视觉理解 → 后有语言 → 最后有抽象推理
婴儿在8个月时就理解了”物体永存”,在18个月时能追踪复杂的运动轨迹,在3岁时能完成空间变换任务。
这些能力,都是在他们会说话之前就掌握的。
物体永存(Object Permanence):理解物体被遮挡后仍然存在的能力。比如球滚到沙发下,婴儿知道去找,而不是认为球消失了。发展心理学家Jean Piaget认为这是8-12个月婴儿的里程碑能力。
但AI反过来了:
先学会语言 → 然后学知识 → 但视觉理解很弱
它可以告诉你”物体永存”的定义,引用Piaget的理论,解释背后的认知机制。
但你给它看一张图,一个球滚到沙发下,让它追踪球的位置,它可能会迷失。
就像一个从来没见过真实世界,只看过小说和教科书的人,被突然扔到真实环境里。他能说得头头是道,但一做就

图1:不同年龄段人类和AI模型在BabyVision测试上的表现。连6岁儿童都远远领先于顶尖AI模型。
BabyVision到底在测什
论文设计了一个基准测试,叫BabyVision,包含388个问题,分成4大类22个小类。
基准测试(Benchmark):用来评估AI性能的标准化测试集。就像高考是评估学生水平的基准,BabyVision是评估AI视觉理解的基准。
- 精细视觉辨别(Fine-grained Discrimination)
测什么:能不能分辨出细微的视觉差异?
例子:
- 找出49只老虎图案中,哪只和其他不一样(可能只是耳朵少了一道纹)
- 从6个影子里找出和企鹅完全匹配的那个
- 数一数图里有多少个相同的图案
精细辨别(Fine-grained Discrimination):区分高度相似物体的能力。比如识别双胞胎的差异,或者在一堆相似图案里找出细微不同。
人类表现:成年人92.3%正确率 AI表现:Gemini 3 Pro仅46.2%
- 视觉追踪(Visual Tracking)
测什么:能不能追踪运动中的物体或路径?
例子:
- 走迷宫,从入口找到出口
- 追踪一条线穿过复杂的交叉路径
- 看地铁线路图,找出两站之间的路线
视觉追踪(Visual Tracking):持续关注移动物体或复杂路径的能力。就像你的眼睛能追着飞过去的鸟,或者手指能沿着地图上的线路走。
人类表现:成年人94.6%正确率 AI表现:Gemini 3 Pro仅43.4%
这一类是AI失败最严重的,为什么?
因为AI容易在交叉点”丢失”物体的身份。
就像你追踪一条红线穿过一堆交叉的线,AI到交叉点就混乱了,不知道哪条是原来那条。
- 空间感知(Spatial Perception)
测什么:能不能理解3D空间和物体的空间关系?
例子:
- 纸张折叠后会变成什么形状?
- 一个立方体从不同角度看是什么样?
- 数一数这个3D结构里有多少个小方块?
空间感知(Spatial Perception):理解三维空间中物体位置、形状、方向的能力。比如你能想象一张纸对折三次后展开是什么样,这就是空间想象。
人类表现:成年人94.7%正确率 AI表现:Gemini 3 Pro仅53.7%
这一类AI也很挣扎。
它缺乏”心理旋转”的能力,无法在脑海里把一个物体转个方向看看。
心理旋转(Mental Rotation):在脑海中旋转物体的能力。比如你看到一个俄罗斯方块,能想象它旋转90度后是什么样。人类3-4岁就有这个能力,AI很难掌握。
- 视觉模式识别(Visual Pattern Recognition)
测什么:能不能识别视觉规律和完成模式?
例子:
- 找出图案的旋转规律
- 完成缺失的2D或3D图案
- 识别镜像或叠加后的图案
模式识别(Pattern Recognition):发现视觉规律并预测下一个的能力。比如看到”○△□○△?“,你知道下一个是□。这是人类最基础的认知能力之一。
人类表现:成年人97.8%正确率 AI表现:Gemini 3 Pro仅53.

图5:BabyVision的22个子任务类型示例,涵盖从精细辨别到空间推理的各个方面。
为什么AI在这些测试上崩
核心原因:当前的多模态模型本质上是”语言模型加了视觉插件”。
它不是真正在”看”,而是在”猜”。
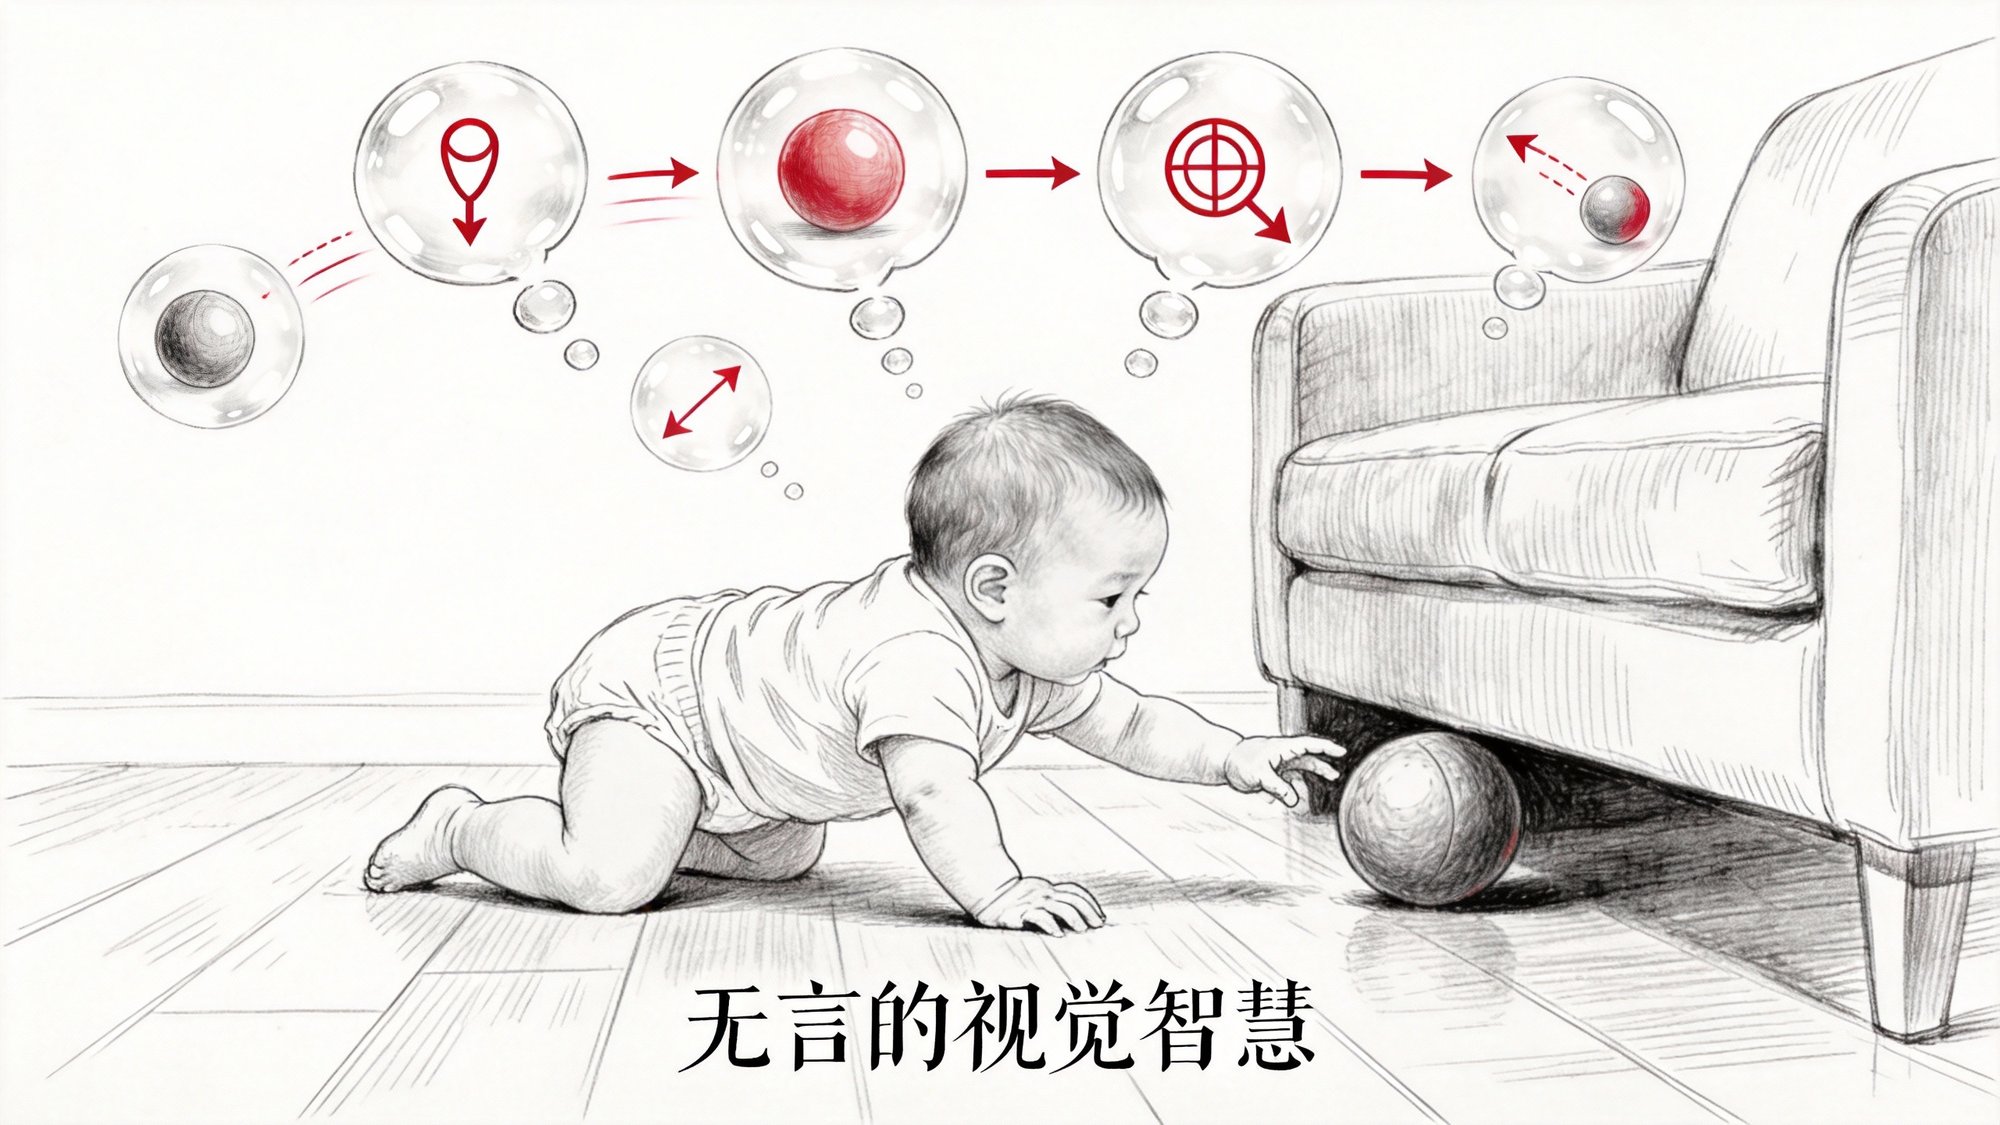
对比:人类 vs AI的思维路径
场景:一个红球滚到沙发下面
3岁儿童的思维:
- 看到球滚动(视觉运动追踪)
- 球消失在沙发下(空间推理)
- 球还在那里,只是看不见(物体永存)
AI的思维:
- 识别图像:“一个红色的球”
- 检测到运动方向:“向沙发移动”
- 调用语言知识:“球通常会滚到物体下面”
- 生成答案:“球可能在沙发下”
看出区别了吗?
儿童是在”看”,建立了空间和运动的直接理解。
AI是在”推理”,通过语言知识来猜测。
就像一个只会背公式但从没见过实验的学生,遇到真实物理场景就懵了。
AI可以告诉你牛顿第二定律F=ma,但看到一个球从斜坡滚下来,它可能算不出球会滚到哪里。
实验数据:残酷的对比

论文测试了11个顶尖模型,包括Gemini 3 Pro、GPT-5.2、Claude 4.5、Qwen3-VL等。
总体成绩对比

最大的发现:即使是表现最好的Gemini 3 Pro,也落后成年人44.4个百分点,落后6岁儿童约20个百分点。
更多细节
看看具体任务的表现(Table 1数据):
走迷宫(Maze):
- 人类:95.0% ✅
- Gemini 3 Pro:30.0%
- 差距:65个百分点
3D立方体展开(3D Cube Unfold):
- 人类:77.8% ✅
- Gemini 3 Pro:41.7%
- 所有AI模型的最高分也只有41.7%
追踪线条(Lines Observation):
- 人类:100% ✅
- Gemini 3 Pro:83.3%
- 这已经是AI表现相对最好的任务了
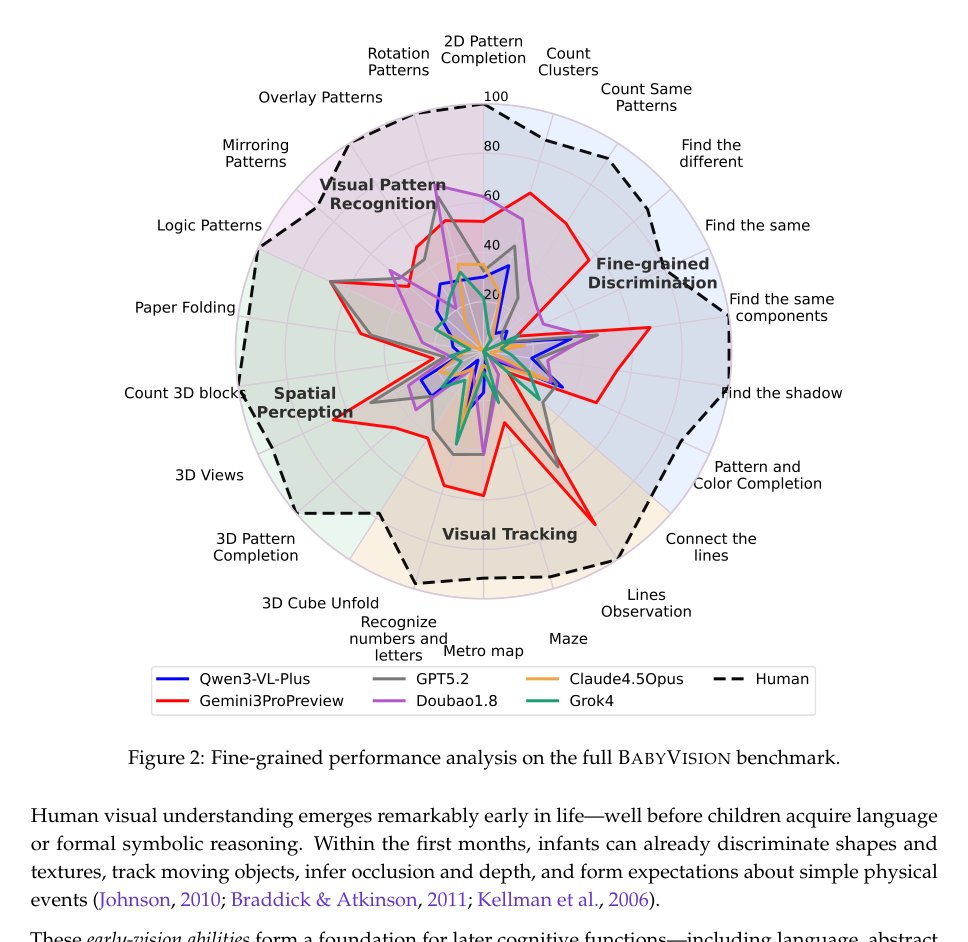
图2:各个AI模型在BabyVision四大类任务上的细粒度表现分析。红色表示表现最差的区域。
Beyond Language:超
论文标题里的”Beyond Language”(超越语言)特别关键。
人类的认知发展有个顺序:先有视觉理解,后有语言。
前语言认知(Pre-linguistic Cognition):在语言出现之前就形成的认知能力。婴儿在会说话之前,已经理解了物体的连续性、因果关系、空间关系、物理规律等基本概念。
婴儿在会说话之前,已经理解了:
- 物体的连续性(物体不会凭空消失)
- 因果关系(推倒积木,积木会倒)
- 空间关系(上下、里外、前后)
- 物理规律(重的东西会往下掉)
这些是人类理解世界的地基,是”视觉直觉”。
但AI反过来了:它先学会了语言,再试图理解视觉。
这就像一个人从来没见过真实世界,只看过小说和教科书,然后突然被扔到真实环境里。他能说得头头是道,但一做就错。
BabyVision-Gen:用画图代替语言

论文还提出了一个有趣的扩展:BabyVision-Gen。
生成式评估(Generative Evaluation):通过让模型生成图像来评估其视觉推理能力,而不是输出文字答案。就像让学生画图解题,而不是写文字说明。
为什么要这样做?
因为人类解决视觉问题时,常常是用”画”而不是”说”。
比如走迷宫,你会用手指或笔沿着路径走,而不是说”先向左,然后直走,再向右”。
找不同的时候,你会直接圈出不同的地方,而不是描述”第4行第7列的老虎耳朵少了一条纹”。
外化推理(Externalized Reasoning):通过外部动作(如画图、比划)来进行思考的过程。儿童发展研究表明,孩子会先”画出来”再”说出来”。
BabyVision-Gen让AI模型生成图像来回答问题:
- 走迷宫 → 画出路径
- 找不同 → 圈出不同的地方
- 完成图案 → 画出缺失部分
结果很有趣:一些生成模型(如Nano-Banana-Pro)在某些任务上比纯语言模型表现更好,尤其是视觉追踪和精细辨别。
但整体来说,生成模型的可靠性和一致性还是不够。
有时候能画对,有时画错。

图3:BabyVision(语言输出)和BabyVision-Gen(图像生成)的示例对比。*
这个发现为什么重要?

这不只是一个”AI还不够好”的故事。
这揭示了一个更深的问题:当前AI的”智能”可能是建立在沙滩上的。
想象几个场景
场景1:自动驾驶
AI可以识别”球”和”小孩”的标签,但如果它不能真正理解”一个球滚到车底下意味着可能有小孩在追球”,光靠识别是不够的。
它需要的不是”这是球”的语义识别,而是”球在运动,可能有人在追”的空间和因果推理。
因果推理(Causal Reasoning):理解事件之间因果关系的能力。比如看到球滚动,推断可能有人踢了它;看到烟,推断可能有火。这是婴儿期就开始发展的能力。
场景2:机器人
你让机器人”把杯子放在桌子上”,它可能会放在边缘一半悬空,然后困惑为什么杯子掉了。
因为它没有关于”重力”、“支撑”、“平衡”的视觉物理直觉,只有语言层面的知识。
视觉物理直觉(Visual Physics Intuition):通过视觉直接理解物理规律的能力。比如看到悬空的杯子,不用计算就知道会掉。这是人类视觉系统内置的”物理引擎”。
场景3:通用AI
如果AI缺乏人类婴儿级别的视觉常识,怎么可能达到人类级别的通用智能?
真正的智能不是从语言开始的,而是从理解这个物理世界的基本规律开始的。
AI可以背诵万物的名字,但如果它不理解万物如何运动、如何相互作用、如何在空间中存在,它就只是一个很会说话的鹦鹉。
出路在哪

论文没有给出明确的解决方案,但提供了一个方向:
AI需要像婴儿一样学习,而不是像博士生一样学习。
婴儿的学习方式
- 大量交互(摸、碰、推、看)
- 实时反馈(杯子掉了,球滚了)
- 建立因果模型(这样做会导致那样)
具身认知(Embodied Cognition):认知不仅发生在大脑里,也发生在与环境的互动中。婴儿通过摸、爬、碰来理解世界,而不是通过读书。
当前AI的学习方式
- 海量数据(互联网文本+图片)
- 统计关联(“球”和”圆形”经常一起出现)
- 模式匹配(见过类似场景就能答对)
差异在哪里?
婴儿的学习是主动的、具身的、因果的。
它通过自己的行动来探索世界,建立起世界如何运作的模型。
AI的学习是被动的、符号的、统计的。
它只能看到人类已经标注好的数据,学习的是”什么和什么经常一起出现”,而不是”为什么它们会一起出现”。
也许AI需要一个”虚拟婴儿期”:
在模拟环境里摸爬滚打,推倒积木看它怎么倒,扔球看它怎么滚,放杯子看它会不会掉。
先建立对物理世界的直觉,然后再去学语言和知识。
方法论启发:评估的盲区

这篇论文给AI评估带来了一个重要启示:
我们一直在用错误的标准评估AI。
现有的基准测试大多是:
- 知识密集型(需要专业知识)
- 专家级别(大学考题、专业资格)
- 语言驱动(通过文字理解和推理)
比如:
- MMMU:大学多学科问答(Gemini 3 Pro得分92.8%)
- MathVista:数学和几何推理
- HLE:“人类最后的考试”,专家级难题
AI在这些测试上表现很好,给我们一种”AI很智能”的错觉。
但BabyVision告诉我们:AI可能只是记住了很多答案,而不是真正理解了视觉世界。
语言泄露(Language Leakage):模型通过文字线索而非真正的视觉理解来答题的现象。研究发现,某些模型即使不看图片,仅凭问题文本就能答对42.9%的MMMU题目。
就像一个学生可以通过题海战术背下所有题型,在考试中拿高分,但遇到真实问题时一脸懵逼。
真正的智能评估,应该包含这些”愚蠢但基础”的测试:
- 能追踪一条线吗?
- 能分辨两个相似图案吗?
- 能想象一个物体旋转后的样子吗?
这些能力,人类3岁就有了。AI还在努力。
最后的思考
这篇论文让我想到一个问题:智能的本质是什么?
如果一个系统能通过律师考试、写出漂亮的代码、生成逼真的图片,但连6岁孩子都知道的”球滚到沙发下面还在那里”都理解不了,它真的智能吗?
也许,真正的智能不在于知道多少,而在于理解多深。
AI现在知道很多。
它知道所有诺贝尔奖得主的名字,知道量子力学的公式,知道世界上所有的历史事件。
但它不理解最基本的东西:
一个球,为什么会滚。 一个杯子,为什么会掉。 一条线,为什么在交叉点还是那条线。
这些知识,不在任何教科书里。
它们是通过看、摸、尝试学会的。
也许我们一直在追求的AGI,不是一个博学的图书管理员,而是一个会爬会走会探索的婴儿。
当AI学会像婴儿一样”看”世界的那天,才是它真正变聪明的开始。
论文信息
- 标题:BabyVision: Visual Reasoning Beyond Language
- 作者:Liang Chen, Weichu Xie等29位作者(来自UniPat AI、Moonshot AI、清华、北大等)
- 发表时间:2026年1月13日
- 论文链接:
https://arxiv.org/abs/2601.06521 - 项目主页:
https://unipat.ai/blog/BabyVision - 代码开源:已发布在GitHub
原文信息
作者:向阳乔木(@vista8),AI 博主
原文地址:
楼主辛苦了,内容很有参考价值。
实测过类似工具,作者说的基本属实。
作者写得真不错,学到了不少。
收藏了,以后慢慢研究。
这篇文章分析得很透彻,收藏了!
楼主辛苦了,内容很有参考价值。
点赞,必须点赞
这篇文章分析得很透彻,收藏了!
这个观点很中肯,深有同感。
点赞,必须点赞