DeepSeek V4 Pro 对比 GPT-5.6 Sol:35 倍价差下,先跑便宜模型的级联方案多 10 分还省 60%
一句话结论
904 次 DeepSeek rollout 跑完,赢家不是任何一个模型单独:DeepSeek V4 Pro 0813 先行、失败时升级 GPT-5.6 Sol 的级联方案,83.0% 通过率、每任务 $3.35。
别二选一。先跑 DeepSeek V4 Pro 0813,测试失败时升级到 GPT-5.6 Sol。这个级联解决 83.0% 的 DeepSWE 任务,每个 $3.35。Sol 单独解决 72.7%,每个 $8.37——高 10 个百分点的同时便宜 60%。
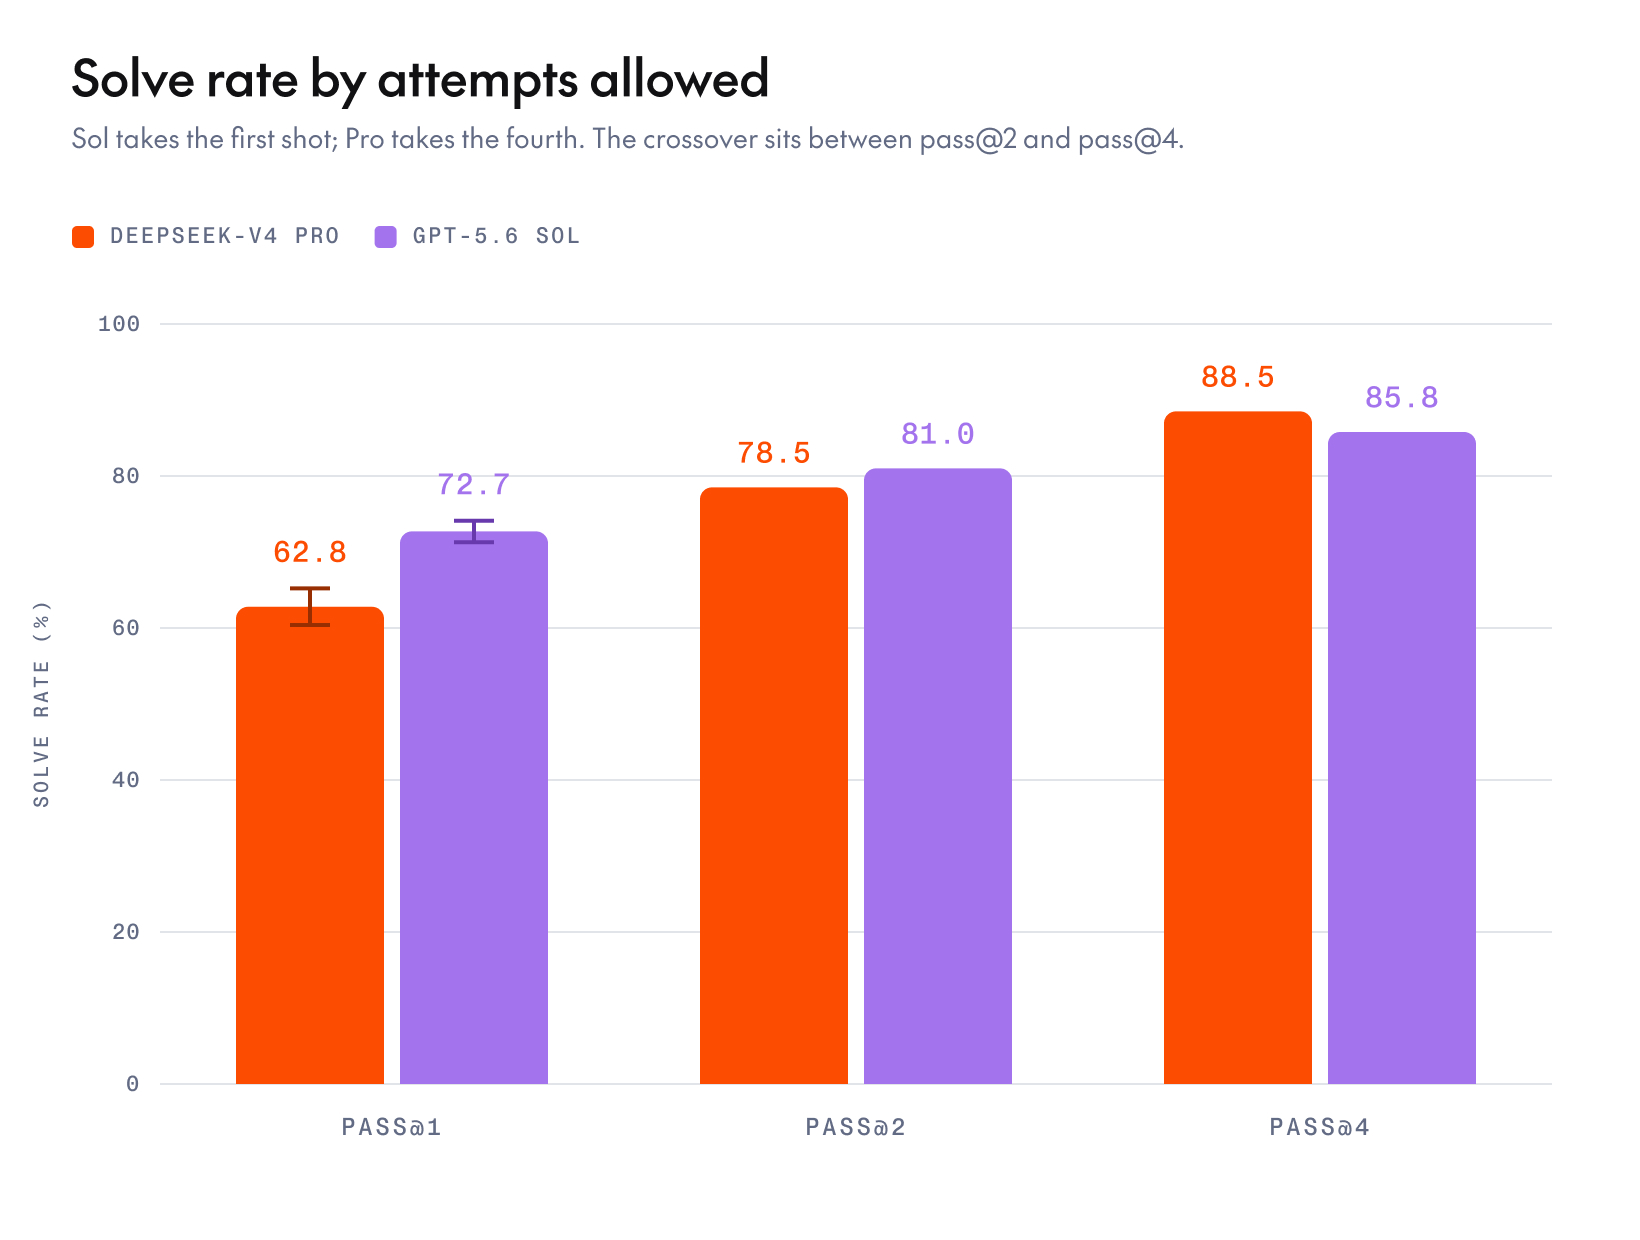
- Sol 赢早期尝试。pass@1 72.7% 对 62.8%,并在 pass@2 保持领先(81.0% 对 78.5%)。
- Pro 赢最后一次。pass@4 88.5% 对 85.8%。给四次机会,便宜模型找到棋盘上更多的任务。
- 价格差距 35 倍。每次 rollout $0.24 对 $8.37。每 $100 花费,Pro 解决 261 个任务,Sol 解决 9 个。
- Sol 更快更稳。每次 rollout 17 分钟 53 步对 Pro 的 35 分钟 146 步,4/4 全过的任务 61 个对 35 个。
- Sol 的失败更脏。20% 的失败会破坏已经通过的测试,Pro 只有 11%。给 Sol 的输出加回归门。
实验设置
这是 Together 在 DeepSWE 上做的 DeepSeek V4 Pro 0813 与 GPT-5.6 Sol 对比。DeepSWE 是跨任务类型、跨编程语言测试软件工程能力的基准。GPT-5.6 Sol 是榜上最好的单发工程师,而 DeepSeek V4 Pro 0813 的成本只有它的三十五分之一。有意思的问题不是哪个首发更准(Sol,显然),而是 35 倍价格差距到底买到了什么,以及低成本模型的上限能否弥补差距。

| 模型 | pass@1 | 平均成本 | 每 $100 解决 | 输出 token | 步数 |
|---|---|---|---|---|---|
| gpt-5.6-sol (max) | 72.7% ± 2.2% | $8.37 | 9 | 59k | 53 |
| deepseek-v4-pro-0813 (max) | 62.8% ± 3.1% | $0.24 | 260 | 101k | 146 |
在全部 113 个 DeepSWE 任务上各跑 4 次试验(均开最大努力档),基于公开逐试验记录共 904 次 rollout(每方 452 次)。Sol 是精准旗舰,Pro 是价值异类。以下所有数字都来自这一轮实测。
计分板:pass@1 与 pass@k
单发 Sol 明显领先:官方计分 pass@1 72.7% 对 Pro 的 62.8%。但差距随每次重试收窄然后反转:两次尝试时 Pro 已接近(78.5 对 81.0),四次时 Pro 的 88.5% pass@4 超过 Sol 的 85.8%。低成本模型有更宽的触达;它需要不止一次尝试,而它的尝试几乎免费。如果你的工作负载允许 best-of-k,Sol 的准确率论点基本消失。
成本对比
每次 rollout $0.24,DeepSeek V4 Pro 0813 比 Sol($8.37)便宜 35 倍,按价值算是每 $100 解决 260 个任务对 9 个。低价买不到的是速度和简洁:Pro 中位数 146 步 35 分钟、输出 101k token,对 Sol 紧凑的 53 步、17 分钟、59k token。Sol 是快而简洁的专家;Pro 用更长的路走完相似的覆盖。如果有人在等结果,Sol 光凭延迟就值回溢价;如果等的是预算或队列,没有什么接近 Pro。

覆盖率与可靠性:精准对触达
把 pass@1 分解为覆盖率和可靠性,切分很干净。Sol 是精准角落:84.5% 可靠性和 61 个 4/4 全过任务,是碰到就拿下的模型标记。DeepSeek V4 Pro 0813 换到另一根轴:更宽的覆盖率(88.5% 对 85.8%)但可靠性低得多(71.0%)、稳任务更少(35 对 61)。这就是从侧面看的 pass@4 交叉:Pro 触达基准上比 Sol 更多的地方,但每次触达的转化率更低。
失败模式
失败画像差异鲜明。Sol 在 20% 的失败中破坏仓库现有测试套件——GPT 家族的回归签名。DeepSeek V4 Pro 0813 保守得多,只有 11%;它失败时通常是近失误且基线完好。所以更便宜的模型反而是更适合不经审查直接接受的:给 Sol 的 diff 套上完整回归门,Pro 不那么需要这个护栏。

按任务类型
Sol 的质量优势很宽:赢 8 个领域中的 6 个,以数据建模与序列化 92%(超 Pro 28 分)领衔,加上查询与配置(80)、并发(72)、构建运维(73)、程序分析(64)、协议一致性(59)。它没拿下的两个很窄:语言与运行时内部是 75-75 平局,DeepSeek V4 Pro 0813 在有状态响应式上险胜(66 对 64),这是它唯一的领域胜利。凡是要求精确命中序列化契约的任务,Sol 一骑绝尘。

按编程语言
Sol 横扫五分之四(Python 74、Go 79、TypeScript 66、JavaScript 75),Python 和 Go 的差距很大。例外是 Rust,DeepSeek V4 Pro 0813 以 65 对 60 险胜:这是 Sol 跑输同级模型的唯一语言,也是 Pro 唯一 outright 获胜的语言。如果你的技术栈是 Python 或 Go,这是 Sol 的舒适主场;如果是 Rust,Pro 略好且便宜得多。

两模型差异度
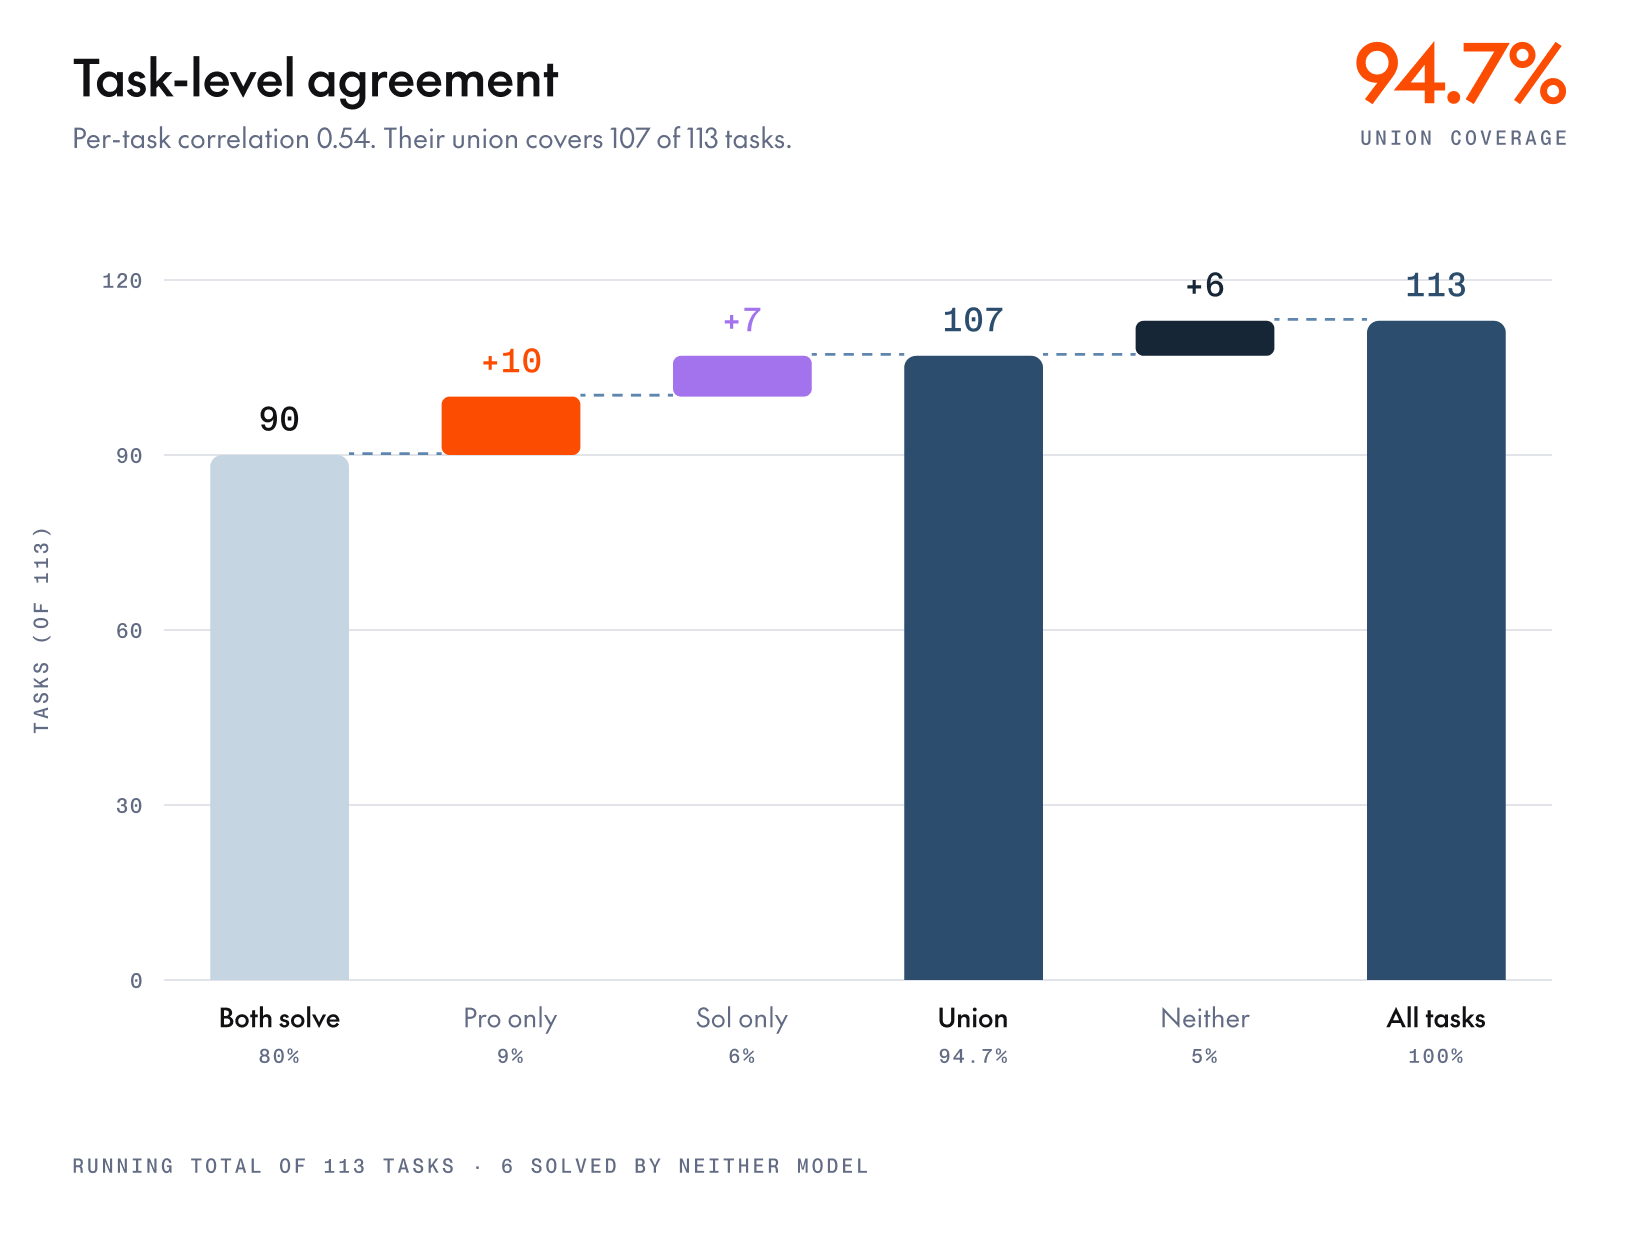
中等。逐任务相关度 0.54,是 DeepSeek-Pro 配对中最接近的。两者都解出 90 个任务;Pro 独得 10 个,Sol 独得 7 个,6 个战胜两者。并集覆盖 113 中的 107(94.7%)。对组合而言有一个不对称性很重要:DeepSeek V4 Pro 0813 没有横扫任何 Sol 完全错过的任务,而 Sol 在两个 Pro 从未解出的任务上四比零全胜。所以 Pro 在 Sol 之上没有增加多少新触达;它增加的是以最低成本清空共同任务的能力。
级联路由:组合玩法
这正是级联获胜的原因。先跑 DeepSeek V4 Pro 0813,只在测试套件拒绝答案时升级到 Sol:83.0% 解决率、每任务 $3.35。比 Sol 单独(72.7%)高 10 个百分点,价格不到 Sol 自身每任务价格($8.37)的一半。
近乎免费的第一段清空大部分队列,所以 Sol 的溢价只花在硬核残余上,且到达 Sol 的任务额外获得第二次独立尝试。级联甚至击败了完美的单发预言机路由(80.8%),因为两次独立尝试胜过一次完美选择。准确率与谁先跑无关,但成本不是——Pro 先行便宜得多($3.35 对 $8.44),所以永远让低成本模型打头。

完整数据表
| 指标 | deepseek-v4-pro-0813 (max) | gpt-5.6-sol (max) |
|---|---|---|
| pass@1(官方计分) | 62.8% | 72.7% |
| pass@1(错误计为失败) | 62.8% | 72.3% |
| pass@2 / pass@4 | 78.5 / 88.5% | 81.0 / 85.8% |
| 覆盖率 / 可靠性 | 88.5 / 71.0% | 85.8 / 84.5% |
| 稳(4/4)/ 墙(0/4) | 35 / 13 | 61 / 16 |
| 每次 rollout 成本 / 总成本 | $109 | $8.37 / $3,783 |
| 每 $100 解决任务数 | 261 | 9 |
| 中位分钟 / 步数 | 35 / 146 | 17 / 53 |
| 中位峰值上下文 / 输出 token | 232k / 101k | 177k / 59k |
| 失败解剖(近失误/回归) | 66% / 11% | 54% / 20% |
| 赢得领域数(共 8) | 1(有状态) | 6(1 平) |
| 赢得语言数 | 1(Rust) | 4 |
| 基础设施错误 | 0 | 2 |
| 逐任务相关度 / 并集 | 0.54 / 107 of 113(94.7%) | |
| 单发预言机路由 | 80.8% | |
| 级联 Pro→Sol(准确率/成本) | 83.0% / $3.35(对比 Sol 单独 72.7% / $8.37) |
部署建议
- 首发正确性与延迟都要时选 Sol:最高 pass@1、最高可靠性、最快最简洁、八分之六领域——但要为它的 20% 回归率套上完整回归门。
- 高吞吐、重试容忍的智能体负载选 Pro:接近旗舰的覆盖、更高的四发上限、更干净的失败画像,$0.24 一次。
- 最锐利的用法是两个都上:Pro 当 Sol 的前置。低成本首段清掉大部分工作,把 Sol 变成只按需支付的成本,用不到 Sol 一半的价格买到超过旗舰的覆盖。
原文信息
- 作者:Together AI
- 发布时间:2026-08-18 原文地址:
有没有更详细的教程,期待后续。
整理得太全面了,省了我不少时间。
作者写得真不错,学到了不少。