生产环境 A/B 测试大模型:在端点上分流真实流量,95/5 起步一次调用完成扩量
一句话结论
A/B 实验允许你把端点的线上流量切分成固定群组:一个对照组加最多 20 个变体,每个有百分比流量份额。这让你能在自选曝光水平下测量候选模型在真实用户手中的表现。扩量变体只需一次调用,赢家可以用蓝绿发布直接晋级;删除实验后 100% 流量自动回到对照组,无需改任何客户端或路由逻辑。下面在一个线上端点上跑完整实验:95%/5% 创建、扩到 80%/20% 和 50%/50%、然后删除,并在每个阶段核对观测流量份额。
为什么需要 A/B 而不是影子流量
迟早每个团队都会想回答同一个问题:新模型对我们的用户真的更好吗?——不是基准上更好,而是留存率、点赞率、任务完成率这些产品真正测量的指标上更好。
影子流量回答不了这个问题。影子模式告诉你候选模型在延迟、错误、吞吐上运行正常,但它的回复被丢弃,没有任何用户真正基于它行动。质量问题需要真实曝光:一部分用户拿到模型 B,然后比较发生了什么。
通常团队自己在应用层搭:客户端代码里做特征开关或用户 ID 哈希取模、两个端点(或两个硬编码模型名)之间切换、某个电子表格解释 A 组 B 组的含义。能用,但它把实验和基础设施纠缠在一起:路由逻辑跟着应用发布、群组切分会随客户端缓存决策漂移,而且实验”结束”后分支代码长期残留,因为没人确定删掉是否安全。
Together AI 平台允许在端点级别跑 A/B 实验逻辑。
工作机制
一个 A/B 实验挂在大模型推理端点上,声明成员:恰好一个对照组、一个或多个变体,每个指向一个模型部署,各有一个 percent 设置(合计必须为 100)控制流量路由。

端点路由器的机制:每当基础流量把请求发给对照组,实验就在各臂之间重新采样并重新分配——95% 留在对照组,5% 进变体。
精确地说:实验切分的是对照组在基础流量切分中的份额。路由先通过权重切分解析请求;当赢家是 A/B 实验的对照组时,请求按实验各臂的百分比重新采样。对照组是切分中唯一入口时,成员百分比就是绝对流量份额。还要注意:切分权重为零的对照组给实验留下零可切分流量,整个实验收不到流量。

重要规则:变体部署绝不能进端点的流量切分,平台要求变体权重为零,只有对照组存在于基础切分。实验完全接管路由到变体的流量,它的百分比就是它的流量份额。如果变体还能从切分按容量加权拉流量,你的测量就会被悄悄污染。可以这样理解:像配置影子部署一样配置变体——创建、READY、权重零,让实验的百分比设置去路由。
另一个要点:A/B 百分比是真正的固定流量份额,合计 100%,与副本数无关。这是刻意与流量切分权重(按就绪副本、跟容量走)不同的设计。实验是测量仪器,测量期间你要切分恒定,不随自动扩缩漂移。
创建 95/5 实验一条命令:
tg beta endpoints ab my-org/candidate-model --control $CONTROL_DEPLOYMENT --percent 5
你的客户端不会察觉这个实验,因为表面上相同的端点名、API 和密钥都保持不变。后台层面,5% 的请求从此由变体候选应答。
扩量、测量、收尾
扩量就是重发成员集。没有单独的”扩量”API,一次 update 会替换完整成员列表——心智模型简单(实验永远恰好是成员声明的样子),每次扩量都是显式可审查的变更:
# 第 2 周:候选在 5% 表现好 -> 提到 20%
client.beta.endpoints.ab_experiments.update(
    id=experiment_id,
    endpoint_id=endpoint_id,
    update_mask="members",
    etag=experiment.etag,   # 队友的并发扩量会被拒绝,不被覆盖
    members=[
        {"deployment_id": control_dep, "percent": 80, "role": "AB_EXPERIMENT_MEMBER_ROLE_CONTROL"},
        {"deployment_id": variant_dep, "percent": 20, "role": "AB_EXPERIMENT_MEMBER_ROLE_VARIANT"},
    ],
)
更新由 etag 保护:如果队友在你编辑期间扩了量,你的更新会被拒绝而不是静默覆盖他们的。

曝光量怎么选:
| 切分 | 信号速度 | 风险 | 适用场景 |
|---|---|---|---|
| 95/5 | 慢(需要量/时间) | 最小 | 新模型首次真实曝光 |
| 80/20 | 中等 | 可控 | 候选在 5% 活下来了,要更显著的读数 |
| 50/50 | 最快 | 一半用户 | 两个已知良好选项的晚期确认 |
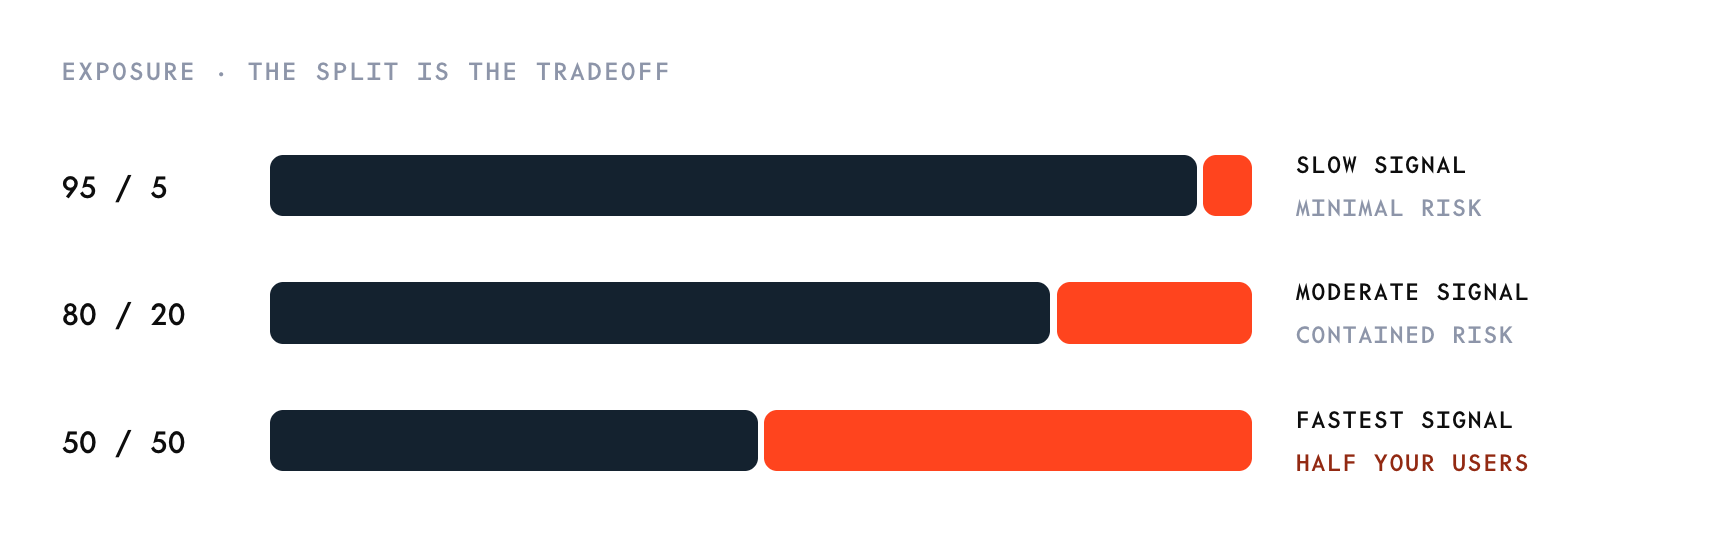
最多 20 个变体成员支持多路测试——比如同时试一个全精度端点和三个量化变体(V1、V2、V3),只要百分比合计 100 且恰好一个对照组即可。

测量:平台指标与产品指标做 join。每个请求由具体部署应答,每个平台指标(延迟、错误、每群组吞吐)都按部署可用——基础设施侧对比是一个过滤器而不是一个项目。产品侧是你的:记录哪个部署应答了每个响应(在响应元数据里),连同你的质量信号——评分、重试、任务完成——join 键就是部署 ID。平台刻意不去猜你的质量指标,它把归因变得不费力气,让你的分析去做评判。
边界情况
变体在实验中途劣化怎么办? 爆炸半径只有它的群组。部署独立监控、独立扩缩,挣扎的变体不会拖垮对照组。重发不含病变变体的成员集即可,用户会在一个传播周期内回到对照组。这也是为什么从 5% 起步是好主意。
观测份额与配置百分比一致吗? 有意义流量规模上是的。小窗口会有采样噪声:1000 个请求的 5% 是小样本。如果观测份额偏得很多且持续偏,检查上面的配置规则。
A/B 实验和发布能同时跑在同一端点吗? 能,组合顺序有定义:路由先解析基础切分,然后 A/B 实验(切分对照组份额),然后发布(在源部署与发布目标间重采样)。平台仍限制每端点一个活跃发布,但各阶段为重叠而设计。
群组按用户粘滞吗? 分配使用请求的采样键,比如请求体里的 prompt_cache_key 或 user 字段——相同键的请求一致路由,用户可以在整个会话留在同一臂。无键请求按请求随机分配。如果按用户一致性对你的研究重要(尤其多轮质量对比),发送稳定的 user 字段。
切分下自动扩缩如何表现? 每个成员部署按自己的策略、按自己的流量份额独立扩缩。5% 变体边界 1-2、95% 对照组边界 2-8 是完全正常的形态。各群组副本独立观察。
一次完整实验实录
对线上端点跑完整生命周期:95/5 创建、扩到 80/20、扩到 50/50、删除。全程保持 3 RPS 稳定流,每个请求都归因到应答的部署。

每个阶段的配置份额与观测份额:
| 配置(对照/变体) | 观测 | 请求数 |
|---|---|---|
| 95 / 5 | 95.3 / 4.7 | 1,330 |
| 80 / 20 | 79.2 / 20.8 | 1,348 |
| 50 / 50 | 50.2 / 49.8 | 1,348 |
| 删除后 | 100.0 / 0 | 360 |
三个细节值得划重点:
- 每次扩量真的只是一次调用,用当前 etag 重发完整成员集(对照组部署与变体部署各带百分比)。两次扩量中 etag 从 1 推进到 2 再到 3;过期 etag 会被拒绝而不是静默覆盖队友的变更。
- 传播快但非瞬时。 每次更新后等了约 75 秒再测量;路由层在与流量切分相同的 30-60 秒尺度上 pickup 实验变更。
- 删除: 移除实验后连发 360 个请求全部落在对照组,没有任何残留的群组逻辑需要收尾。
实验在控制台端点页的 Traffic tests 标签页显示(A/B 测试与影子测试共用此页)。

上手步骤
你需要一个有对照组部署在服务流量的端点,加一个候选部署(已创建、READY、不在流量切分中)。然后:
- 以 95/5 创建实验。
- 跑到量足够——5% 的全部意义就是低曝光收集数据。
- 数据说话时一次 update 扩量。决定性时用发布晋级。跑完删除——没有其它要清理的。
文档:Dedicated Model Inference → A/B tests(docs.together.ai)。
原文信息
- 作者:Together AI
- 发布时间:2026-08-17 原文地址:
支持作者,持续关注中。
楼主辛苦了,内容很有参考价值。
刚好最近在找这方面的资料,太及时了。
很有价值的分享,感谢整理。
刚好最近在找这方面的资料,太及时了。
楼主辛苦了,内容很有参考价值。
收藏了,以后慢慢研究。
实测过类似工具,作者说的基本属实。