100+ 个客户共用一个语义模型,构建时间缩短 70%
📌 One-Sentence Summary
本文介绍了一种由配置驱动的语义建模方法,通过将共享数据结构与客户专属设置分离,让单一报表模板能够服务 100+ 个客户,同时灵活处理指标、命名和数据可用性,并将构建时间缩短 70%。
📝 Summary
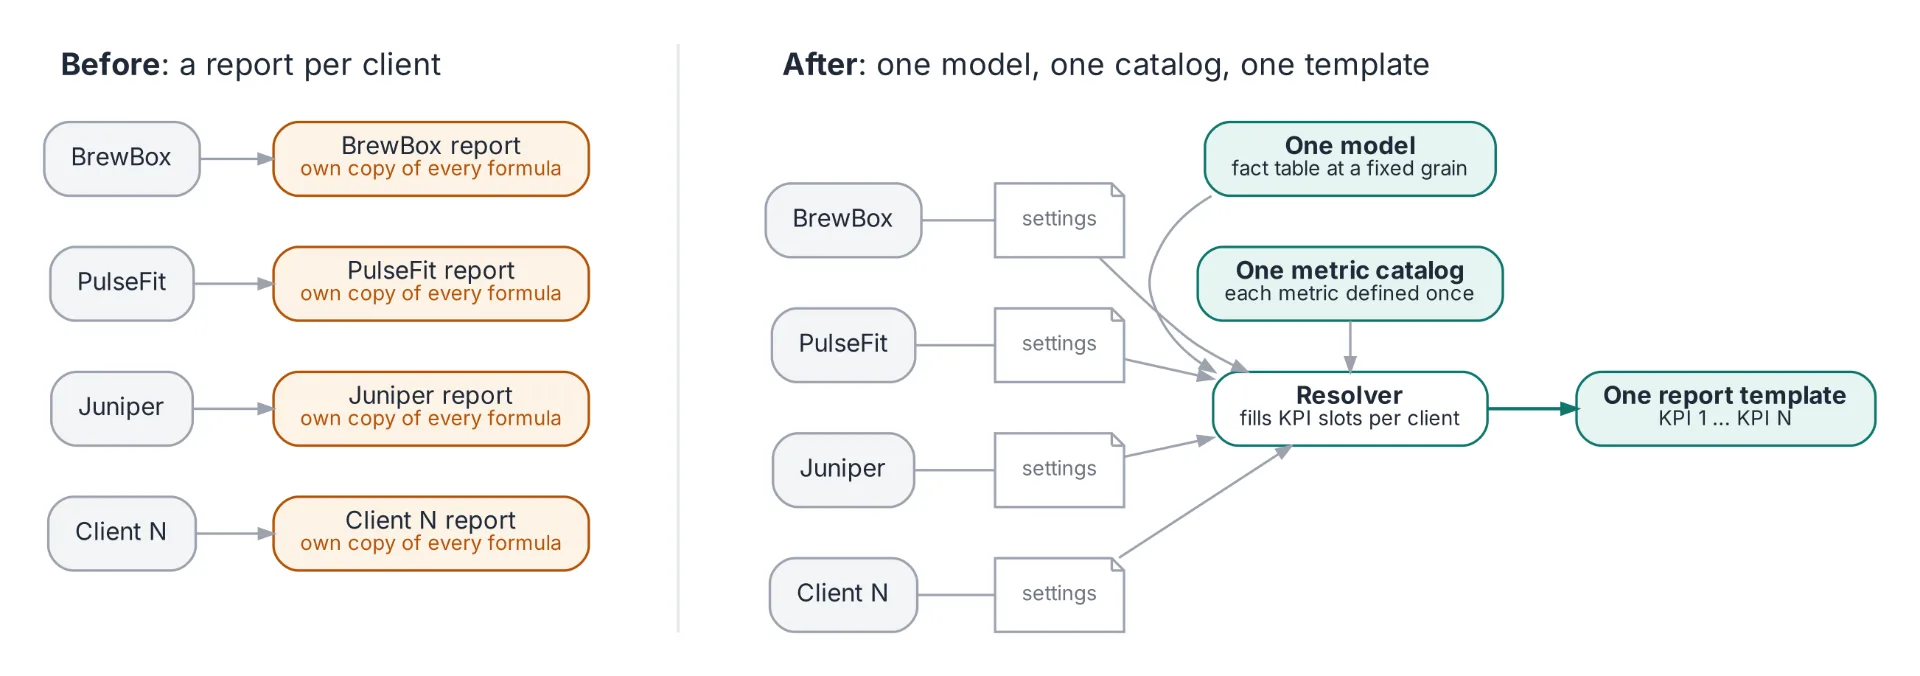
本文介绍了一套可扩展的报告系统,用统一的语义模型取代面向各个客户的多份专属报告。系统的核心包括一张粒度固定、存储可加性度量的事实表;一个集中式指标目录,用于统一定义计算逻辑;以及按客户维护的配置记录,用于指定名称、KPI 选择和数据可用性。主要创新包括将指标定义与标签分离、通过解析器根据客户设置动态组合报告,以及明确声明指标所需的输入,以妥善处理数据缺失。该系统将构建时间缩短了 70%,消除了指标定义偏差,并让任何分析师都能负责任何客户账户。作者建议对配置进行版本控制,并在大规模实施时使用成熟的语义层工具。
💡 Main Points
所有客户共用一个粒度固定的维度模型,客户专属差异通过配置处理,而不是复制报表。
事实表按日存储跨客户、营销活动和渠道的原始可加性度量。各客户在命名、KPI 选择和日历方面的差异通过外部配置记录管理,避免定义偏差,并使分析师能够相互接替工作。
指标定义集中存放在目录中,而客户专属标签和 KPI 选择则通过配置驱动的解析器动态确定。
每个指标只有一个标准定义(例如,CPA = 总支出 / 总转化次数),但可以针对不同客户使用不同名称。解析器根据客户设置选择合适的指标,通过列出「不显示」的原因来处理数据缺失,并且无需更改代码即可组合报告。
比率根据已存储的组成数据计算,而非使用预先计算的列,以确保跨时间周期和维度汇总时结果正确。
系统只存储原始度量(支出、转化次数、收入),并在查询时按总分子 / 总分母计算 CPA 等比率。这样可以避免对每日比率进行错误平均,并确保每周数值与每日汇总结果一致。
明确声明每项指标所需的输入,可妥善处理不同客户的数据可用性差异。
每个指标都会声明其所需输入(例如,转化率需要会话数)。解析器会检查客户的数据可用性,并排除不受支持的指标,同时明确说明「不显示」的原因,从而将数据缺口转化为可执行的数据请求,而不是报错。
该架构将配置视为一种产品,通过验证、责任归属和版本控制实现扩展。
配置记录应纳入版本控制,并保留差异记录和审核流程。系统还可以根据指标目录中的输入要求制定标准化数据接入规范,从而快速引入新客户。
💬 Key Quotes
企业 AI 智能体在生产环境中产生幻觉、遗漏关键依赖项或误解政策时,根本原因几乎总是上下文不足或不够准确。
前沿模型是无状态的线性 token 预测器,具备卓越的推理能力。但它们只能基于所提供的上下文进行推理。
真正的教训非常具体:智能体可以把所有正确的数据都存进记忆,但当某个变量发生变化时,它仍可能无法更新旧结论。记住事实很容易,管理状态变化很难。
与其把整个企业 CMDB 或架构目录都塞进提示词,不如通过拓扑剪枝提取与查询相关的精确子网络,大幅减少 token 消耗。
📊 Article Meta
AI Screening: 91
Featured: Yes
Source: Towards Data Science
Author: VAL YE
Category: 人工智能
Language: 英文
Read Time: 10 min
Word Count: 2433
Tags:
编程与工程 , 数据工程 , 语义层 , AI 基础设施 , AI 智能体
写得挺用心的,支持一下。
支持作者,持续关注中。
不错不错,已加入书签。
点赞,必须点赞
讲解得很细致,新手也能看懂。
看标题就点进来了,内容果然没让人失望。
写得挺用心的,支持一下。
整理得太全面了,省了我不少时间。
支持作者,持续关注中。
看标题就点进来了,内容果然没让人失望。
整理得太全面了,省了我不少时间。
这个比较实用,已转发给同事。